01
@GoogleAIStudio
Google AI Studio 上线 Genie 4(该产品 10 月 28 日已发布),可进入交互式环境并在会话中途改造场景:切换天气、召唤角色,同时实时生成自适应原生音频。即日起通过 Gemini API 和 AI Studio 开放试用。对做分镜预演、互动叙事和场景概念验证的创作者,这是一条能直接上手试的路径。
能走进场景里改天气、召唤角色,还带实时生成的音效,今天就能在 Gemini API 和 AI Studio 里试。做分镜预演和互动叙事的可以上手跑一遍,看它能不能当场景草稿台用。
点击打开原平台查看,能否访问取决于网络环境
02
@ideogram_ai
Ideogram 发布图像模型 4.6,主打精准编辑与原生 4K 输出。官方称真实感和材质细节明显提升,编辑区域之外的像素漂移大幅减少,色彩准确度也更好。对做 KV、海报、概念图的视觉岗来说,改一处不动全身是这次最实用的点。
局部改图不再把周围像素带跑偏,颜色也更准,原生 4K 直出。做 KV、海报和分镜概念图的视觉师可以拿旧图重跑一遍对比。
点击打开原文,能否访问取决于网络环境
03
@haoailab
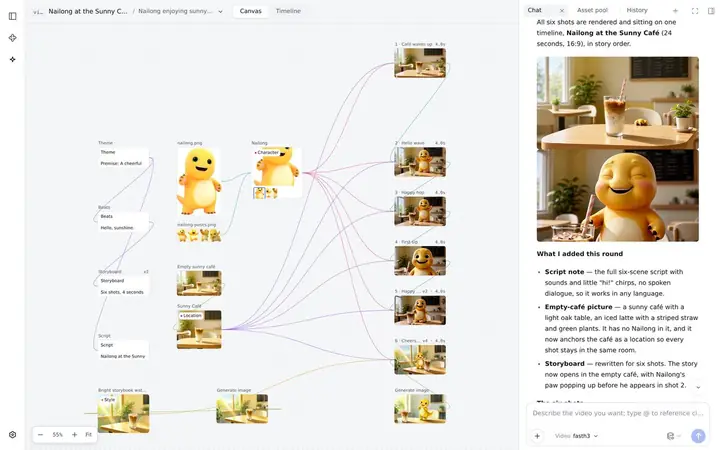
UCSD Hao AI Lab 介绍 FastVideo Dreamverse:为智能体配备电影制作技能和制作流程工具集,可做产品广告或短纪录片。它会写脚本和故事节拍,为每个镜头设计机位角度与动作,过程中逐项与用户确认;素材拍完后可通过对话剪辑场景,或将选中的镜头升级到 2K。
写脚本、分镜节拍、每个镜头的机位和动作都由智能体出方案并逐步跟你确认,拍完还能对话剪场景、把喜欢的镜头升到 2K。做广告片和短纪录片的可以盯一下这套流程。
点击打开原文,能否访问取决于网络环境
04
@alibaba_cloud
阿里云 WonderClip 上线 3D Studio,输入一句描述即可生成 Blender 三维场景,用于摆放角色位置和镜头运动,再以这套预演指导后续视频生成,官方点名适用于短剧和产品视频,限时免费试用。对需要先定机位和走位再出片的编导与视觉团队,等于把分镜预演环节前移到三维空间里做。
一句话出 Blender 三维场景,先把角色走位和机位摆好再拿去生成视频,做短剧和产品片的可以拿它当预演台试一轮。
点击打开原平台查看,能否访问取决于网络环境
05
公众号
火山引擎上线豆包实时音视频通话模型 SeedRealtime 1.0 的 API 服务,把声音、画面、时序与表达统一到同一个全流程模型,支持边看、边听、边说的实时多模态交互,官方称可减少 ASR、VLM、TTS 级联带来的延迟与信息损耗。适合虚拟角色实时对话、AI 主播、互动类内容场景。
声音、画面、时序塞进同一个全流程模型,省掉 ASR+VLM+TTS 三段拼接的延迟。做虚拟角色实时对话、AI 主播、互动短剧的可以接 API 测一轮响应速度。
点击打开原文
06
@higgsfield
Higgsfield 发布 GPU Harness,可在 Claude 和 ChatGPT 中按需租用 GPU,用于渲染、运行开放权重模型和训练 LoRA;支持多个 AI 智能体同时在云端处理专业应用,任意设备可接入。黑五优惠同步上线,GPU 最高 64% 折扣。对需要自己跑 LoRA 训练和批量渲染的团队,等于把算力入口挪进了日常对话工具里。
在 Claude、ChatGPT 里直接租 GPU 跑渲染和 LoRA 训练,多个智能体同时开工,黑五最高 64% 折扣。自己搭流程、要批量出片的技术整合者可以试一轮算成本。
点击打开原平台查看,能否访问取决于网络环境
07
AIHOT 全部动态
Mastra 发布 Mastra Gateway,用一个 API 密钥访问 Anthropic、OpenAI、Typesafe AI 等供应商的 500 多个语言、语音、视频和决策模型,统一一张账单,密钥级别可做权限控制。底层沿用其模型路由(每周跑数十万亿 token),每个模型背后挂多家推理供应商,主线路失败会自动换一家重试。接入方式是在模型 ID 前加 mastra/ 前缀,把 key 写进 .env。
一个 key 打通 Anthropic、OpenAI 等 500 多个语言/语音/视频模型,还带自动切换备用供应商。自己搭生成流程的技术整合者可以接进来省掉多账号多账单的麻烦。
点击打开原文
08
@DomoAI_
DomoAI 上线 InkoAI Agent,主打一键起广告:上传产品照片后,通过对话式交互生成 UGC 风格广告、产品视频或教程类视频。定位是电商/投放素材的快速产出,具体模型、时长与价格未在推文中给出。
上传一张产品图,靠聊天就能出 UGC 广告、产品视频和教程片,做电商投放和带货素材的可以拿自家产品图跑一轮看废片率。
点击打开原平台查看,能否访问取决于网络环境
09
@FishAudio
Fish Audio 官方发文祝贺 @ArtinBogdanov 与 Sun 团队,并称由 Fish Audio 为 Sun 的语音提供支持。原文只交代了这次合作与语音能力归属,做 AI 配音、虚拟角色对话的可以顺着这条线关注后续是否对外开放。
Fish Audio 官方确认给 Sun 团队的产品供语音,做 AI 配音和角色对话的可以留意这条合作后续会不会开放接口。
点击打开原平台查看,能否访问取决于网络环境
01
Luma AI (YouTube)
Luma 官方发布的 AI 影视教程,讲如何在跨镜头、跨场景中保持同一角色可辨识,面向品牌、营销和创作者。流程分三步:生成第一个镜头前先建角色参考;随场景变化优化提示词;处理角色脸型、发型、服装的漂移问题。附带免费的 Prompt Optimizer 和 Three Panel Character Ref Sheet Builder 两个工具,视频含短片开场、背景介绍、三步拆解、工作流自动化与复盘章节。
Luma 官方把角色一致性拆成建参考、调 prompt、修脸发服装三步,还附了免费的提示词优化和角色三视图工具,做系列短片和短剧的可以照着跑一遍。
VIDEO
点击打开原平台查看,能否访问取决于网络环境
02
@magnific
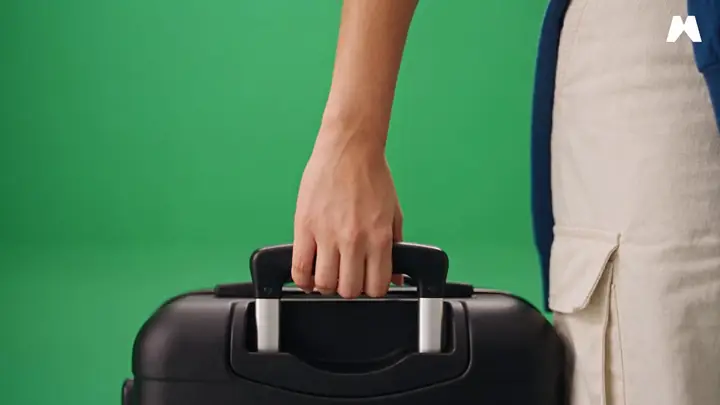
Magnific 官方介绍 Illusion 功能演示(该产品 11 月 18 日已发布):同一段绿幕拍摄素材,人物持续行走、行李箱持续滚动,通过剪辑切换被放进四个不同场景,官方以分步串帖形式展示从最初参考图到最终成片的完整过程。对做后期合成与虚拟制片的创作者来说,这条演示的是绿幕素材跨场景复用的处理方式,可对照自己的抠像与场景匹配流程。
一条绿幕素材换四个目的地,人物动作和行李箱滚动全程连贯,做后期合成的可以看它怎么处理抠像与场景衔接。
点击打开原平台查看,能否访问取决于网络环境
03
Curious Refuge (YouTube)
Curious Refuge 团队实测新 AI 视频生成器 Topview T1,外界称其可能优于 Seedance 2.5。视频按时间码拆成多组对比:口播数字人、人声与音乐、分辨率放大痕迹、苏格兰酒吧场景、Willem Dafoe 测试,并做了音频取证和元数据调查,最终判断 T1 是否为 Seedance 2.5 720p 放大后换皮。
Curious Refuge 拿 Topview T1 和 Seedance 2.5 逐项对打,从分辨率、音频到元数据找「套壳」证据。要选视频模型的团队先看这期再掏钱。
VIDEO
点击打开原平台查看,能否访问取决于网络环境
04
@AravSrinivas
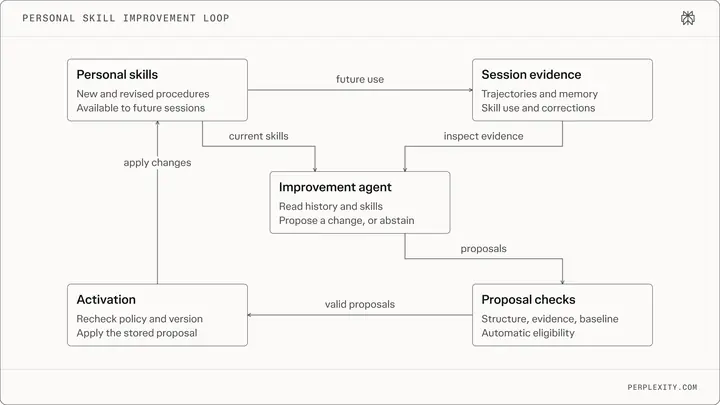
Perplexity CEO Aravind Srinivas 分享 Computer 中 Brain 智能体的自我改进技能研究:Brain 原本维护一份关于你工作的知识 wiki,现在还会根据历史会话自动编写和更新 Agent 技能。改进智能体读取完整会话轨迹(工具调用、推理、结果),找出重复模式,证据足够时才提议新技能或更新;所有用户共用的内置技能在改动上线前要经过失败场景的成对回放和工程师审核。8 周生产流量随机测试中,72.9% 用户至少获得一个新个人技能(手动添加的仅 6.5%),工具调用失败下降 11%,不满意对话下降 7.6%,成本与延迟无可测变化。
Brain 读你过去的会话记录,自己总结出可复用的技能,8 周实测 72.9% 用户自动获得新技能、工具调用失败降 11%。自己搭 Agent 流程的可以看看这套「从历史里长技能」的做法。
点击打开原文,能否访问取决于网络环境
05
@magnific
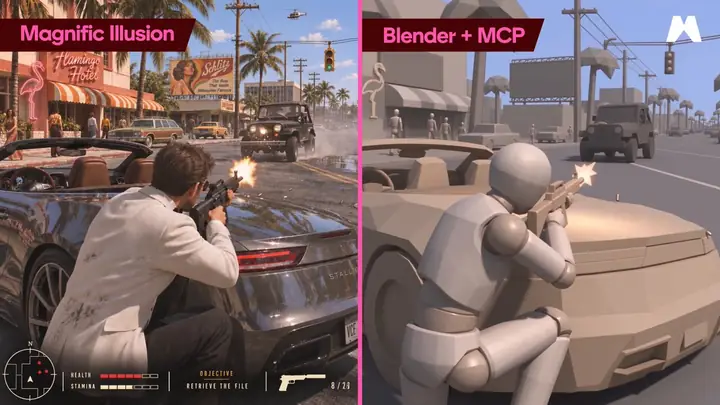
Magnific 官方账号发布一条工作流串推,主题是用 ChatGPT + Blender + Magnific Illusion 把 3D 动线转成游戏风格场景,正文按步骤逐条拆解,并附演示链接。适合做视觉开发、场景概念和分镜预演的创作者参考 3D 打底加 AI 出图的组合方式。
从 Blender 摆 3D 动线到出游戏风成图,Magnific 官方把步骤拆成串推。做视觉开发和分镜预演的可以照着跑一遍,看 3D 打底能不能稳住镜头和风格。
点击打开原平台查看,能否访问取决于网络环境
06
Curious Refuge (YouTube)
Curious Refuge 对比测试字节 Seedance 2.5 Flash 与标准版 Seedance 2.5:Flash 价格低约 34%,但把片段并排看,标准版的物理运动处理明显更自然。他们最终保留的省钱流程是——先用 Seedance 2.5 Draft 模式在 480p 试几条,挑出满意的那条再出 1080p 或 4K。
Seedance 2.5 Flash 比标准版便宜约 34%,但实测物理运动明显不如标准版自然。做短剧的可以照搬他们那套省钱流程:480p Draft 模式先试几条,选中再上 1080p/4K。
VIDEO
点击打开原平台查看,能否访问取决于网络环境
07
OpenAI Developers
OpenAI Developers 发布 GPT-Live 语音智能体指南,从语音选择和 session 指令两方面讲怎么服务跨语言、跨地区受众。建议先测内置语音——Nira 带印地语影响,Bossa 和 Tempo 带巴西葡萄牙语影响,开箱自然度较高;不够再用 prompt-to-voice 按地区精确描述生成合成语音。文中给出印度英语、西班牙中部/北部卡斯蒂利亚语、迪拜阿拉伯语三个示例,并附按语言和地区影响分类的内置语音表。
OpenAI 官方讲怎么给语音智能体挑口音:先试内置的 Nira(印地语)、Bossa/Tempo(巴西葡语),不够再用 prompt-to-voice 按地区描述生成。做 AI 配音、虚拟角色对话、出海短剧的可以照着调一轮。
08
@HeyGen
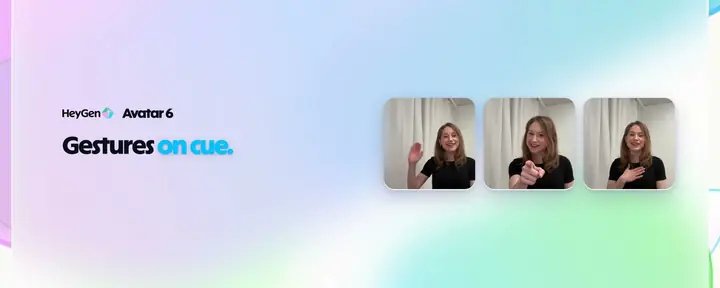
HeyGen 官方发布 Avatar 6 的手势提示词手册(gesture prompting playbook),指导用户通过提示词控制数字人的手势动作。推文本身只给出「完整手册在下方链接」的指引,具体提示词写法与示例需点开原帖查看。做数字人口播、虚拟角色出镜的团队可对照手册调整手势表达。
HeyGen 官方给 Avatar 6 出了套手势提示词手册,做数字人出镜和虚拟角色的可以照着调动作,比瞎试省时间。
点击打开原文,能否访问取决于网络环境
09
@_philschmid
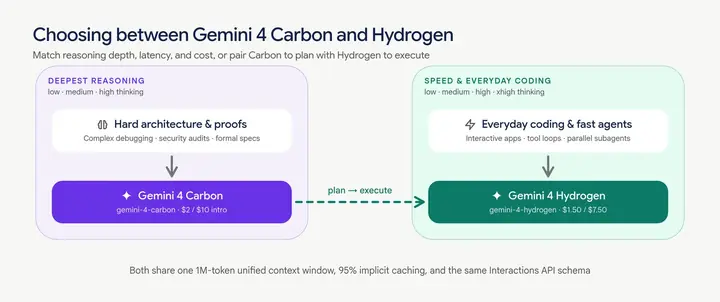
Google DeepMind 的 Philipp Schmid 给出 Gemini 4 两款模型的选型建议:Carbon 面向硬架构设计、调试、科学证明和安全审计,intro 价 $2/$10(至 11 月 30 日);Hydrogen 面向日常编码、交互应用、工具调用智能体和并行子智能体,$1.50/$7.50 per 1M。两者可搭配使用,Carbon 负责规划调度、Hydrogen 负责执行,共享 1M-token 上下文窗口、95% implicit caching 和相同的 Interactions API schema。
Carbon 管硬架构和调试、Hydrogen 管日常编码和工具调用智能体,还能一个规划一个执行搭着用。自己搭自动化流程的技术整合者可以照着这份分工表配模型,省点 token 钱。
点击打开原文,能否访问取决于网络环境
10
@wc8880
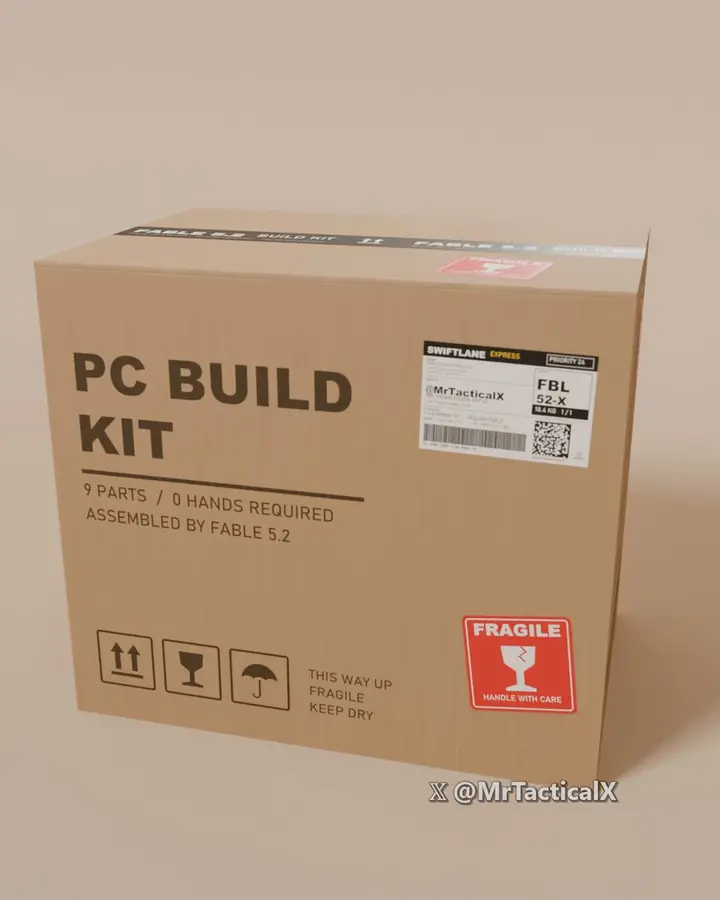
作者用 3 个基于 Fable 5.2 的 Agent 完成一套电脑主机组装演示,耗时 7 小时 41 分钟,花费 138.82 美元,评价画面精致、细节质感到位、装机过程看着解压。属于个人使用体验分享。
个人体验分享:3 个 Fable 5.2 Agent 跑 7 小时 41 分、花 138.82 美元做出一套装机演示,画面质感和细节被作者认可。想试多 Agent 分工做演示片的可以看看这个成本量级。
点击打开原平台查看,能否访问取决于网络环境