01
@GoogleDeepMind
Google DeepMind 发布 Gemini 4 Neon,在 Artificial Analysis 智能指数 xhigh 思考级别下以 61 分排名第三,即日起开放使用。可用渠道包括 Google AI Studio 的 Gemini API、Android Studio、Gemini for business;Gemini app 面向 Google AI Pro 和 Ultra 订阅用户,Antigravity 面向付费订阅用户,符合条件的 Fairwind Program 成员即将可用。
Gemini 4 Neon 在 Artificial Analysis 智能指数 xhigh 档拿 61 分排第三,即日起 API、Android Studio、Gemini app 全开。做 Agent 和自动化流程的可以接 API 跑一轮,看它在多步任务上稳不稳。
点击打开原文,能否访问取决于网络环境
02
@GoogleAI
Google AI 上线全新 Project Genie 体验,核心是 Genie 4 世界模型(该产品 10 月 28 日已发布):支持实时编辑(打字改天气、插入角色、临场改动作走向)和原生音频。同时推出 Project Genie agent,用自然语言对话生成世界,由 agent 调度多模态模型做画面与氛围,Gemini 充当带上下文建议的副驾。另有社区画廊可发布与 remix 世界,首发合作含 Villa Giallo、The Life of Ants。Genie 3 同步升级:单次会话延长至 3 分钟、支持世界串联、360 度全景图 grounding。现面向符合条件的 Google AI Ultra 订阅者开放,Pro 用户可排队。
Genie 4 能边跑边改天气、加角色、改剧情走向,还带原生音频,做互动叙事和虚拟场景预演的可以盯一下这套实时世界模型。
点击打开原平台查看,能否访问取决于网络环境
03
@pika_labs
Pika 发布 Enact 研究预览版,基于 Pika H3 Flex 构建,定位是模仿片场导演体验的 AI 视频制作方式。创作者可与「演员」互动、手动重新布置场景、实时操控摄像机,官方称这是创作新范式的起点,需联系申请 demo。
Pika 把「片场导演」搬进 AI 视频:能跟演员互动、手动重摆场景、实时推镜头。做分镜和镜头调度的编导可以申请 demo 试手感。
点击打开原平台查看,能否访问取决于网络环境
04
@Google
Google 发布 Neon 模型,提供四级思考档位,可按任务匹配推理深度;官方称在高档位下 Vals 指数与 Agent Arena 均处帕累托前沿,单任务成本比顶尖竞争前沿模型低约 50% 至 80%。科学和数学基准上表现同类最佳,演示中用 /swarm 调取档案照片,重现图灵 1936 年在剑桥国王学院的研究场景。
四级推理档位可按任务调深度,成本比同级前沿模型低 50%-80%,做 AI 研究助理和知识可视化的可以接 API 试。拍片的人这条先放着。
05
@fal
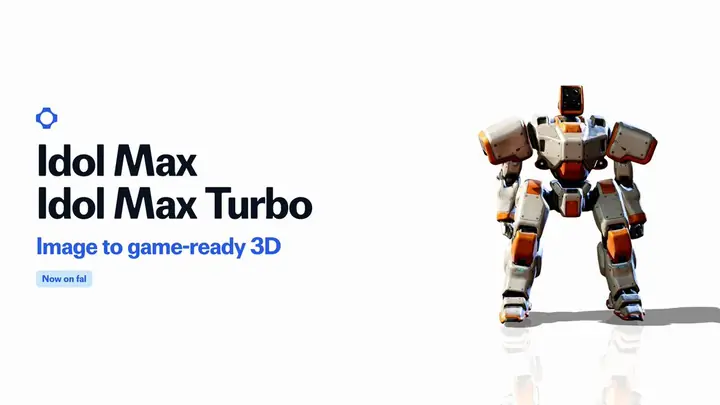
fal 与 speridlabs 合作后训练其 Idol 模型,推出自建优化的 Idol Max 与 Idol Max Turbo 图像转 3D 模型。单张图片输入即可生成游戏可用的 3D 资产,输出为带 UV 和 2K 纹理的真实 GLB 网格而非 Gaussian splat,可选 PBR 材质与自动绑定。
单张图出带 UV 和 2K 纹理的 GLB 网格,还能选 PBR 材质和自动绑定,做游戏资产和三维场景的可以接 API 试一批。
点击打开原平台查看,能否访问取决于网络环境
06
@rohanpaul_ai
阿姆斯特丹创业公司 Reson8 发布语音转文字模型 Rumble-2-Flash,0.5B 参数、1GB 体积,覆盖 45 种语言,Apache 2.0 开放权重,官方称效果胜过体积 20 倍的模型。针对重口音、多人重叠说话、糟糕电话线路和街道噪音等难处理音频,可在手机本地离线转录通话与语音备忘录,无需联网。
0.5B 参数、1GB 大小、45 种语言、Apache 2.0 开放权重,主打重口音、人声重叠、烂电话线和街头噪音。做后期字幕和短剧批量转写的可以下下来跑一遍,看它在嘈杂素材上比现有工具强多少。
07
@rohanpaul_ai
Arcade 推出 3.0 版 AI 视频工具,面向营销团队:输入一句话并回答两个问题,即可生成含配音、字幕、音乐和品牌元素的成品发布视频。成片支持点击某个元素单独修改,其余画面保持不变。公司称盲测中 B2B 营销人员选择其视频的频率是 Claude Opus 5.5 和 Gemini Argon 生成视频的 2 倍。Arcade 此前以可点击产品演示著称,客户包括 OpenAI 和 Salesforce。
一句话加两个问题就出带配音、字幕、音乐和品牌元素的成品发布视频,改片时点中某个元素单独改、其余画面不动——做营销物料和产品发布片的团队可以拿它跑一版对比现有流程。
点击打开原平台查看,能否访问取决于网络环境
01
Recraft AI Blog
字节 Seedream 5.5 已在 Recraft Studio 上线,Recraft 官方用 12 条提示词把它与自家 Recraft V4.1 Pro、GPT Image 2.6 做了同题对比测试。内容为横向实测,覆盖同一批提示词下三个模型的出图差异,适合判断 Seedream 5.5 在具体题材上的表现。
字节 Seedream 5.5 进了 Recraft Studio,官方拿 12 条提示词跟 Recraft V4.1 Pro、GPT Image 2.6 同题跑了一遍。做视觉开发和 KV 的可以照着这组对比看风格还原和文字排版差在哪。
02
@poteto
Grok Bot 工程负责人 Lauren Tan 发教程,讲非技术用户怎么用 Grok Bot 自动化电脑上能完成的任务。她的方法是先分清目标和流程:用英文描述最终想要的结果,再语音口述平时怎么做、用什么工具、信息从哪来、怎么算做完,让 bot 复述一遍确认后再执行。
讲的是把目标说清楚再让 bot 复述确认这套沟通方法,做素材整理、批量转写、发布排期这类杂活的团队可以照着改自己的说法。
点击打开原文,能否访问取决于网络环境
03
@leaf_sanren
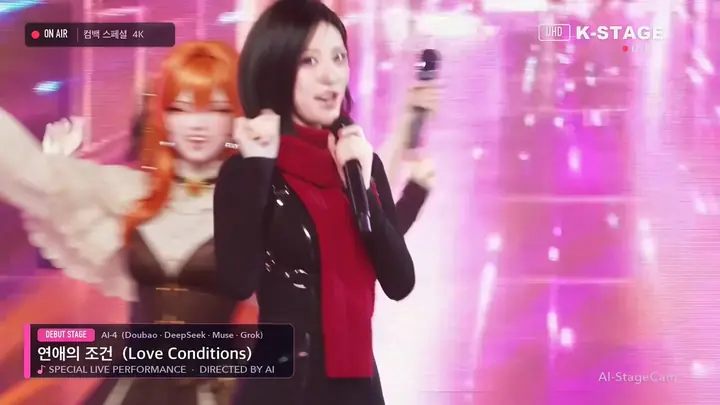
作者 @leaf_sanren 称用 Antigravity 直出近期流行的韩国女团打歌视频,全程在 Google AI Pro 权益内免费生成。做法是用 Gemini 4 理解原视频、反推提示词再生成视频,串成一个循环并指定输出文件路径;不喜欢 omni 模型的也可接入小云雀、即梦等 CLI。
作者把「Gemini 4 看视频反推提示词 → 生成视频 → 指定输出路径」串成一个循环,还提到可换接小云雀、即梦的 CLI。想搭批量出片流程的技术整合者可以照着试。
点击打开原平台查看,能否访问取决于网络环境
04
@aiwarts
作者把 Token 羊毛监控站从语言/编程、音频两类扩到四类,新增图像生成与视频生成,每条标注可用模型、领取方式、刷新周期和折算价值。图像视频额度存在单位混乱、免费边界模糊、额度变动频繁三个难点,巡查频率从每天两次提到三次。文中另附全息卡牌、ASCII 字符海洋、CSS 3D 透视三种视觉改造提示语,核心是限定只改渲染层、不动数据接口和交互逻辑。
把各家图像、视频模型的免费额度按模型、领取方式、刷新周期、折算价值列成一张表,每天巡查三次。想白嫖算力试片的团队可以收藏当清单用。
点击打开原文,能否访问取决于网络环境
05
@HamidoFx1
开发者 Hamido Teck 用一句提示词让 GPT 6.2 Astra 基于真实 OpenStreetMap 数据生成新加坡唐人街的交互式 3D 网页应用,一次输出包含 1500 多栋拉伸建筑、红顶店屋、紫色地铁线、天气粒子效果和半透明界面。OpenAI Developers 转发了这条演示。
一条提示词让模型接上真实 OpenStreetMap 数据,一次跑出 1500 多栋建筑、红顶店屋和天气粒子。做虚拟场景预演和分镜空间参考的可以看看它能到什么程度。