01
@GoogleAI
Google DeepMind 发布世界模型 Genie 4,称其为最逼真、可交互的世界模型。用户可用自然语言实时控制世界与音景,例如改变天气、移动镜头、向环境添加新元素;Gemini 充当模拟的「大脑」,负责把请求转成动作、规划复杂事件并随剧情调整。模型新增环境音,以及可实时适应的互动人物对话能力。
自然语言实时改天气、移镜头、加元素,还带环境音和能对话的互动人物,做分镜预演和互动叙事的可以盯一下实际可玩性。
点击打开原平台查看,能否访问取决于网络环境
02
@FishAudio
Fish Audio 发布实时 STT 预览版,主打「理解对话而不只是转写单词」,能判断何时回答、何时继续、何时停止,面向语音 Agent 场景。在 Cekura 的 STT 基准测试中位列 20 个模型第一,整体词错率 2.21%,现已开放试用。
实时语音转文字,能判断对话里什么时候该接话、什么时候该停,Cekura 基准 20 个模型里排第一。做 AI 配音、虚拟角色对话和自动字幕的可以接 API 试一轮。
点击打开原平台查看,能否访问取决于网络环境
03
@davnov134
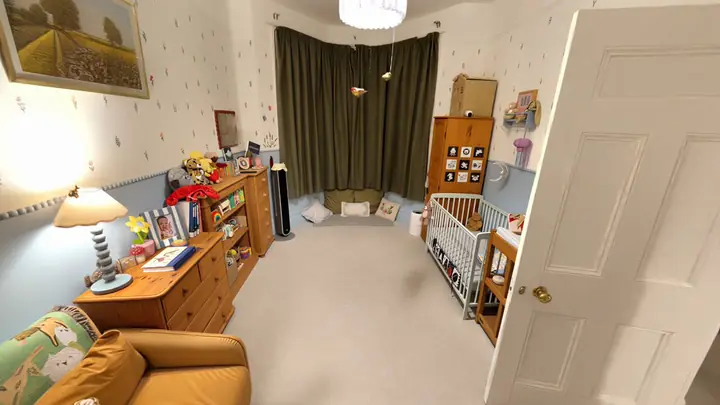
David Novotny 发布 Echo-3 世界模型,主打对真实空间的高精度重建。演示中从一段女儿房间的手机视频生成 3DGS 模型,并把整栋房子重新风格化为她喜欢的童话主题,官方已提供 App 下载试用。对视觉开发和场景预演来说,值得关注的是手机视频直接转 3DGS 这条路径,以及重建后整体换风格的处理方式。
拿一段手机随手拍的房间视频就能重建出 3DGS 场景,还能整体换成童话风格——做美术和场景预演的可以下载 App 试一下重建精度。
点击打开原平台查看,能否访问取决于网络环境
04
OpenAI Blog
OpenAI 与 Oracle 扩大合作,把 Oracle 的企业业务应用和 AI 智能体接入 ChatGPT,同时为 Oracle 的新产品提供模型能力。属于企业级软件生态层面的合作,面向的是企业办公与业务流程场景。
企业软件生态合作,跟拍片和做短剧的日常没关系,工具党路过即可。
05
@MiniMax_AI
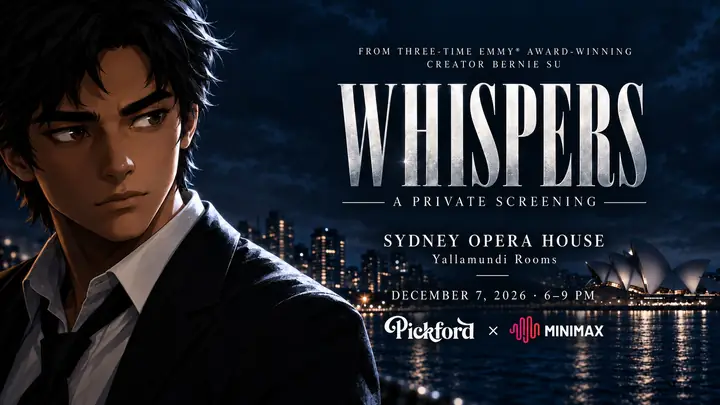
MiniMax 与 Pickford AI 合作,在 NeurIPS 2026 期间把作品《Whispers》带到悉尼歌剧院,12 月 7 日私人放映。官方描述这是一部会根据观众反应自我改写、重新动画化的电影。互动叙事、现场影像装置方向的编导可关注其观众反馈如何接入生成流程。
「会根据观众反应自我改写、重新动画化」的电影,NeurIPS 期间在悉尼歌剧院做私人放映。做互动叙事和现场影像的编导可以盯一下它到底怎么感知观众、怎么触发重生成。
点击打开原文,能否访问取决于网络环境
06
@arena
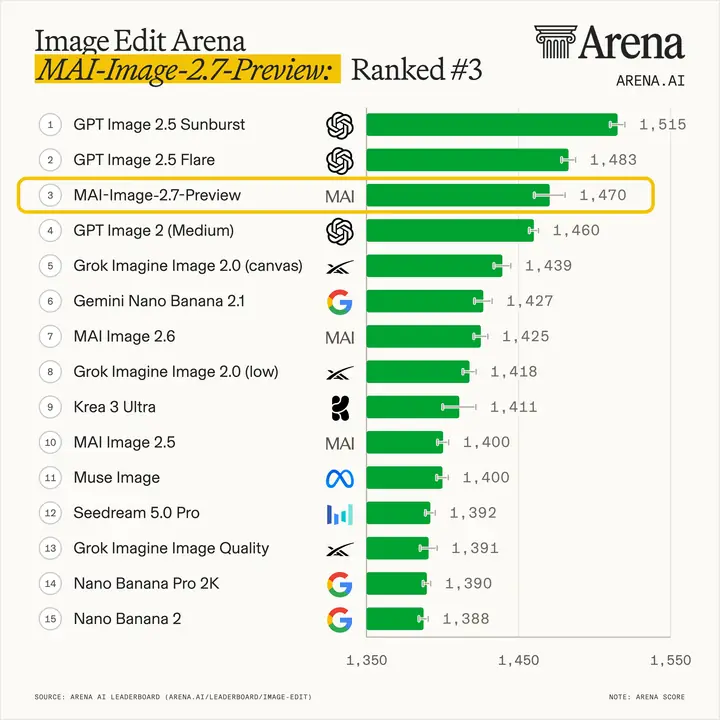
Arena 公布 Image Edit Arena 榜单:微软 MAI-Image-2.7-Preview 以 1470 分位列总榜第 3,Microsoft AI 在实验室排名升至第 2。相比此前第 7 的 MAI-Image-2.6 提升 45 分,全部类别均有进步——产品与品牌设计、人像、写实电影感图像升至第 3,文字渲染与卡通动漫升至第 4,3D 成像与建模升至第 5。
Image Edit Arena 1470 分排第三,比 2.6 涨 45 分,人像和写实电影感两类都进前三。做视觉开发和 KV 的可以拿它跟手上模型对一轮图,看修图手感差多少。
点击打开原文,能否访问取决于网络环境
07
@ArtificialAnlys
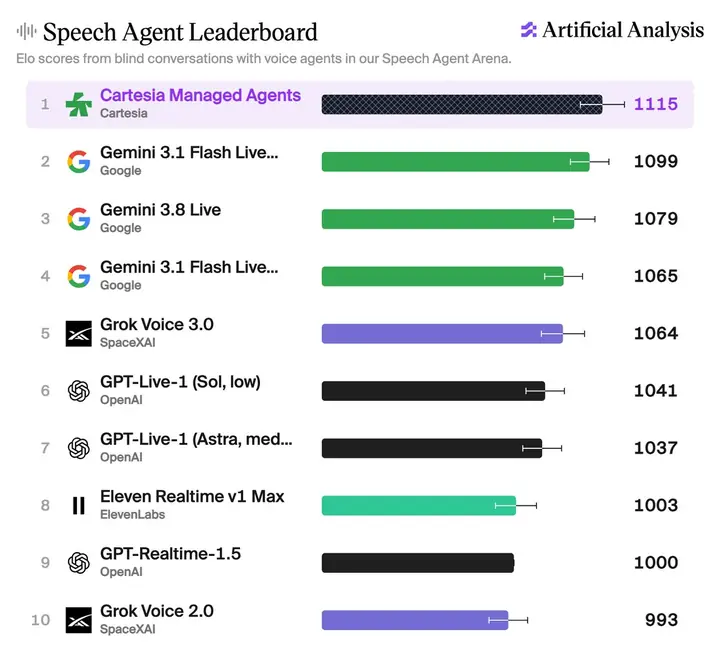
Artificial Analysis 公布 Cartesia Managed Agents 在 Speech Agent Arena 的成绩:Elo 1115(95% 置信区间 1086-1144,685 个样本),比 Cartesia 上一代语音智能体产品 Line 的 1017 高 98 分;需要工具调用的任务上 Elo 1112,任务成功率从 77.5% 升到 91.7%。该平台是串联式架构,Cartesia 自家的 Ink 语音转写和 Sonic 语音合成模型围绕开发者自选的 LLM 运行,本次评测用 GPT-5.5 加 Skylar、Daniel 两个音色。
语音智能体这块的评测数据出来了:Elo 1115,比自家上一代 Line 高 98 分,工具调用任务成功率 91.7%。做 AI 配音、虚拟角色对话、语音客服的可以看下这套串联方案(Ink 转写 + Sonic 合成 + 自选 LLM)值不值得接。
点击打开原平台查看,能否访问取决于网络环境
08
@rohanpaul_ai
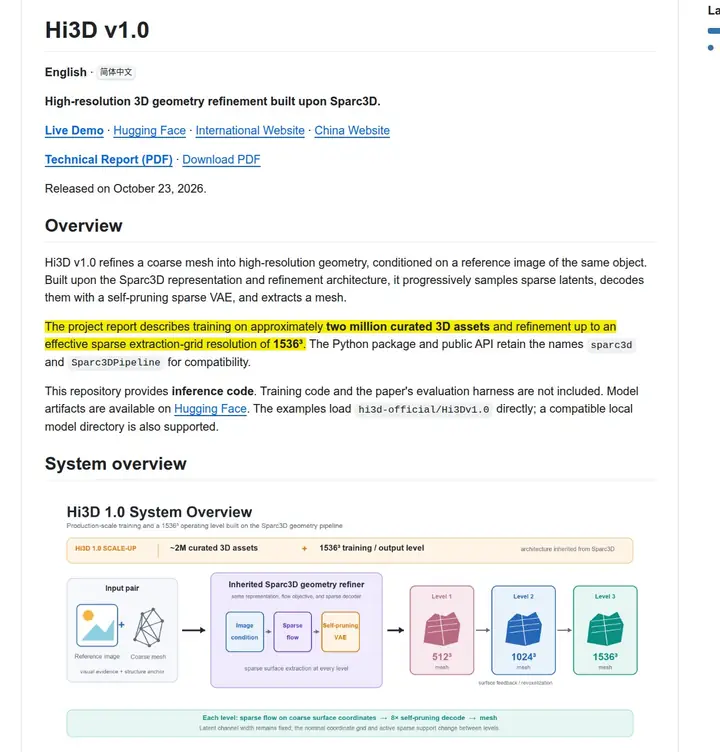
Hi3D 开源 image-to-3D 模型 Hi3D v1.0(前身 Sparc3D),代码与权重已在 GitHub 和 Hugging Face 发布,可免费商用(上限 20 万月活或 100 万美元月收入)。输入一张图加一个粗网格草稿,分 512、1024、1536 三轮稀疏体素细化,每轮把表面重建到 8 倍精度并剔除空体素;训练数据从 50 万涨到约 200 万精选 3D 资产。主打背面、底面和翅膀、犄角、把手这类薄结构不塌。
图生 3D 的老毛病是正面好看、背面糊成一团,这个模型靠粗网格加三轮细化把侧面和薄片结构补上,代码权重都放出来了。做美术资产和场景搭建的可以拉下来跑几个道具试试。
点击打开原文,能否访问取决于网络环境
09
@AnatoliKopadze
Hi3D 发布开源模型,可将照片中的任意物体转成完整 3D 模型,训练数据为 200 万个 3D 资产,技术报告中 90% 的生成模型通过 3D 打印切片测试。发帖人给出的用法是先用照片生成底模,再用 Opus 5.5 精修细节。对做视觉开发和场景资产的人来说,单图出可打印级网格意味着前期建模成本大幅下降。
照片直接出完整 3D 模型,200 万资产训练、九成过 3D 打印切片测试,做美术资产和场景搭建的可以拿它先出底模再手工修。
点击打开原平台查看,能否访问取决于网络环境
10
@reach_vb
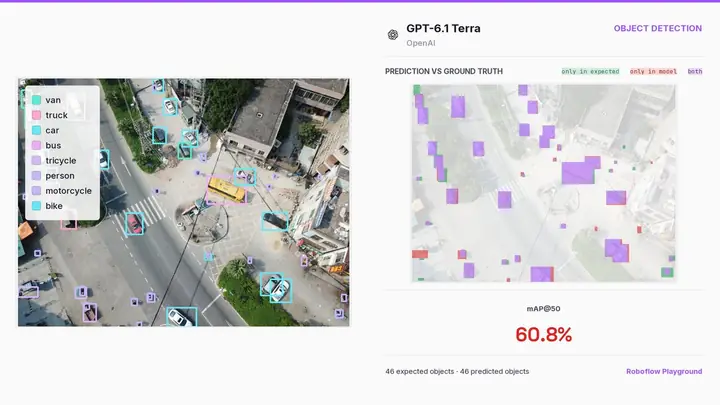
OpenAI 的 Vaibhav Srivastav 引用 Roboflow 视觉基准结果称,GPT-6.1 Terra 在文本、目标检测、计数等视觉任务上胜过 Astra,速度约快 47%、成本约便宜 92%,并附排行榜与示例,图中目标检测 mAP@50 为 60.8%。这是识别类任务的跑分对比,不涉及图像或视频生成。
目标检测、计数这类视觉识别任务的跑分对比,mAP@50 60.8%,跟拍片出图不是一回事,做创作的可以略过。该产品的发布我们已在 2026-09-30 报过,这条是官方对已有能力的介绍,不是新上线。
点击打开原文,能否访问取决于网络环境
01
@servasyy_ai
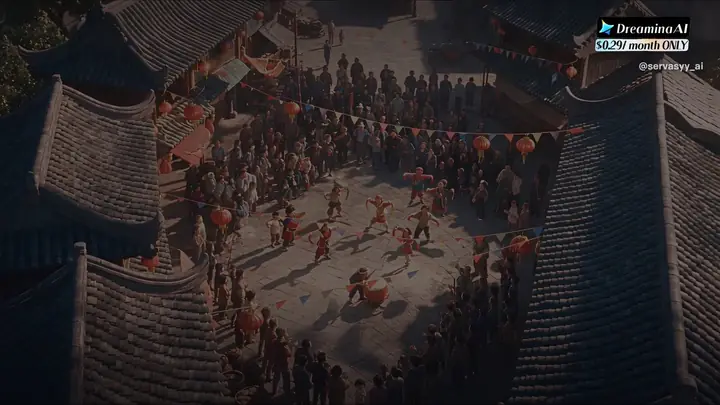
作者用新版 Dreamina(即梦)画布做了一条 80 秒动画短片:先写主角描述存成主体、用三视图补侧面背面,每个镜头引用同一主体保证一致性;连续分镜图出四格九格、宫格切分后每格接一个视频节点,用 Seedance 2.5 生成 8-10 秒片段,十条视频加配乐拖进时间线直接导出。成本上,8 秒镜头直接出 1080P 要 512 积分,先 720P 再智能超清到 4K 共 248 积分。画布带 CLI,作者让 Claude Code 把整条流程写成脚本,只留「主角是谁」一个参数,每批生成前先报价、超上限就停。换成企鹅后 14 张图、10 条视频、1 段配乐自动跑完,共 1750 积分。
把「换主角」从重做一遍变成改一个参数,14 张图 10 条视频 1 段配乐全自动跑完,还带报价上限防超支。做账号矩阵和系列短剧的,这套流程值得照着搭一遍。
点击打开原平台查看,能否访问取决于网络环境
02
公众号
火山引擎官方复盘《不问凡尘》:约20人团队9个月上线,Steam 好评率87%、超26万玩家,成本约为传统制作的1/3。核心资产由 Seedance 2.0/2.5 生成视频、Seedream 5.0 Pro 生成图像、Seed TTS 结合 Seed Character 生成语音;项目组用状态机连接图层与玩家输入实现交互,并借助 TRAE 与 Agent 工作流搭建自动化生产流程。
20人9个月、成本压到传统制作的三分之一,Seedance 2.0/2.5 出视频、Seedream 5.0 Pro 出图、Seed TTS 配音,还搭了自动化生产流程。做互动影像和短剧的制片可以拆它的成本结构。
03
公众号
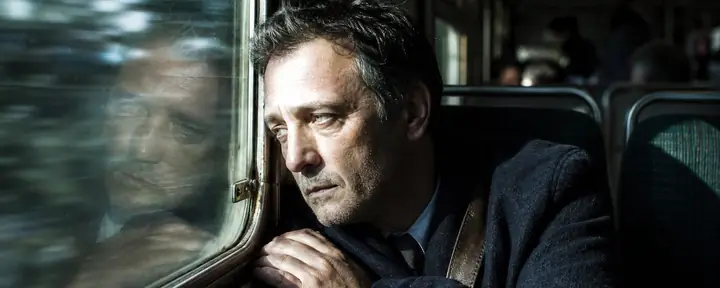
可灵AI 公众号披露 AI 短片《King Card》幕后,该片海内外播放超 500 万,用 Kling 4.0 完成卡牌矩阵、报纸列车穿城、折纸鸟与章鱼打斗等奇观场面。Kling 4.0 支持最多 10 张关键帧输入,动态与运镜能力升级,可稳定呈现高速运动和大幅镜头运动。
官方拆解《King Card》的卡牌矩阵、报纸列车穿城、折纸鸟打章鱼几场戏,顺带讲了 Kling 4.0 最多 10 张关键帧怎么用。做视觉和分镜的可以看它怎么把高速运动和大运镜稳住。
点击打开原文,能否访问取决于网络环境
04
Luma AI Blog
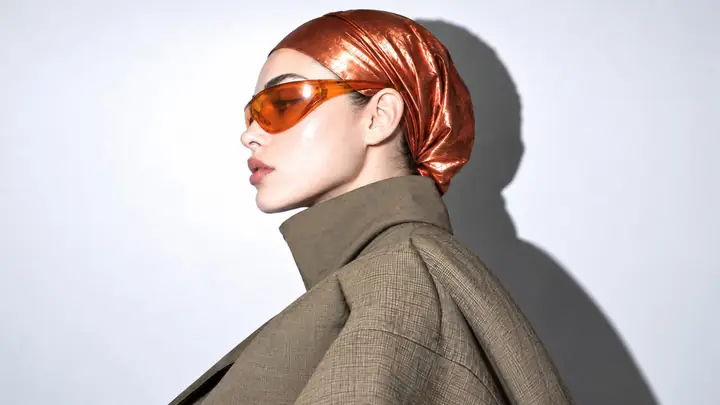
Luma AI 官方博客发布机位提示词指南,整理 30 种镜头角度与景别,每种配可直接复制的 prompt。文中指出不给机位指令时 AI 模型默认输出正面全身构图,并说明低角度适合英雄时刻与产品亮相、高角度制造脆弱感、平视建立平等、荷兰角传递紧张。另提到可从单张参考图批量生成多角度画面,用于加速分镜开发。
30 个机位角度配可复制 prompt,低角度、荷兰角各自对应什么情绪都写清了。编导和视觉师可以存下来当分镜词库,改客户要的视角不用重做素材。
点击打开原文
05
Luma AI Blog
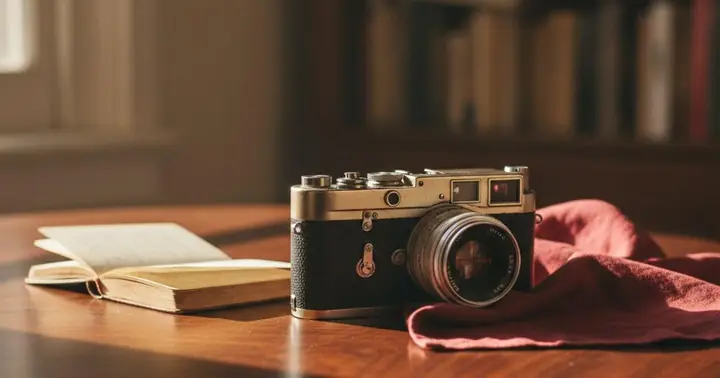
Luma AI 官方博文讲 AI 产品植入:从现有产品照片直接生成生活场景图,保留包装、标签、尺寸等产品准确性,省掉搭棚、约模特、等天气。文中给出三种做法——提示词探索用于找方向、固定场景用于保持一致性、可复用系统用于目录级批量。并引用数据称带视频的产品页转化率比纯静态图最高高 80%。
Luma 官方拆了三种做法:提示词探索、固定场景保一致、可复用系统跑目录批量。接商拍和电商物料的制片、视觉可以看这套流程怎么串。
点击打开原文
06
Luma AI Blog
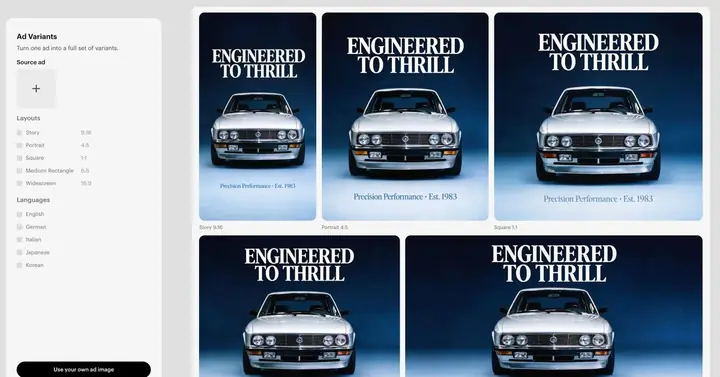
Luma AI 官方博客讲从一张已定稿主图批量产出 50 个广告变体的做法:6 个 Meta 钩子、4 个 TikTok 画幅比例、3 个市场本地化版本、十余个文案角度。文中数据:月产 15 个以上变体的投放 ROAS 高 23%,只有 6-7% 的变体能成为放量赢家,因此产量是测试前提;靠精准局部编辑保留已审定的版式、只改单个元素,避免整图重生成,整套变体流程耗时 3.5-5 小时,人工制作需 15-20 小时。
一张定稿主图拆出 50 个投放版本,文中给了 23% ROAS 提升和 3.5-5 小时对 15-20 小时的人工对比,做品牌投放和电商物料的可以拿去算账。
点击打开原文
07
LangChain
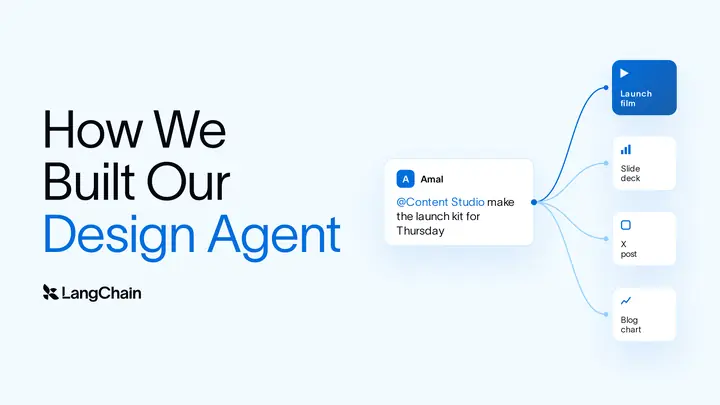
LangChain 详解自研设计 agent Content Studio:在 Slack 里一条提示即可生成视频、幻灯片、社媒图和复刻 UI 图,所有产出以代码形式落地,累计产出超 3000 件资产、80 多套幻灯片,单次请求模型成本从约 8 美元降至约 50 美分。每个 Slack 线程配独立沙箱保存项目状态,agent 可跨视频引擎、图像工具和共享画布工作并自检渲染结果;长任务跑在异步子 agent 上,线程内展示计划、实时进度和发布前审批,团队可中途接管。开源仓库含完整 harness,Managed Deep Agents 可部署到团队 Slack。
一条 Slack 提示出视频、幻灯片和社媒图,单次成本从 8 美元压到 50 美分,还开源了整套框架。做批量物料和短剧宣发的技术整合者可以扒下来改。
点击打开原文
08
@TanLuAI
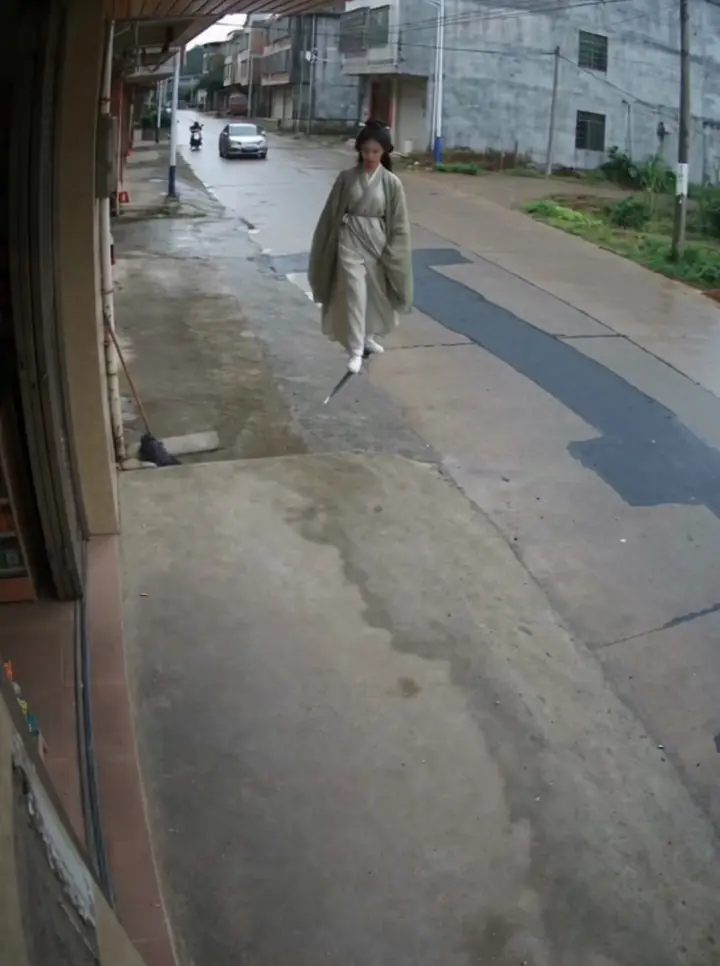
探路AI 公开一段 12 秒、3:4 竖屏、固定监控俯拍、一镜到底的写实视频完整提示词:中国南方小镇小卖部门口,安防摄像头偶然拍下飞剑失控事件,明确要求无电影机位、无切镜、无推拉跟拍特写,并详细规定了摄像头安装位置、店门朝向与墙体遮挡关系。作者称已出现多个几千赞的复刻版本,欢迎魔改。
固定监控俯拍、一镜到底、无切镜无推拉,这套提示词把「伪纪录片式意外」的镜头约束写得很死,做 AI 短剧和搞笑日常的可以照着改一版。
点击打开原平台查看,能否访问取决于网络环境
09
@imagine
Grok Imagine 官方账号宣布提示指南(Prompting Guide)上线,同时说明团队正与一小群创意人员公开制作《奥德赛》剧集,指南内容来自他们的实际工作流程,以 X 长文形式发布。对做 AI 剧集和系列化内容的创作者来说,这是一份官方口径的提示写法参考,可对照自己的分镜与角色一致性流程。
Grok Imagine 官方把《奥德赛》剧集的提示词工作流公开成指南,做 AI 剧集和长叙事的可以照着跑一遍,看它怎么拆镜头和控角色。
点击打开原文,能否访问取决于网络环境
10
OpenAI Blog
OpenAI 官博介绍了 Retell 的客户案例:Retell 用 OpenAI 模型支撑每月 1 亿通电话的语音 Agent 业务,GPT-6 Astra 在其自建的语音 Agent benchmark 上排名第一(该产品 9 月 4 日已发布),同时 Codex 帮助团队把人均年化营收做到 160 万美元。案例给出的是语音 Agent 规模化运营与团队效率的量级参考,不是创作方法论。
OpenAI 官博的客户故事:Retell 的语音 Agent 在自家 benchmark 上把 GPT-6 Astra 排到第一,人均年化营收 160 万美元。做 AI 配音、虚拟角色对话和电话客服的可以看它怎么把语音模型接进业务。