01
@fal
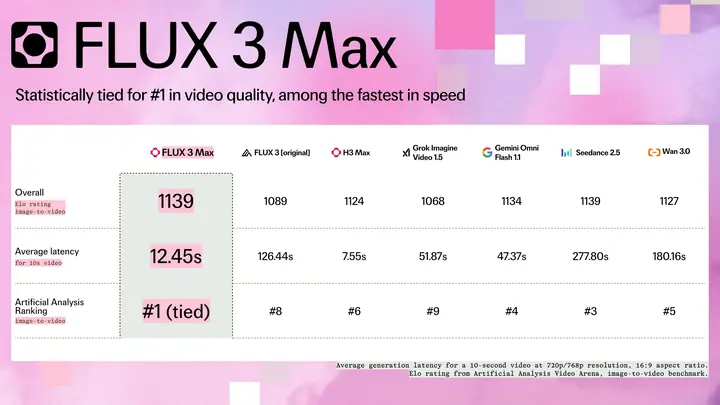
fal 介绍与 bfl_ai 合作训练的后训练视频模型 FLUX 3 Max(该产品 10 月 20 日已发布),生成 10 秒 720/768p 视频耗时 12.45 秒,Seedance 2.5 同任务需 277.8 秒;两者在第三方评测中 Elo 均为 1139,该模型在第三方图生视频质量榜并列第一,未来三周降价 75%。
10 秒 720/768p 视频 12.45 秒出,对比 Seedance 2.5 的 277.8 秒,第三方图生视频榜并列第一,未来三周还降价 75%。做短剧批量出片的这周就该接 API 实测废片率和一致性。
点击打开原文,能否访问取决于网络环境
02
@rohanpaul_ai
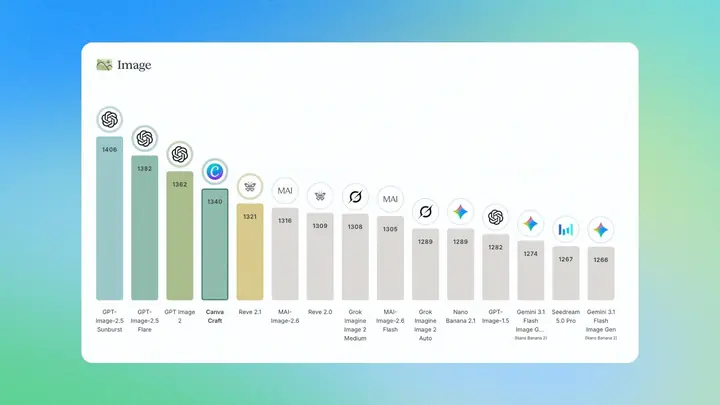
Canva 发布首个自研前沿图像生成模型 Canva Craft,在 DesignArena 全球图像生成榜单排名第二,仅次于 OpenAI。模型采用两阶段架构:规划器先读提示词生成构图方案,渲染器再按方案出图,最高 2K 分辨率、支持超过 30 种宽高比;文字拼写在渲染前已确定,修改单个元素不影响其他元素。
两阶段架构先定构图再渲染,改单个元素不牵动其他部分,做 KV、海报和分镜图的视觉师可以拿它跟现有模型对比出图稳定性。
点击打开原文,能否访问取决于网络环境
03
@testingcatalog
Ideogram 发布首个矢量模型 Vector 1.0,可由文本提示生成带平滑渐变和清晰排版的干净可编辑 SVG,也能把任意图像转为可缩放的详细矢量。生成的 SVG 各组件为独立图层,用户可旋转和移动,目前已上线 Ideogram 及其 API。
做 Logo、KV、片头字效和分镜图标的视觉师可以试:生成的 SVG 每个组件是独立图层,能单独旋转移动,还能把现有图片直接转成可缩放矢量。
点击打开原平台查看,能否访问取决于网络环境
04
@ClaudeDevs
Anthropic 宣布把 Agent Skills 开放标准捐赠给 Agentic AI Foundation,此前 MCP 也捐给了同一基金会。自 2025 年 12 月以来已有 70 多个智能体平台接入该标准,包括 ChatGPT、Cursor、GitHub Copilot 和 VS Code。
Agent Skills 和 MCP 归到同一家基金会管,70 多个平台已接入。自己搭 AI 工作流的技术整合者可以留意标准走向,纯拍片的编导这条可以先放。
点击打开原文
05
AIHOT 全部动态
科大讯飞在 1024 开发者节首发星火语音基座大模型 SparkAudio 1.0,集成机器翻译、语音识别、语义理解等能力,官方称在实时说话人分离、环境理解、音频理解、情绪识别方面表现突出,支持中英文任意切换。对配音、虚拟角色对白、多语种短剧后期来说,说话人分离和情绪识别是能直接落到工作流里的两个点。
语音基座把翻译、识别、语义理解、情绪识别打包在一起,中英文可任意切换。做 AI 配音、虚拟角色对白和短剧后期声音的,可以盯一下它的情绪识别和说话人分离实测。
06
Ars Technica
Ars Technica 报道,PHP2Shell 漏洞在被披露前四天已遭黑客利用,由 Calif 与 Wiz 的研究人员发现。OpenAI 称其前沿 AI 在攻击者之前发现了漏洞,并与 PHP、Calif、Wiz 合作验证并开发补丁。英国 NCSC 表示漏洞可能让黑客无需登录凭据即可控制网站服务器,NSA 建议无法立即更新的机构将系统离线,白宫称联邦机构正在评估对政府系统和关键基础设施的潜在影响。
跟 AI 创作没直接关系,但自建站、自己托管素材库和作品站的团队可以留意:漏洞可让攻击者无需登录凭据控制服务器,NSA 建议无法及时更新的先离线。
点击打开原文
07
@AxtonLiu
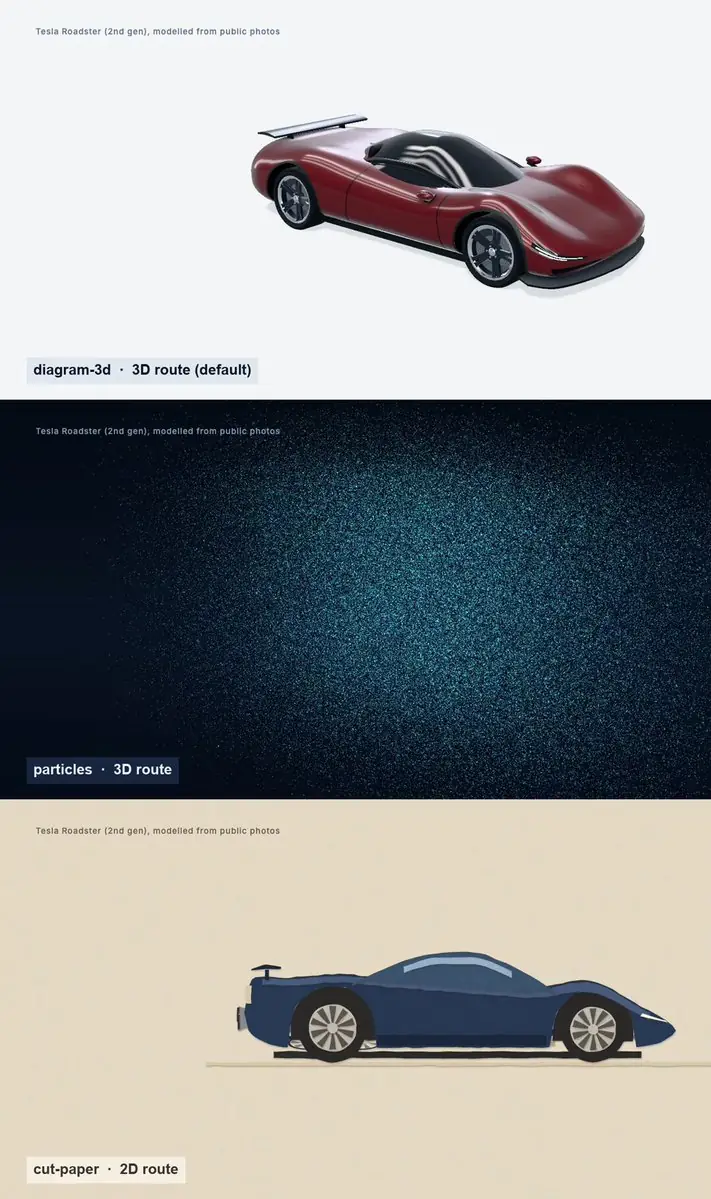
作者 Axton 将自己制作科普视频的工具 Video Illustrator 更新至 0.9 版本并开源免费,其早间一期 Roadster 内容即由该工具完成,覆盖查资料、事实表、官方实拍、3D 拆车、对齐旁白全流程。附带的演示视频把同一份内容渲成 3D 图解、粒子光轨、剪纸拼贴三种画面,每种渲染不到一分钟。
个人开发者把自己做科普片的工具开源到 0.9,查资料、事实表、3D 拆车到对齐旁白一条流程走完,同一份内容能渲成 3D 图解、粒子光轨、剪纸拼贴三种画面。做知识类视频和科普号的可以拉下来跑一期试试。
点击打开原平台查看,能否访问取决于网络环境
08
@yihui_indie
作者 Yihui 发布 LaunchMotion 系列 Skill,称把 YouTube 上优秀产品发布片的动效逆向拆解,做成 208 个特效。使用方式有两种:告诉 AI 产品或直接丢网站链接,自动生成一支宣传片;也可自行挑选动效像搭积木一样组合成片。
把 YouTube 产品发布片的动效逆向拆成 208 个可复用特效,丢个链接就能自动出宣传片,做产品片和 KV 动效的可以拿来试搭积木。
点击打开原平台查看,能否访问取决于网络环境
09
@davidim
开发者 David Im 发布 Sume API,定位为首个 0% 加价的图像与视频模型提供商。他给出的对比:Higgsfield API 即便按最大广告折扣仍加价 40%,Fal 加价 100%,Runway 对 Seedance 2 480p 加价 414%;以 Seedance 2.5 1080p 为例,Sume 比 fal 便宜 50%、比 Higgsfield API 便宜 50%(后者按最大折扣算也便宜 29%)、比 kie ai 便宜 28.02%。其观点是模型路由层不构成壁垒,API 应商品化,壁垒在应用层。
有人把各家 API 加价率摆上台面:Higgsfield 40%、Fal 100%、Runway 414%,然后自己开了个 0 加价的 Sume API。要批量跑片、算过成本的制片和技术整合者可以拿自己的用量对一遍价。
点击打开原平台查看,能否访问取决于网络环境
01
@ABAOProductions
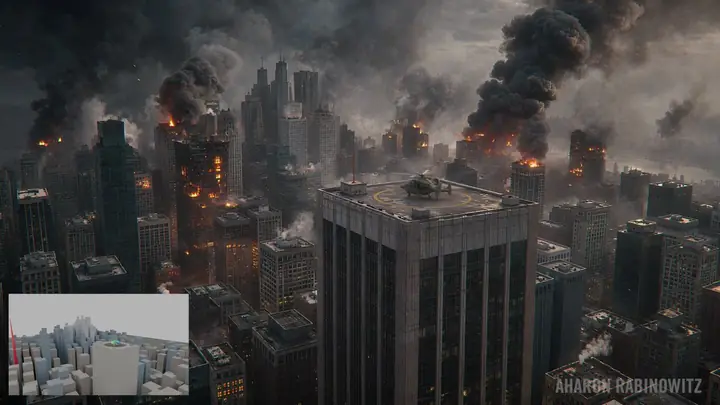
Cinema 4D 用户 Aharon Rabinowitz 用 C4D 新上线的 MCP 功能(接 Claude)完成一架 3D 直升机的建模、绑定和动画,最后用 Seedance 2.5 做最终渲染。他自称用 C4D 近 20 年,评价 MCP 是「巨大的进步」,并附上完整流程。
20 年老用户实测:用 Claude 通过 C4D 的 MCP 建、绑、动一架直升机,再交给 Seedance 2.5 出最终画面。做三维和 AI 影像的可以看这条流程怎么串。
点击打开原平台查看,能否访问取决于网络环境
02
@Saccc_c
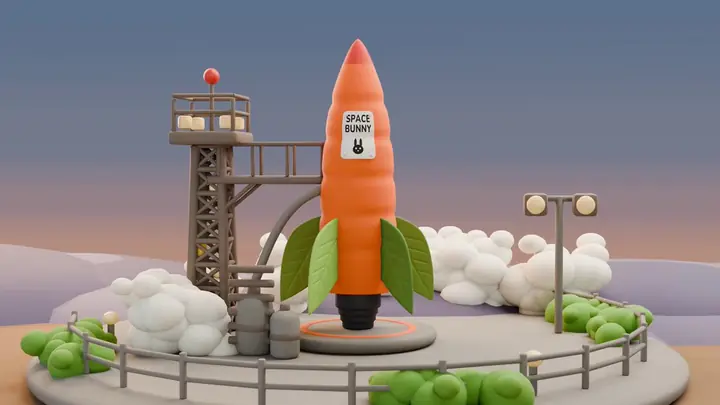
作者 @Saccc_c 称用 MiniMax M3.1 Flash 在 MiniMax Code 里纯代码生成一支 3D 动效自我介绍宣传片(该产品 10 月 20 日已发布),要求最大化视觉表现、动效转场达到宣传片质感,经多轮迭代产出。作者总结两点:模型能分配 subagent 并行执行并派独立 subagent 审查效果;能实时截图分析画面细节再迭代。该模型此前以 Space Bunny 名义在 OpenCode、OpenRouter 匿名上线,官方称复杂开发与 computer use 能力接近前沿模型、token 成本极低。10 月 25 日前 MiniMax Code 订阅用户可不限量使用,10 月 31 日前 M Plan 新订阅 5 折。
作者在 MiniMax Code 里让模型纯代码写出一支 3D 动效宣传片,靠 subagent 并行执行加实时截图自查迭代。想用代码路线做片头动效的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
03
Luma AI Blog
Luma AI 官方博客发布 Ray 3.2 与 Kling 3.0 的对比文章,主题是两者在后期制作环节谁更合适。标题之外未给出具体对比维度、测试素材或结论数据。做后期的可以点开看它选了哪些指标,但这是 Luma 自家产品参评的对比,实际表现建议用自己的素材各跑一遍再判断。
Luma 自家博客拿 Ray 3.2 对标 Kling 3.0,专挑后期环节比。做剪辑和合成的可以看它拿什么维度打分,但这是厂商自评,结论得自己跑素材验。
点击打开原文
04
@TanLuAI
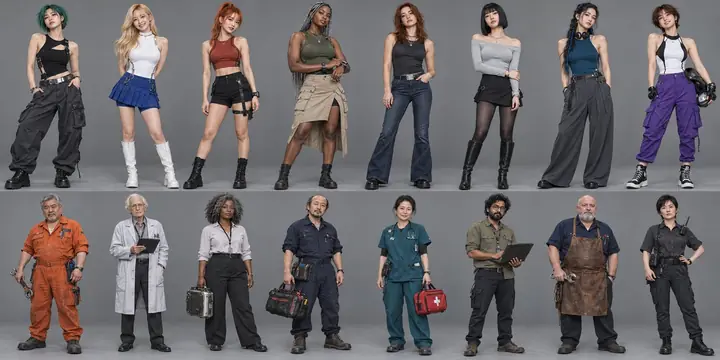
探路AI 分享一套角色卡制作流程:先让 AI 生成剧集群像人物图(可多张挑选),再从群像图中按剧情挑出满意角色,用指令把该角色转成更详细的角色卡。指令要求参考指定角色卡布局,并强调下方全身照不带头部、必须保持人脸一致性。作者称该流程除群众演员外,也适用于配角、女二等主要角色。
先出群像图挑人、再转成带全身照的角色卡,指令里明确要求全身照不带头部、锁住人脸一致性——做短剧配角和女二选角的可以照这套跑一遍。
点击打开原文,能否访问取决于网络环境
05
@Kling_ai
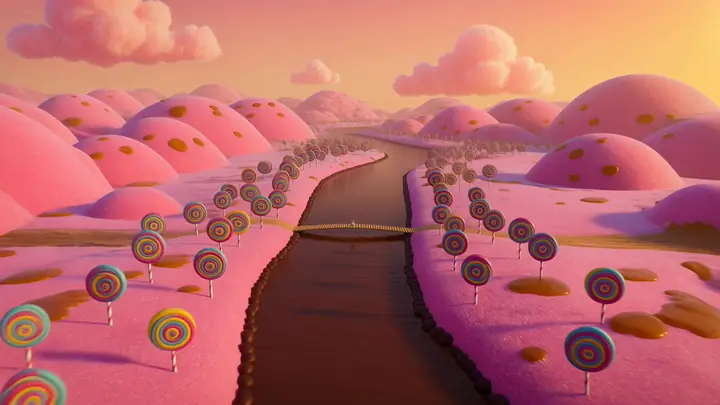
可灵官方 X 账号 @Kling_ai 发布一条 Kling 4.0 的提示词案例,配文称「一个超赞的提示词」,带 #Kling4 标签。推文本身未展开提示词正文与生成参数,具体写法需查看原帖附图或链接。
可灵官方号放出一条 Kling 4.0 的提示词示例,正文只有一句「一个超赞的提示词」,具体写法得点进原帖看。用 Kling 4.0 出片的可以顺手存下来当模板试。
点击打开原平台查看,能否访问取决于网络环境
06
@TanLuAI
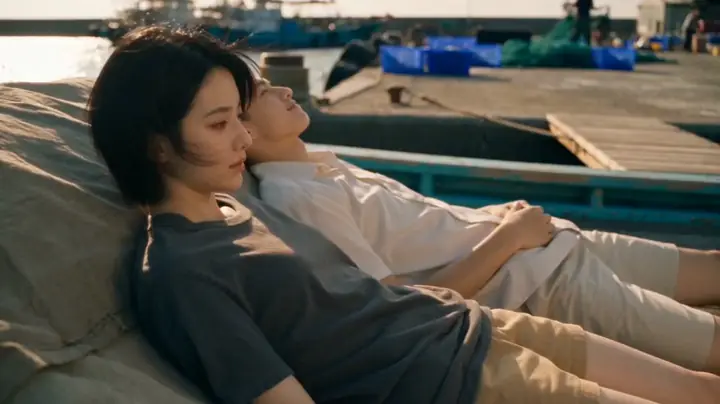
探路AI 分享 AI 视频补特写/近景的两种补救法:一是片段重拍,选取对应时间区间,用提示词把镜头改成女主近景面部、固定镜头、侧头发呆不推镜,面部参考指定图片、服装与原视频一致;二是关键帧截取法,截取全景和中近景关键帧后重新输入提示词生成。作者对比:片段重拍动作表情衔接更自然但不稳定、积分消耗多;关键帧法省积分但衔接略不自然,建议有积分时优先片段重拍。
成片缺近景特写是 AI 短剧最常见的返工点,这条给了片段重拍和关键帧截取两条路,还标了积分消耗和衔接自然度的取舍,做短剧的可以照着试。
点击打开原平台查看,能否访问取决于网络环境
07
@shao__meng
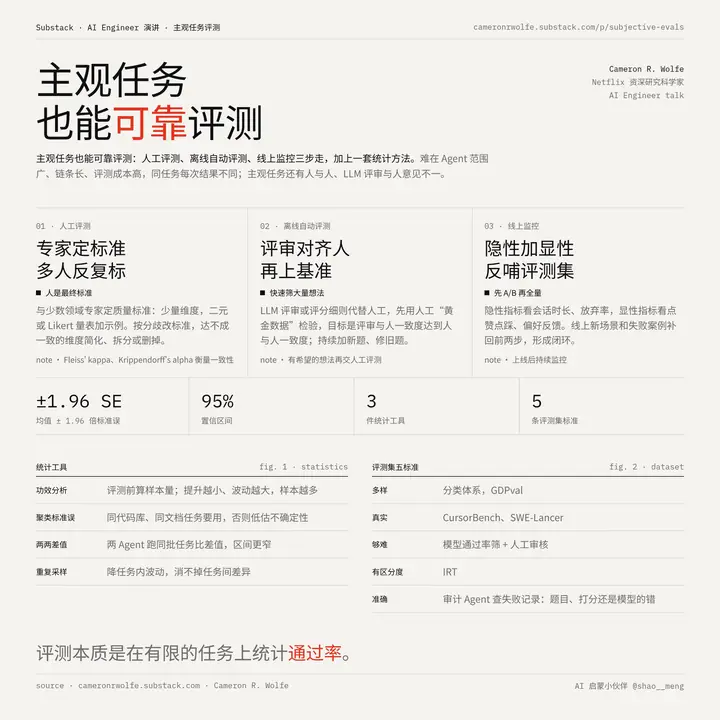
邵猛转述 Netflix 资深研究科学家 Cameron Wolfe 在 AI Engineer 大会的演讲整理,讲主观任务如何可靠评测:人工评测先和领域专家定少量评分维度和打分规则,用 Fleiss' kappa、Krippendorff's alpha 衡量标注一致性;离线用 LLM 评审代理人工,前提是先拿人工标注的黄金数据校准到「评审与人的一致度接近人与人」;线上看会话时长、放弃率、点赞点踩并做 A/B 测试,失败案例再补回评测集。配套三件统计工具:功效分析算样本量、置信区间(同源任务需聚类标准误)、重复采样降噪。评测集按多样、真实、够难、有区分度、准确五条筛选。
主观任务怎么评才不靠拍脑袋,这篇给了完整路线:先人工定标准,再用 LLM 评审代理,最后线上 A/B 兜底,还配了功效分析和置信区间。做 AI 短剧批量出片、要判断「这版比上版好在哪」的团队可以照着搭一套。
点击打开原文,能否访问取决于网络环境
08
@imhealmachine
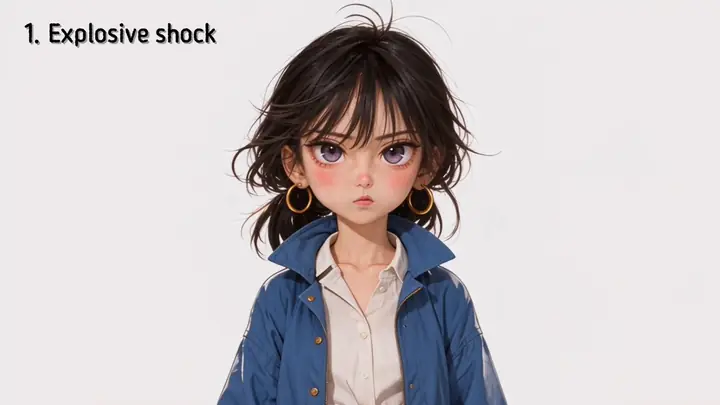
韩国创作者 @imhealmachine 整理了 20 条适合动画的夸张表情提示词,主打漫画式过火表情,用于给视频加情绪亮点,完整提示词放在推文回复里,该视频由 CapCut 支持制作。
20 条漫画式夸张表情提示词,作者说适合当视频里的可爱亮点,做动画和短剧的可以拿去补角色情绪镜头。
点击打开原平台查看,能否访问取决于网络环境
09
Luma AI Blog
Luma AI 官方介绍 Gemini Omni Flash 与 Wan 3.0 的横向对比(该产品 8 月 11 日已发布),标题即提出「当下最好的 AI 视频模型是哪个」。输入仅提供标题,未给出具体对比维度、测试用例与结论。做视频选型的团队可点开看它用什么标准比、拿什么素材测。
两个视频模型的正面对比,选型阶段可以看它怎么拆画质、动作和提示词跟随,再自己拿同一段 prompt 跑一遍验证。
点击打开原文
10
@GoogleDeepMind
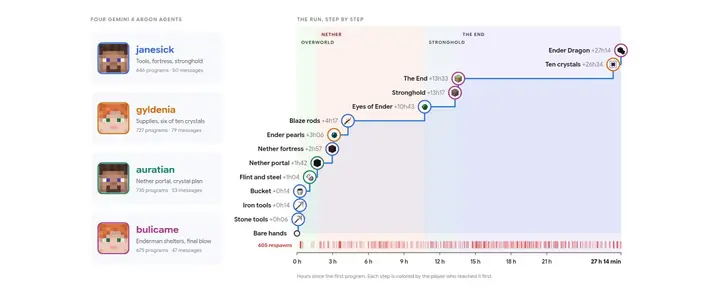
Google DeepMind 展示四个 Gemini 4 Argon 智能体在共享 Minecraft 世界中从零击败末影龙,全程无人类帮助,耗时 27 小时。智能体只在代码和文本沙盒中操作,共编写 2,783 个程序,通过聊天分配任务、共享笔记并共同调试错误。这是多智能体长程协作与自主纠错的能力演示,不涉及图像、视频或音频生成。
多智能体协作的硬核演示:四个 Gemini 4 Argon 在共享世界里靠聊天分工、共享笔记、互相调试,27 小时从零打赢末影龙。做 Agent 工作流调度的可以看看它们怎么分工,拍片的用不上。
点击打开原文,能否访问取决于网络环境