01
@claudeai
Anthropic 的 Claude 官方账号宣布开放 Claude Duet 研究预览,定位是让 Claude 以主动式智能体形态工作:主动提示需要关注的事项、完成用户交办的任务、在用户离开后继续推进,并在代替用户行动前先向用户确认。目前为研究预览阶段,具体可用范围与接入方式以官方说明为准。
Claude 官方开放 Duet 研究预览,能主动提醒待办、用户离开后继续干活、动手前先确认。做制片统筹和项目管理的可以申请试用,看能不能把排期、素材催办这类杂活接过去。
点击打开原平台查看,能否访问取决于网络环境
02
公众号:生数科技(Vidu·视频)
生数科技宣布,博纳影业打造的 100 分钟科幻电影《三星堆:未来往事》将于 10 月 23 日登陆院线,称是中国首部获国家电影局公映许可证的 AI 超写实院线电影,Vidu 提供首席技术支持。影片人物全部由 AI 生成,无真人演员及数字复刻,制作上采用博纳 AIGMS 自研的博卡电影云片场叠加 Vidu 视频模型,协同完成分镜、画面到视频生成。
国内首部拿到公映许可证的 AI 超写实院线片,人物全 AI 生成、无真人演员,博纳云片场叠 Vidu 跑完分镜到视频。做 AI 长片和短剧的可以盯这条制作流程。
03
@ArtificialAnlys
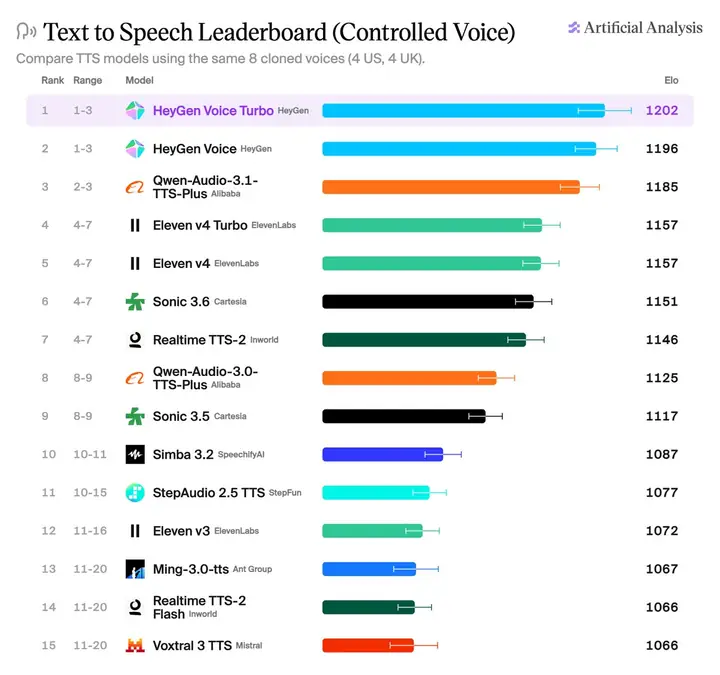
Artificial Analysis 受控语音 TTS 竞技场更新排名,HeyGen Voice Turbo 以 Elo 1,202 登顶,在 46 个参评模型中领先自家上一代 HeyGen Voice(1,196)与 Qwen-Audio-3.1-TTS-Plus(1,185)。榜单为受控条件下的盲测对比,可用于横向比较各家 TTS 的自然度表现。
第三方榜单实测,Voice Turbo 以 1202 分压过自家上一代和 Qwen-Audio-3.1-TTS-Plus,做 AI 配音和数字人对口的可以拿同一段台词跑一遍对比听感。
点击打开原平台查看,能否访问取决于网络环境
04
@meetshukla_
用户 @meetshukla_ 发帖指控 Higgsfield 将其他公司模型改名后作为自有模型出售,并引用其 API 文档作为证据:Genjutsu Lite 定价 480p $0.05 / 720p $0.10 / 1080p $0.20 每秒,与 Wan 3.0 完全一致,分辨率也相同;Genjutsu 支持最多 30 张参考图、4–30 秒时长,与 Seedance 2.5 一致,价格为后者视频编辑定价加价约 20–30%;Cinema Studio 4.0 的 $0.2057 / $0.4623 每秒与 Seedance 2.5 的 $0.2056 / $0.4622 几乎相同。帖子称其 API 中同一模型同时以 alibaba/wan-3.0 和 higgsfield/genjutsu-light 两个名字列出。
有人拿 Higgsfield 自家 API 文档逐条比对价格、分辨率、参考图数量,指其 Genjutsu 系列实为 Wan 3.0 和 Seedance 2.5 改名加价。买第三方视频 API 的团队值得核一遍自己账单。
点击打开原平台查看,能否访问取决于网络环境
05
Hugging Face 社区博客
IBM 在 Hugging Face 发布 Granite Speech 系列三项更新:新模型 granite-speech-5.0-2b,以及更新版 granite-speech-5.0-470m-turboctc 和 granite-speech-4.1-2b-plus,均采用 Apache 2.0 许可证,可商用。470m 的小体积版本适合本地部署,2B 版本面向更高精度的语音任务。
IBM 一次放出三个语音模型,2B 新模型加两个更新版,全部 Apache 2.0 可商用。做配音、字幕、语音转写的后期可以下下来跑一遍,看识别和合成质量够不够进自己的流程。
点击打开原文
06
@splinetool
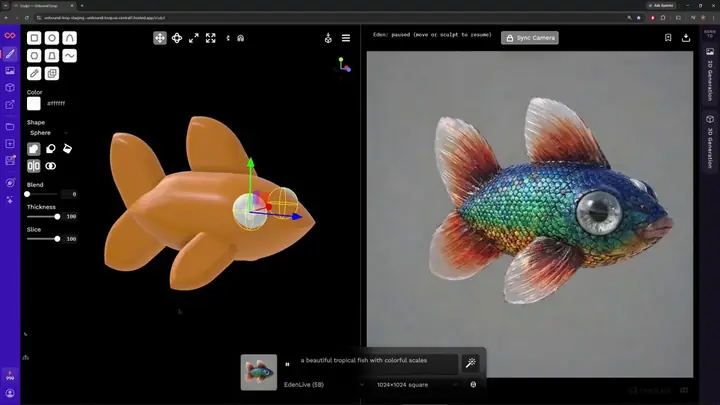
Spline 官方宣布推出 ChatGPT 插件,可在 ChatGPT 或 Codex 的对话中直接创建和编辑 3D 互动场景,已通过 OpenAI 插件生态上线可用。对做视觉开发和动态物料的创作者来说,多了一条在对话里出 3D 场景的路子,具体生成质量与可编辑程度需实际跑一遍验证。
在 ChatGPT 或 Codex 对话里直接建、改 3D 互动场景,不用切软件。做视觉开发和动态 KV 的可以试一下,看能不能省掉建模软件那一跳。
点击打开原平台查看,能否访问取决于网络环境
07
@OpenRouter
OpenRouter 宣布 Recursive 首个模型 Flint 上架并支持免费试用。该模型为开源权重 40B MoE(约 2.5B 激活),由自动化研究系统 Eureka Machine 构建,面向编码智能体,具备 262K 上下文、推理与工具调用能力。Recursive 自报成绩为 Terminal-Bench 2.1 54.9%、SWE-bench Pro v2 89.7%、SWE-bench Verified 74.2%。
当天有 5 家独立信源在报同一件事,属于行业动向本身。对具体创作流程没有直接用处,但这个量级的消息值得知道。
点击打开原平台查看,能否访问取决于网络环境
08
公众号:火山引擎
火山引擎前线部署工程服务(FDE)通过中国信通院《企业级全栈人工智能服务能力成熟度 FDE 专项》评估,成为首批获评「先进级」的企业之一,评估覆盖规划设计、交付实施、运营与运维、持续优化、增值技术服务、生态聚合六大维度。营销场景案例中,FDE 基于 Seedance 系列模型搭建 Multi-Agent 架构,预计每年为客户节约数千万元制作成本,单条素材交付时间从数天缩短至数小时。
火山引擎的 FDE 服务拿到信通院「先进级」评估,案例里用 Seedance 搭 Multi-Agent 做营销素材,单条从数天缩到数小时。做批量素材和短剧的制片可以看看这套交付模式。
09
@Solopopsss
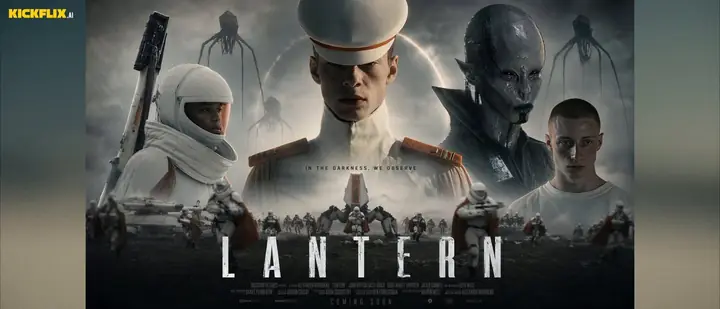
X 用户 @Solopopsss 公布其 90 分钟 AI 电影《LANTERN》的官方预告片,称影片为科幻史诗题材,正与好莱坞编剧和制片人合作推进,并在推文中公开征集合作者私信联系。目前公开的是预告片,正片尚未放出。
90 分钟 AI 长片放出官方预告,作者称正与好莱坞编剧、制片人合作推进科幻题材。做 AI 长片的可以蹲正片,看长篇幅叙事和镜头怎么撑住。
点击打开原平台查看,能否访问取决于网络环境
01
@FlowbyGoogle
Google Flow 官方演示用参考图控制视频调色的做法:先用 Omni 1.1 Flash 上传或生成一段视频(官方说风景和环境类效果最好),再上传或生成一张带目标色板的参考图;把两者一起拖进 prompt,用 @ 符号直接标记参考素材,写「Adapt this video into the same color style of this image」;要保住场景一致性再加一句「keep camera motion and environment the same」。
官方给了套现成做法:视频和色卡图一起拖进 prompt,用 @ 打标,再加一句锁住镜头运动和环境。做视觉统一的可以照着跑一遍,看风格迁移后镜头稳不稳。
点击打开原平台查看,能否访问取决于网络环境
02
@rewind02
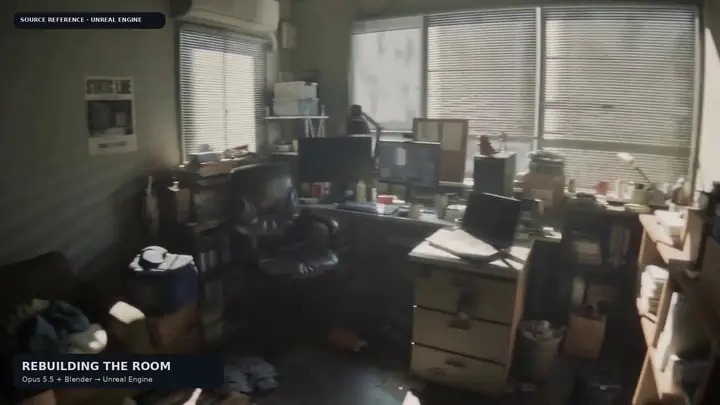
作者 @rewind02 分享用 Claude Opus 5.5 通过 MCP 连接 Blender,输入 2-3 张参考截图,输出含 1,876 个对象的完整 3D 办公室场景。流程分八步:接 MCP 传参考图、锁定与参考一致的固定机位、先搭墙体窗户百叶、再放大件家具并对照锁定、逐区域填桌面书架窗台地面杂物、在镜头最关注处补细节、赋材质后匹配参考光、渲染后并排比对每次只改一处。全程保持同一机位,便于逐阶段看出缺什么。
把 Opus 5.5 通过 MCP 接进 Blender,从参考截图直接搭出整间办公室的 3D 场景,八步流程写得很清楚。做美术和场景预演的可以照着跑一遍,固定机位逐阶段比对这招尤其好用。
点击打开原平台查看,能否访问取决于网络环境
03
@Kling_ai
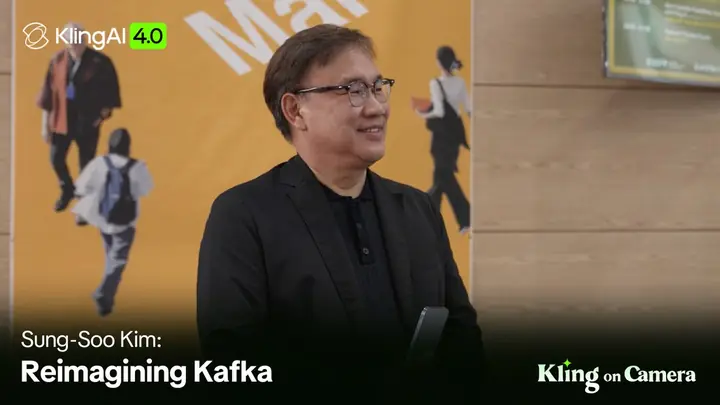
可灵官方分享韩国导演金成洙的 AI 制片首秀:拥挤地铁车厢里乘客与巨型虫子相撞的卡夫卡式场景,是他多年想搬上银幕的镜头。视频中他讲述首次用 AI 制片的经历,并说明可灵 4.0 如何让这个「不可能」的镜头落地(该产品 10 月 16 日已发布)。
韩国导演金成洙第一次用 AI 制片,把多年想拍的地铁巨虫卡夫卡场景做出来了。编导可以看他怎么处理「不可能镜头」的调度和空间关系。
点击打开原平台查看,能否访问取决于网络环境
04
@KinGao476942
推主整理 8 个用 Opus 5.5 做视频的 GitHub 仓库:awesome-opus5-5-videos(约 7100 star)收录爆款视频并附提示词;lemo-opuscar(约 4400 star)是 Claude Code skill,选风格即可生成纯代码短片,51 种风格;pdoom-video(约 3000 star)与 PDoomVideo(约 2300 star)是同一首歌的两支歌词卡拉 OK MV 完整工程,本地可渲 4K60;mg-styles-15(约 1400 star)给 15 种 MG 动效风格的成片、提示词与源码;ClaudeAnimationBase(约 1300 star)是手绘卡通角色动画起步包,自带 31 种表情;awesome-claude-5-5-videos(约 560 star)收录 301 个 Opus 视频工作流案例;opus-video-prompts(约 510 star)为中文案例配可复制提示词。
8 个 GitHub 仓库打包,从爆款视频提示词到 51 种纯代码短片风格、4K60 MV 工程源码都有。想用 Opus 5.5 出片又不知道从哪下手的,先挑两个 clone 下来跑。
05
@aiwarts
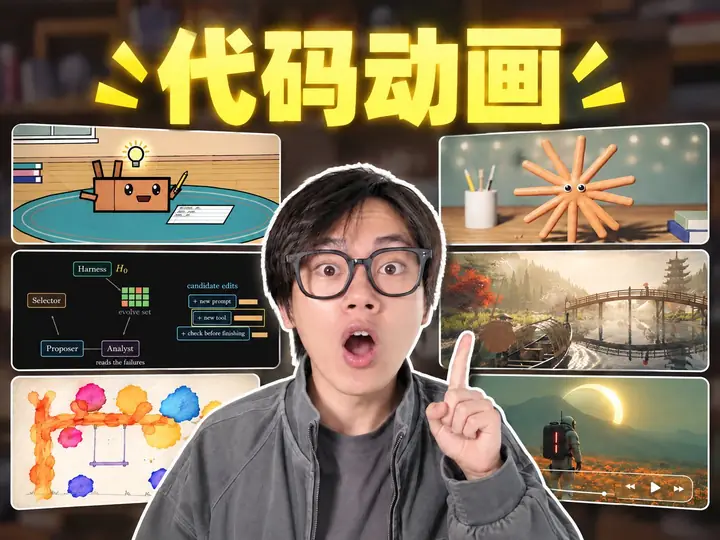
X 作者 @aiwarts 发布近 7 分钟视频,讲解用 Opus 做动画的六类玩法:产品宣传片、科普动画、手绘动画、3D 场景、音乐 MV,以及用 AI 视频做丝滑转场的技巧。视频从代码动画原理讲起,说明无需先学写代码,但需要把想要的效果描述清楚,并附时间轴便于跳看。
产品宣传片、科普动画、手绘、3D 场景、MV 加转场技巧,六类玩法一次讲完,还带时间轴能跳看。做视觉和后期想用代码动画补镜头语言的,可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
06
@shao__meng
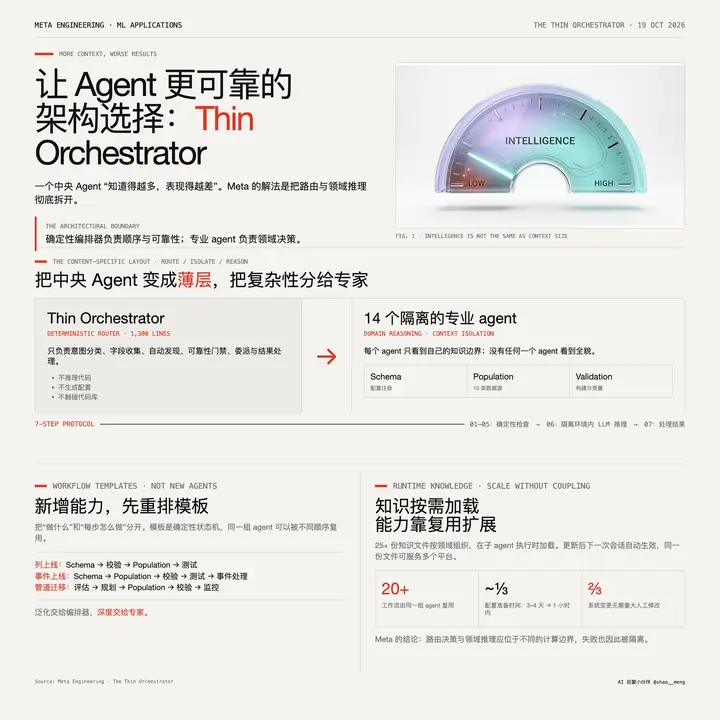
Meta 工程团队发布 Agent 架构实践「Thin Orchestrator」:约 1300 行确定性瘦调度器负责意图分类、字段收集和可靠性检查,把 20+ 工作流路由到 14 个上下文隔离的专业 Agent,7 步协议里只有委派一步涉及 LLM 推理。文中引用 Mount Sinai 研究称多 Agent 调度在 80 任务批次下准确率 65.3%、单 Agent 仅 16.6%,token 消耗最多降 65 倍。核心做法是把「做什么」的流程模板与「每步怎么做」的子 Agent 分离,新增能力只需加模板重排现有 Agent。
Meta 工程团队把「一个全能 Agent 越装越傻」拆成 1300 行确定性调度器 + 14 个各管一摊的子 Agent,只有委派那一步走 LLM。自己搭批量出片流程的技术整合者可以照着这个结构改一版。
点击打开原文,能否访问取决于网络环境
07
@Google
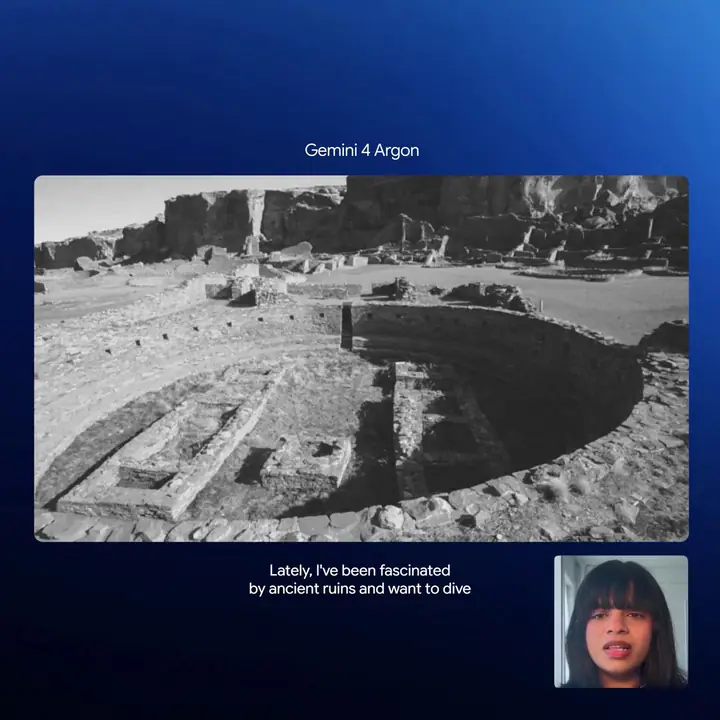
Google 官方发布案例:将查科峡谷的原始 LiDAR 扫描数据与档案资料输入 Antigravity,使用 Gemini 4 Argon 配合 Blender MCP 构建出可探索的 3D 数字遗产遗址模型。展示的是从零散考古记录到三维场景的转换路径,涉及扫描数据、AI 模型与 Blender 工作流的串联。
Google 官方演示:把 LiDAR 扫描和档案资料喂进 Antigravity,用 Argon 加 Blender MCP 搭出可探索的 3D 遗址。做场景搭建和虚拟制片的可以看这套「资料转三维」的路子。
点击打开原平台查看,能否访问取决于网络环境
08
@godswayfoundinc
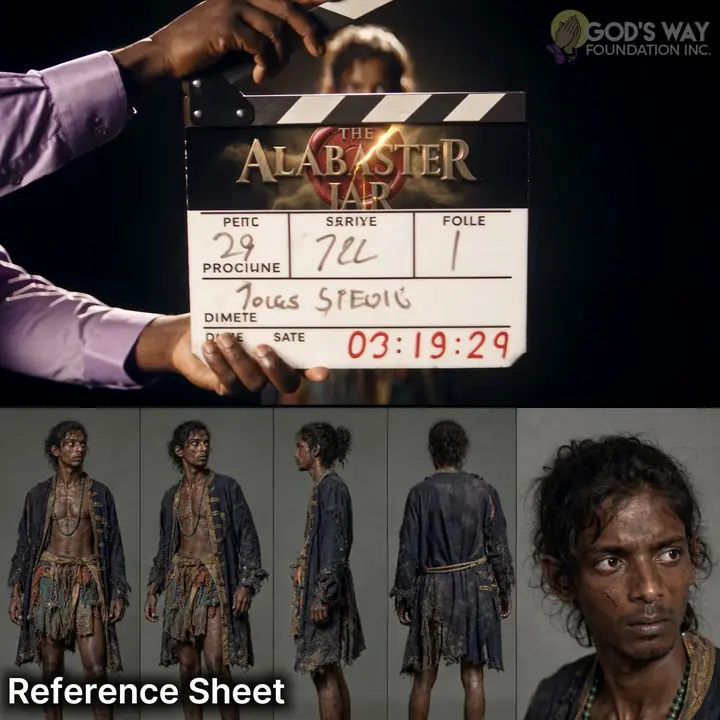
创作者分享用 Seedance 做 AI 角色的工作流:不要直接把角色放进场景,先做一次「试镜」。理由是模型会读取角色设定图里的年龄、体型、肤色、族裔、服装磨损等外观信息,据此生成声音,即使你指定了口音。试镜设置为纯色背景、角色单人站位、一个从全景推到特写的慢推镜、一段面向镜头的自我介绍独白;推镜同时检查服装(全景)和面部(特写),发现偏离设定图就回头补细节参考图。示例角色的试镜只用一张角色设定图,没有声音文件或音频参考。
做 AI 角色片的可以试这套「试镜」流程:纯背景、单人站位、一个从全景推到特写的慢推镜,让 Seedance 先按角色设定图定下声音,再进正式场景。
点击打开原平台查看,能否访问取决于网络环境
09
@my189
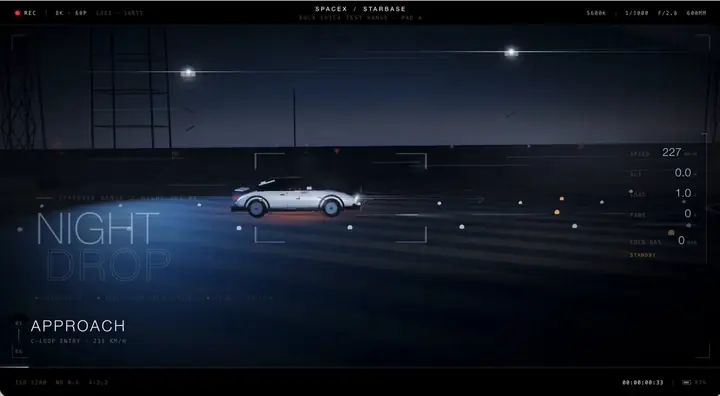
作者用 DeepSeek-V4.1-Flash-1017 一次生成 Three.js 动画,覆盖「磁吸倒挂 + RCS 冷气翻滚 + 反推缓降 + 悬挂回弹」整套连续物理状态,并公开了完整分镜级提示词:夜间得州 SpaceX 测试场、白色二代 Roadster 冲上 C 形坡道倒挂、冷气脉冲推动 180° 横滚回正、落地缓冲,含手持长焦跟拍与 8K 写实光学眩光描述。作者称以前调重力、阻尼、粒子喷射和镜头抖动要熬几个通宵,现在一段 prompt 即可生成可交互 Web 3D。
作者把分镜级提示词整段贴出来了,讲的是怎么用一句话让模型写出带重力、阻尼、冷气喷射和手持抖动的 Web 3D 连续动作。做交互主页或想给片子做动态预演的,可以拿这段 prompt 换载具和受力状态试一遍。
点击打开原平台查看,能否访问取决于网络环境
10
@turingou
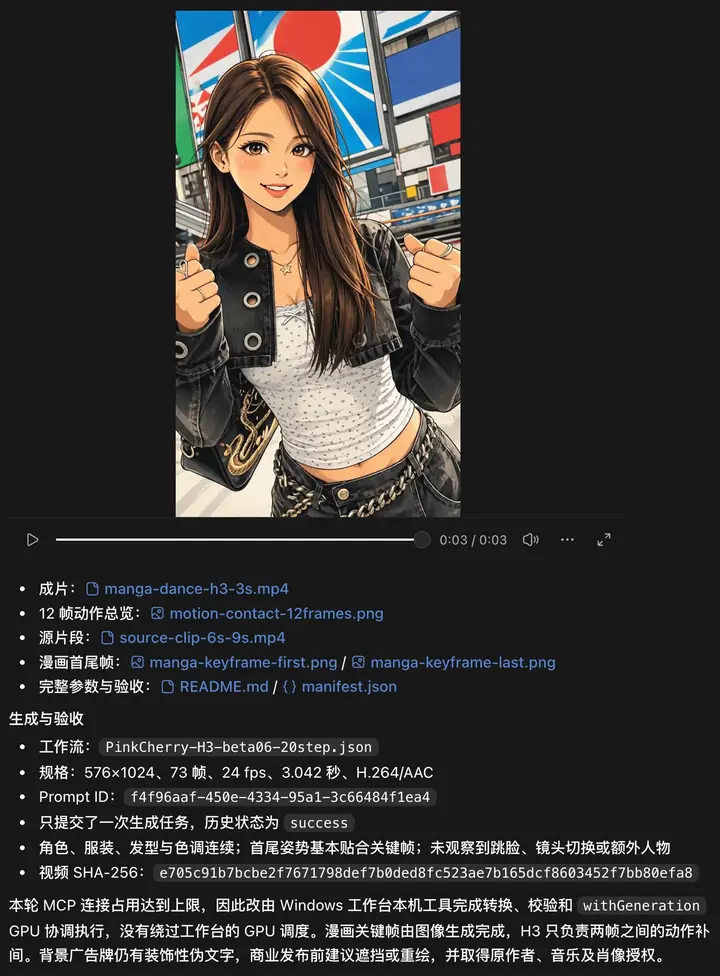
郭宇(@turingou)做的小实验:用 DeepSeek 操控闲置手机池中的一台手机,抓取一条 TikTok 热门视频,再通过 Windows PC 上的媒体工作流生成漫画版本,全程自动,耗时约 30 分钟。他提到起因是 Codex 额度快用完,并提到自己的 MCP 配置是耗时的主要因素。
个人实验:DeepSeek 操作闲置手机抓 TikTok 热门视频,再走 Windows 上的媒体工作流转成漫画版,全程约 30 分钟无人值守。想搭自动抓取加改绘流程的可以看看他的做法。
点击打开原平台查看,能否访问取决于网络环境
11
@higgsfield_ai
Higgsfield 官方账号发布 Wan 3.0 与 Seedance 2.5 的动漫叙事对比,两段生成共用同一句提示词:湖上宁静的傍晚,直到天空长出翅膀。成片为 11 秒短片,在 Higgsfield 平台上生成。
同一句提示词「湖上傍晚,天空长出翅膀」分别跑 Wan 3.0 和 Seedance 2.5,做动漫向的可以拉片看两家在氛围和镜头连贯上的差别。
点击打开原平台查看,能否访问取决于网络环境