01
@fal
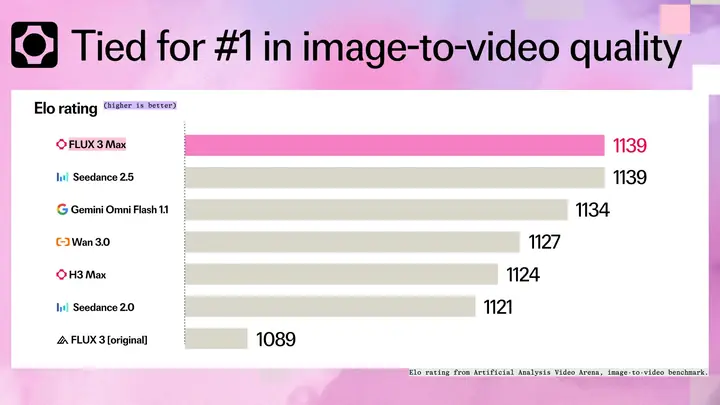
fal 官方介绍与 Black Forest Labs 合作后训练的视频模型 FLUX 3 Max(该产品 10 月 20 日已发布),在第三方独立人类偏好评测中获 1139 Elo,与 Seedance 2.5 并列图生视频质量第一梯队。该模型约 12 秒生成一段 10 秒 720/768p 视频,未来三周降价 75%,官方称后续还将继续后训练改进。
图生视频 Elo 1139 与 Seedance 2.5 并列第一梯队,12 秒出 10 秒 720p 片,未来三周还降价 75%。做分镜预演和短剧镜头的可以趁降价窗口跑一批素材比废片率。
点击打开原文,能否访问取决于网络环境
02
@elevenlabs
ElevenLabs 发布 Eleven Realtime,官方称其为「一类新的语音到语音(Speech to Speech)模型」。官方说法是语音智能体通常要在快速回复和准确回答之间取舍,Eleven Realtime 两者兼顾:能在半秒内开始说话,并答对口语推理问题。适用于实时对话、配音、虚拟角色等场景。
半秒开口还能答对口语推理题,做 AI 配音、虚拟角色实时对话的可以接 API 测一轮延迟和打断表现。
点击打开原平台查看,能否访问取决于网络环境
03
Tripo
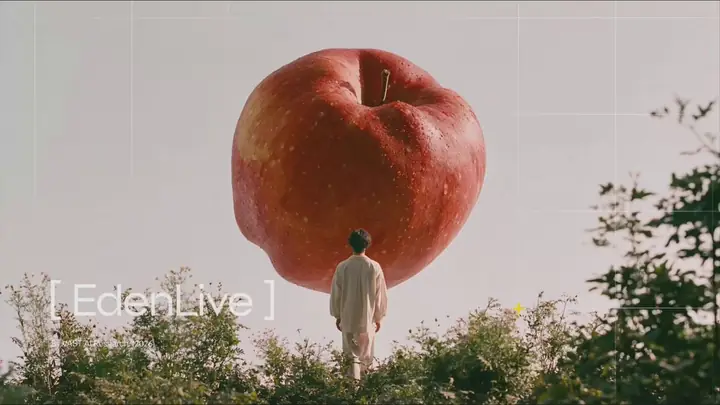
VAST(@VASTAIResearch)开源实时生成渲染器 EdenLive,5B 参数,单张 RTX 5090 上 720p 分辨率可达 24+ FPS。输入支持 3D blockout、游戏引擎画面、2D 卡通和真实视频,输出写实或风格化视频。
3D blockout 和引擎画面能实时转写实或风格化,单张 5090 跑 720p 24 帧,做预演和后期转绘的可以拉下来试跑,看能不能塞进现有流程。
点击打开原平台查看,能否访问取决于网络环境
04
@ArtificialAnlys
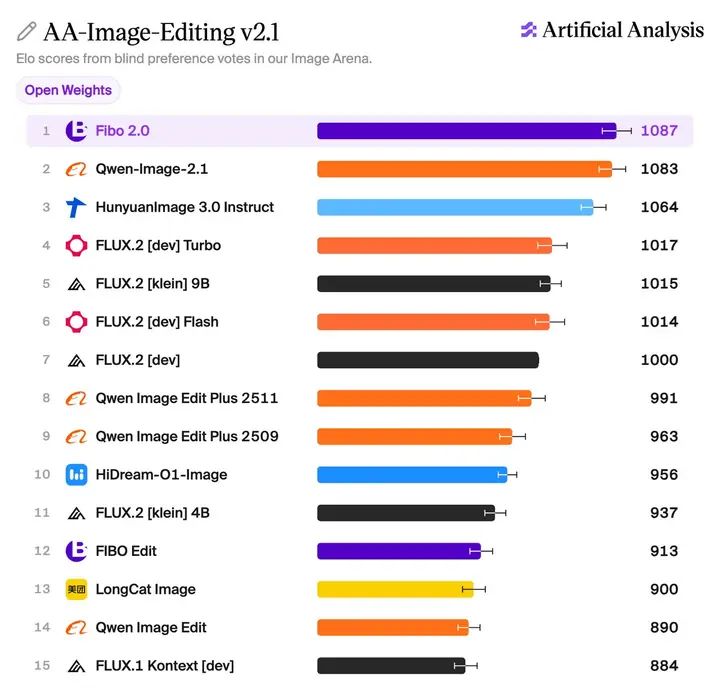
Bria 发布 8B 开源权重图像模型 Fibo 2.0,分两套权重:Fibo 2.0 Dev 做文生图,Fibo 2.0 Edit Turbo 是蒸馏加速版做图像编辑。Artificial Analysis 实测其在 AA-Image-Editing v2.1 上位列开源权重第一,在 AA-Image-T2I v2.1 上与 Qwen-Image-2.1 统计并列领先,相比第一代 Fibo 在每一项编辑动作和文生图能力上都有提升,涨幅最大的是文字/符号编辑、文字渲染和版式。权重为非商用许可,商用需单独与 Bria 签约;Bria API 定价每千张 32 美元,低于 Luma UNI 1 Max 的 100 美元和 Qwen Image 2.0 Pro 的 75 美元。
8B 开源权重、编辑榜第一、文生图与 Qwen-Image-2.1 打平,API 每千张 32 美元比 Luma、Qwen Pro 都便宜。做视觉开发和批量改图的可以接 API 跑一轮,重点看文字渲染和版式这两项提升。
点击打开原平台查看,能否访问取决于网络环境
05
@motion_so
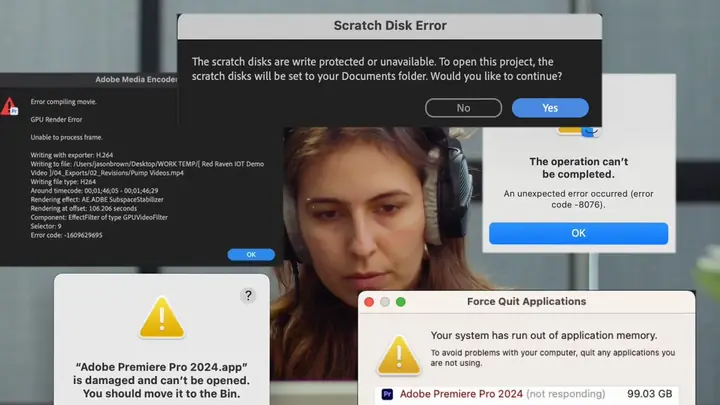
Motion 发布通用视频代理 GVA,输入可以是素材、创意简报或一条参考视频,输出成片。官方列出的能力包括:把长视频剪成片段、生成发布视频与动态设计、复刻任意参考视频的风格,并支持导出到 Premiere、After Effects 和 DaVinci。官方称这条发布视频本身即由 GVA 制作,产品已上线可用。
丢素材、丢简报、丢一条参考片,它直接剪成片,还能复刻参考视频风格并导出 Premiere、AE、达芬奇。后期和剪辑团队可以拿自己手上的废片跑一遍,看它剪出来的节奏能不能用。
点击打开原平台查看,能否访问取决于网络环境
06
@MistralAI
Mistral AI 发布 Voxtral 3 系列,含 Transcribe 与 Speech 两个语音模型,官方称达到业界领先水平,两者为 Mistral 新推出的语音智能体 API 提供支持。转写模型对应字幕、会议记录类场景,语音模型对应配音与角色发声,语音智能体 API 则面向实时对话类应用。
Mistral 一次放出转写和语音两个模型,还配了语音智能体 API,做 AI 配音、角色对话、自动字幕的可以接上去跑一周,看中文识别和语气自然度够不够用。
点击打开原平台查看,能否访问取决于网络环境
07
公众号
火山引擎上线 Seedance Managed Agent,一个基于 Seedance、Seedream 构建的视觉创作 Agent,通过自研 Harness 与视觉模型联合调优,把模型、Skills 与工具组织成完整创作流程。官方定位是覆盖视觉创作全流程的托管式 Agent。原文正文抓取失败,具体能力边界、可用入口和计费方式需打开原文确认。
火山把 Seedance、Seedream 加上 Skills 和工具串成一个视觉创作 Agent,官方称覆盖从创意到成片的完整流程。做短剧和批量出图的团队可以先去控制台跑一遍,看它能不能替掉现在手工串的那套流程。
08
@higgsfield
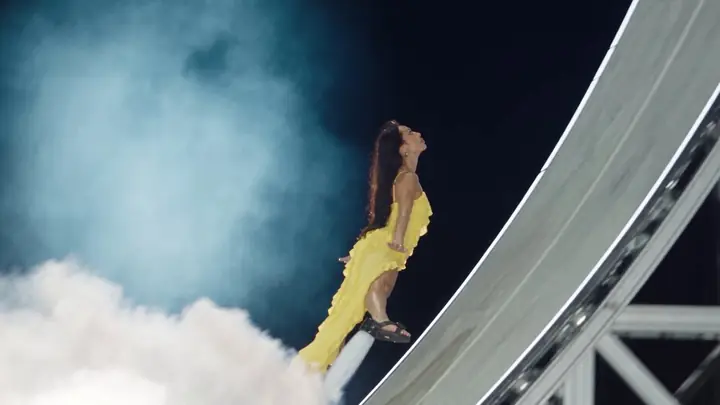
Higgsfield 推出 Genjutsu Lite,可将用户照片置入任意热门视频中。官方称 720p 生成成本降低 3.5 倍、1080p 降低 5 倍,现已上线 Higgsfield 平台并提供 API,Genjutsu 与 Genjutsu Lite 在部分区域可免费试用。
把照片塞进现成热门视频里,720p 成本降 3.5 倍、1080p 降 5 倍,还开了 API。做二创混剪和短剧换脸的可以接上去跑一批看效果。
点击打开原平台查看,能否访问取决于网络环境
09
@fal
fal(@fal)宣布与 FireworksAI(@FireworksAI_HQ)合作提前发布 EAGLE-4,并附技术博客链接,称文中说明 EAGLE-4 的工作原理以及它对创意工作流的意义。推文本身未给出模型参数、生成能力或可用方式。
fal 和 FireworksAI 联合提前放出 EAGLE-4,官方说跟创意工作流有关,具体能力得点技术博客看。跑 fal 那套流程的可以先去翻一眼,判断值不值得接进自己的出片环节。
点击打开原平台查看,能否访问取决于网络环境
10
@ArtificialAnlys
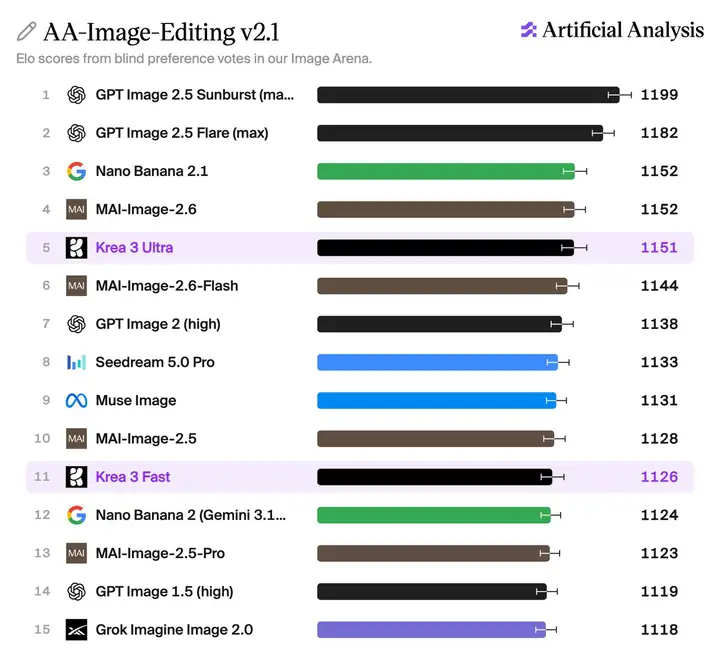
Artificial Analysis 把 Krea 3 Ultra 测入 AA-Image-Editing v2.1 榜单,排第 5,质量接近 Nano Banana 2.1 与 MAI-Image-2.6,是 OpenAI、Google、Microsoft 之外排名最高的图像编辑模型。17 个类目里 15 个进前 7,动画与游戏、Frontier 两类均列第 2;默认的 Fast 模式排第 11。API 价格:Fast 每 1K 图 0.03 美元加每 1K 参考图 0.02 美元,Ultra 仅支持 2K 输出,一张 2K 编辑带一张 1K 参考图 0.27 美元。
非 OpenAI/Google/微软系里排名最高的图像编辑模型,动画与游戏类目排到第 2。做视觉开发和 KV 的可以拿它跟 Nano Banana 2.1 对跑同一批参考图,比一比风格还原。
点击打开原平台查看,能否访问取决于网络环境
11
公众号
DeepSeek 官方公众号宣布将内部推理框架 DeepInfer 全面开源,同时开源生产级 Token 编解码组件 deepseek-recipe。两项都是模型推理与部署环节的基础设施,面向自建推理服务的工程侧。
推理框架和 Token 编解码组件开源,属于部署侧的事,跟拍片剪片不沾边,做模型自建服务的后端可以看一眼。
12
@OpenAI
OpenAI 官方宣布收购 Orchestra Bio,该平台用于帮助生物制药团队协调药物研发的复杂流程。收购后双方将基于 OpenAI 面向生命科学研究的模型与工具 Rosalind 展开合作,简化相关运营,让新疗法更快到达患者。这条属于 OpenAI 在生命科学方向的业务布局,与影像、音频、视频生成等创作能力无关。
OpenAI 买下一家生物制药研发协作平台,跟影视创作没有交集,编导和短剧团队可以直接跳过。
01
公众号:火山引擎
2026 美好奇妙夜现场,杨丽萍在《雀之灵》中与 Seedance 2.5 生成的数字孔雀同步起舞,用的是 Seedance 2.5 的动作迁移能力;火山引擎智能视频云以「巨幕超分」方案把 720p/1080p 的 AI 素材提升到 8K/16K,支撑 20 米级舞台巨幕。胡彦斌与 TRAE 社区创作者用 AI Coding 做出五道激光琴弦,触碰光束即触发声音。
Seedance 2.5 的动作迁移被搬上 20 米级舞台巨幕,720p 素材靠超分撑到 8K/16K。做舞台影像和真人+数字角色合成的,这套「生成+超分」组合值得拆一遍。
02
@threeaus
作者陆三金(@threeaus)分享用 Opus 5.5 批量制作资讯类竖屏视频的经验,称这批视频在各平台获得不少关注,并认为资讯类视频很适合交给大语言模型来做。文中附有提示词和开源的风格 skill,供他人复用。
资讯类竖屏视频的完整做法,作者附了提示词和开源风格 skill,做资讯号、口播号和批量短视频的可以照着跑一遍。
点击打开原文,能否访问取决于网络环境
03
@Pluvio9yte
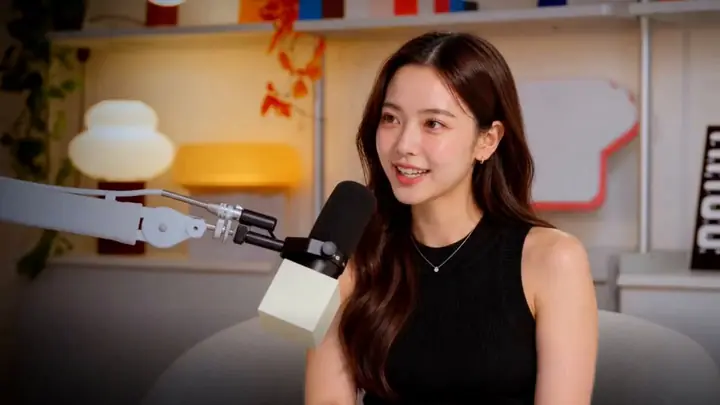
作者拆解了一套 AI 视频播客的制作流程:GPT-Image 生成录音棚场景与一致角色资产,LTX 负责微表情和侧身动态,ElevenLabs 加 Gemini 混合出双人音色,Soniox 提供毫秒级时间戳,最后由 Opus 配合 HyperFrames 用代码完成切镜与包装,全程不依赖 AE。适合做双人对谈、口播类内容时参考分工方式。
从 GPT-Image 出场景和角色、LTX 驱动微表情,到 Soniox 打时间戳、Opus 用代码切镜包装,整条流程不碰 AE。做口播、访谈、播客视频的后期可以照着搭一遍。
点击打开原平台查看,能否访问取决于网络环境
04
@magnific
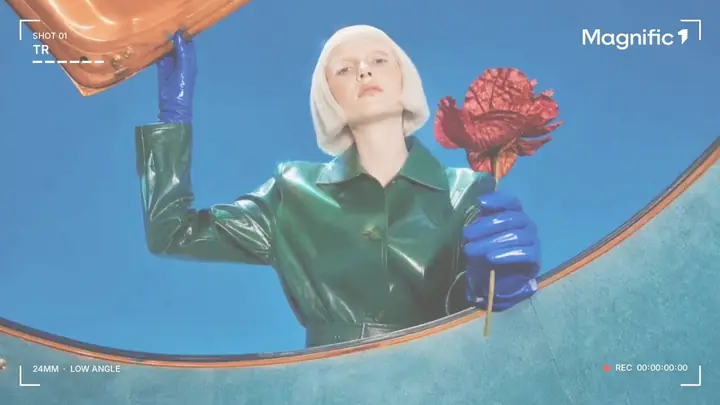
Magnific 官方发布一串 6 条提示词,主题是「6 个你没试过的角度」,全部用 Magnific One 生成,每条帖子附完整可复制的 prompt,并强调「换主体、保留角度」的复用思路。适合当作机位/视角模板收集,用于视觉开发与分镜阶段的构图参考。
官方开了一个串,6 个不常见机位各配完整提示词,换主体不换角度就能复用。做视觉开发和分镜的可以存下来当机位模板库。
点击打开原平台查看,能否访问取决于网络环境
05
@higgsfield_ai
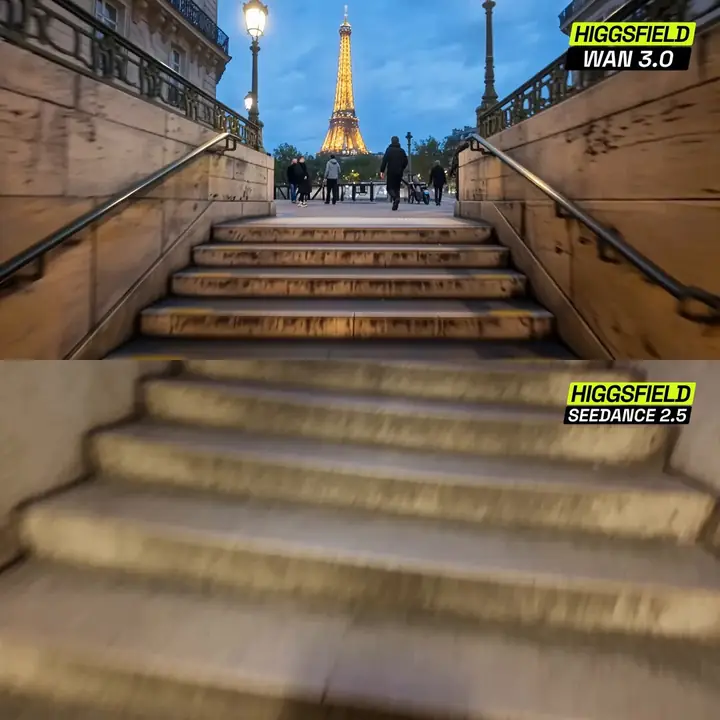
Higgsfield AI 官方发布一条对比演示:同一主题「巴黎」分别用 Wan 3.0 和 Seedance 2.5 生成,两条都拍到了埃菲尔铁塔,配文让观众判断哪个更抓得住感觉,成片由 Higgsfield 平台制作。属于同题材双模型横评的短演示,可直观对比两家在氛围营造和镜头表达上的差异。
同一段巴黎、两个模型各出一版,官方直接摆出来比谁更有感觉。做视觉和分镜的可以拉片看两家在氛围和镜头感上的差别,选型时心里有个数。
点击打开原平台查看,能否访问取决于网络环境
06
@TanLuAI
作者「探路AI」发布视频版 Codex 保姆级教程,并说明制作方式:几乎没有使用剪辑软件,卡点、动画、标记几乎都由 Opus 5.5 完成;AI 视频片段由 AI 根据口播内容自行构思剧情,调用 2.0 fast 生成,全部用每日赠送积分一次生成,成本接近零。
一条把剪辑活儿交给 Opus 5.5 的实操样本:卡点、动画、标记基本不碰剪辑软件,AI 片段按口播内容自己编剧情、用 2.0 fast 一次生成。做口播教程和后期自动化的可以拆一下这套流程。
点击打开原平台查看,能否访问取决于网络环境
07
@vincent_ddup
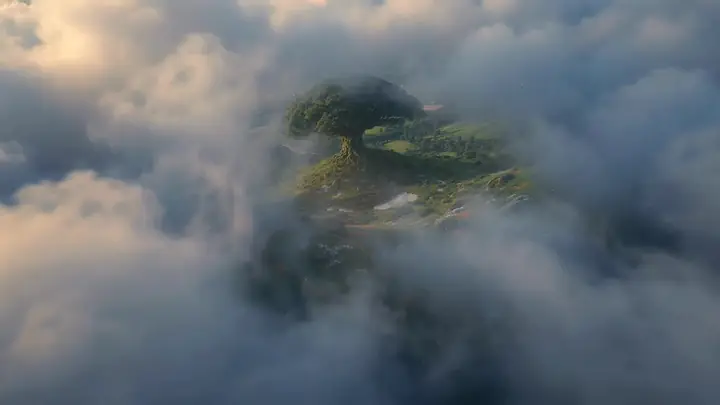
作者 @vincent_ddup 发布「ChatGPT × Muse」第二弹,作品名《世界之树》,以一张图片为起点做成微电影。分工是 ChatGPT 负责导演、分镜和音乐指导,Muse 负责视频制作,画面素材来自 @Alexvhyn 授权。作者称这是沿用上一弹的老流程。
一张图拆成导演、分镜、音乐指导再交给 Muse 出片,作者说这是第二弹、沿用同一套流程。想试单图生成短片的编导可以看他的分工思路。
点击打开原平台查看,能否访问取决于网络环境
08
@Gorden_Sun
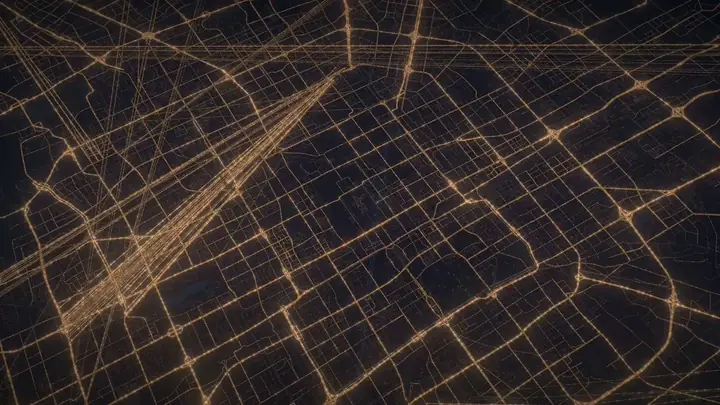
Gorden Sun 用一段长提示词直出北京历史介绍视频:要求以清华 CMAB 与 OpenStreetMap 数据构建北京 3D 城市作为画面主体,配 EdgeSpeak 男声讲解音频和中英双语高亮字幕,并按讲解内容穿插多种形式的中国艺术感画面,素材来源不限。作者称提示词「基本就是乱写」,走的是把需求一次性全交给模型的许愿式做法。
提示词全文公开,把 3D 城市、讲解配音、中英字幕、穿插素材全塞进一句话交给模型自己找料,想试「一句话出片」的编导可以照着改一版自己城市的。
点击打开原平台查看,能否访问取决于网络环境
09
@oran_ge
X 用户 Oran Ge 用 cola 作为 harness 对 DeepSeek 4.1 Flash 最新版做视频动效测试,耗时 12 分钟、总成本约 0.20 美元。作者评价价格不贵,但效果与 opus 5.5 仍有差距,模型自评 7.5 分(以 opus 原版为 10 分标准)。
个人实测:12 分钟、0.2 美元跑完一次视频动效,作者自评效果仍不及 opus 5.5。想压成本的团队可以拿这个数当参考,别指望它直接出片。
点击打开原平台查看,能否访问取决于网络环境
10
@AntLingAGI
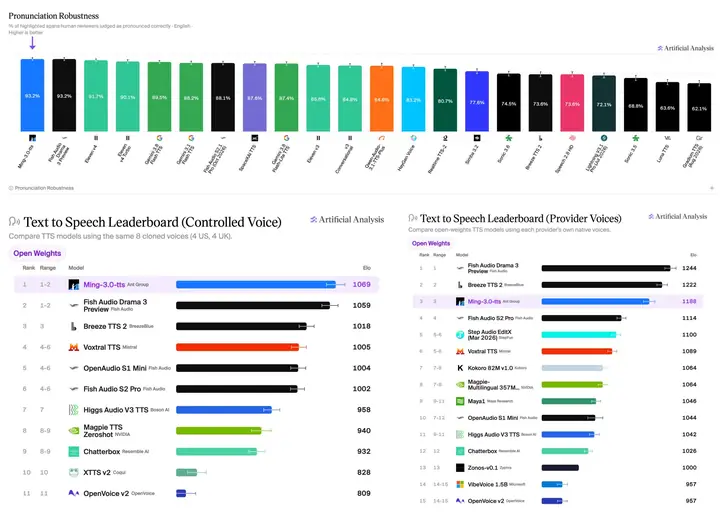
蚂蚁百灵(@AntLingAGI)发推感谢开发者 @AdinaYakup 分享 Ming-3.0,称其帮助更多开发者了解自家五款开源语音模型的可能性。推文本身是致谢性质,未展开模型参数、语言覆盖、音色能力或获取方式。
官方账号转发致谢,只提到有五款开源语音模型,没有参数、没有试听、没有接入方式,配音和声音方向的可以等实测出来再看。
点击打开原文,能否访问取决于网络环境