01
@fal
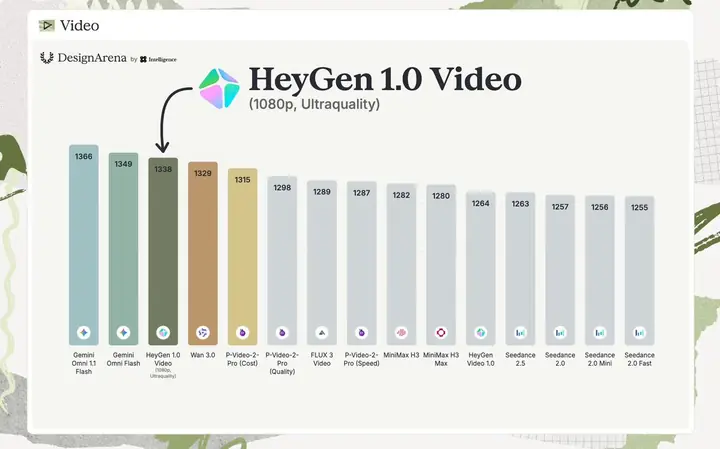
fal 与 Black Forest Labs 合作推出 FLUX 3 Max,是 fal 基于专为定制设计的 FLUX 3 模型适配优化后的版本。官方称生成 10 秒视频仅需 12 秒,图像生成视频能力并列第一,同质量下比 Seedance 2.5 快 22 倍,双方表示将继续合作。速度与图生视频质量是这条的两个核心指标。
10 秒视频 12 秒生成、同质量比 Seedance 2.5 快 22 倍,这组数字对批量出片的短剧团队是直接的成本账。做图生视频的可以接 API 跑一轮,看废片率和一致性扛不扛得住。
点击打开原文,能否访问取决于网络环境
02
@AntLingAGI
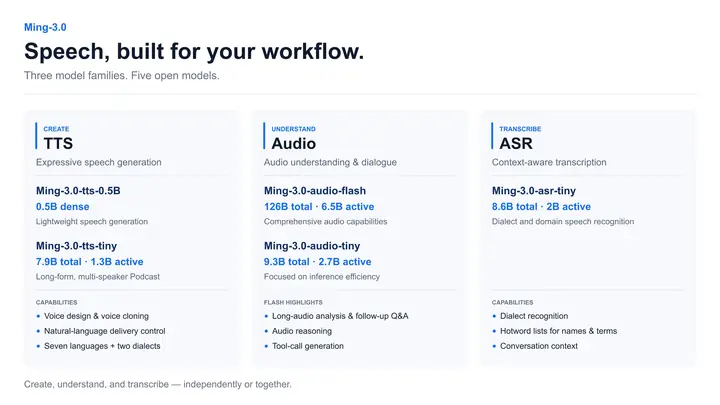
蚂蚁百灵开源 Ming-3.0 系列 3 个语音家族共 5 个模型:Ming-3.0-tts 含 0.5B 语音设计与副语言线索模型、7.9B 总参数 1.3B 激活的 Tiny 长语音模型;Ming-3.0-audio 含 Flash 126B 总参数 6.5B 激活的理解与工具调用模型、9.3B 总参数 2.7B 激活的 Tiny 对话模型;Ming-3.0-asr-tiny 为 8.6B 总参数 2B 激活的方言与上下文识别模型。TTS 支持七种语言加两种方言,ASR 支持热词列表与对话上下文。
TTS 支持七种语言加两种方言、还能用副语言线索控制语气,ASR 带热词表和对话上下文,做 AI 配音和短剧字幕的这周可以拉下来跑一遍。
点击打开原文,能否访问取决于网络环境
03
@ViggleAI
Viggle AI 发布 JST-2,自称全球首个全栈物理原生世界基础模型。与多数在像素/视频空间学习的世界模型不同,它把整个模型栈建在 3D 里,可在数秒内生成 3D 场景并实时扩展,并通过一个通用架构创建内置动作的角色。官方未给出参数规模、开放方式与价格。
不走像素视频路线,直接在 3D 里搭模型栈,几秒出场景还能实时扩展、角色自带动作。做分镜预演和场景搭建的可以盯一下实际出场景的稳定度。
点击打开原平台查看,能否访问取决于网络环境
04
公众号
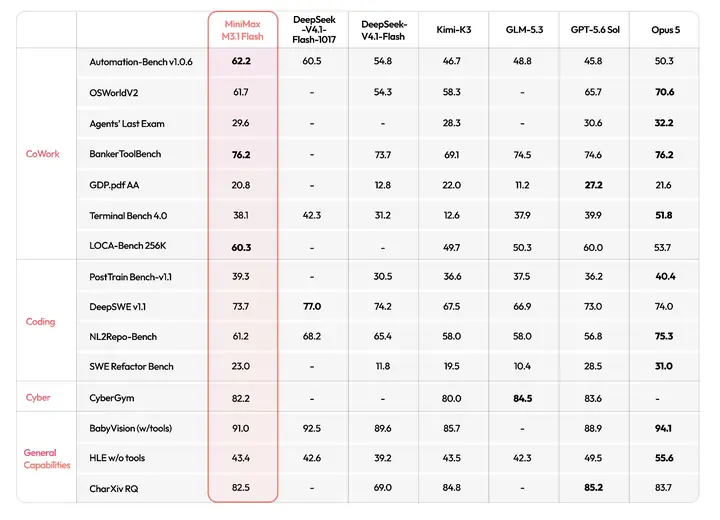
MiniMax 正式更新 M3.1 Flash,此前匿名处理超 200T Token 的 Space Bunny 即其早期版本。官方称推理提速近 3 倍、成本降低 70%,在 Agent 任务、编程、Computer Use 和网络安全上全面提升,DeepSWE v1.1 得 73.7%,OSWorld V2 得 61.7 分,CyberGym 得 82%,输出速度日常可达 200+ TPS。
Agent、编程、Computer Use 方向的模型更新,DeepSWE v1.1 得 73.7%、OSWorld V2 得 61.7 分,输出 200+ TPS。做创作自动化的技术整合者可以接 API 测一下调度稳定性,纯拍片的编导这条可以先放。
点击打开原文,能否访问取决于网络环境
05
公众号:火山引擎
中央广播电视总台在 10 月 18 日上海浦东全国中短剧大会上亮相《红色密码》《峨眉》两部中短剧,将与火山引擎合作探索真人实拍结合 Seedance 大模型的制作模式。这是火山引擎「Seedance 影视合作计划」的首个落地项目,该计划今年 9 月面向全球专业影视项目发布,提供 Token 补贴、宣发资源及技术与工具支持。
总台级别的中短剧项目正式接入 Seedance,还带 Token 补贴和宣发资源,做短剧的可以盯这个合作模式怎么落地。
06
@FanShifu
前字节团队推出的 AI 分镜 Agent Story2Board,核心是一层 Consistency Layer:角色长相、穿搭、标志性道具和场景固化成可复用对象,切全景特写都基于同一套资产生成。后台接入 250 部影史经典、27 万个镜头标注数据,用户用大白话描述剧情,它反推景别、轴线、仰俯角度和运镜方式并给出情绪动机。导出为带景别、角度、运镜、台词的 PDF 分镜表,导出不消耗点数。模型按需调用,免费层用便宜模型,正式交付调 Nano Banana Pro / 2,1 美元 = 100 点,点数不过期。
把角色、道具、场景锁进独立图层做一致性锚点,再用 250 部影史名片的 27 万条镜头标注反推景别和运镜,导出带场记数据的 PDF 分镜表。做广告和短片提案的编导可以拿自己的剧本跑一遍,看它推荐的机位靠不靠谱。
点击打开原平台查看,能否访问取决于网络环境
07
@sunra_ai
Sunra 发布 Sunra MCP,将多家主流图像、视频、音频模型集成进 Claude、ChatGPT 等已有 AI 助手内,官方称每款模型按其制造商原 API 价格计费、不加价,主打业内最具可负担性的定价。创作者可在对话界面里直接调用多模态生成模型,省去逐个平台切换和单独开户。
把主流图像、视频、音频模型打包进 Claude 和 ChatGPT 里调用,按各家原 API 价不加价,做多模型混剪和批量出图的可以接上去比一比实际账单。
点击打开原平台查看,能否访问取决于网络环境
08
@elevenlabs
ElevenLabs 宣布 Chroma Awards 第二季回归并开放提交,提供 100 万美元免费试用与推广额度,以及超过 45 万美元现金奖励和旅行福利,规模超过上一季。赛事与 CapCut、The Cantina、Runware 合作呈现。具体赛道设置、提交截止时间和评审标准未在原文中说明。
100 万美元试用推广额度加 45 万美元现金奖和旅行福利,CapCut、Cantina、Runware 联合呈现。做 AI 短片和短剧的团队可以拿现成作品去投,奖金和曝光都是实打实的。
点击打开原平台查看,能否访问取决于网络环境
09
NVIDIA Blog
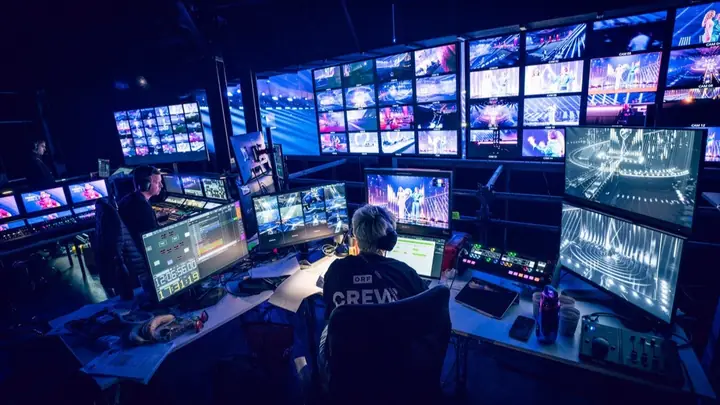
NVIDIA 在柏林创意产业活动上宣布,欧洲广播联盟(EBU)与其合作,把去年推出的主权标准扩展到主权云、开放模型和集成伙伴,明确广播机构部署智能体时对数据、基础设施、模型与安全的控制方式。EBU 覆盖 55 国以上 115 家成员机构、触达超 10 亿人。同场 Adobe Frame.io 宣布用 NVIDIA GPU 加速视频智能体检索,德国影视制作公司 UFA 已用它更快找到所需素材片段。
EBU 覆盖 55 国 115 家公共媒体,这次把主权云、开放模型和集成商拉进框架,Adobe Frame.io 用 NVIDIA GPU 加速视频素材检索已在德国 UFA 落地。做机构级内容、要过合规的制片方可以看这套部署口径。
点击打开原文
10
@c_valenzuelab
Runway 联合创始人 Cristóbal Valenzuela 发推称「Runway 现在已在 Grok 中」,并引用 Runway 官方账号同内容推文,称 Grok 将拥有制作任何内容所需的一切。推文未说明具体接入形态、可用模型、额度与地区限制。对常用 Grok 的创作者,这意味着多了一个在对话产品内直接调用 Runway 出片的入口,实际能力需自行试用确认。
Runway 官方确认已进 Grok,等于多了一个在对话产品里直接出片的入口。习惯用 Grok 的团队可以先去试生成路径和额度,看能不能省掉切工具的步骤。
点击打开原平台查看,能否访问取决于网络环境
01
公众号
公众号「卡尔的AI沃茨」实测 Lovart 2.0 新上线的个人设计 Agent Arti:能读取用户历史项目的审美记忆,生成中自动调研视觉方向、自主纠错,支持画布巡检,分享链接后可在画布上直接评论。文中用广东文创品牌和奶茶秋季海报两个项目验证记忆复用,并试运行了一个每日饮品节点的设计委托任务。Lovart 2.0 中文版已全量上线。
作者拿广东文创品牌和奶茶秋季海报两个项目验证 Arti 的审美记忆复用,还试跑了每日饮品节点的设计委托任务。做视觉和 KV 的可以看它怎么记住你的风格再自己往下做。
点击打开原文,能否访问取决于网络环境
02
@magnific
Magnific 官方发布一条创作流程分享:先由 Magnific One 生成一张图像,再围绕这张图构建一部短片,爱情题材,故事部分由 GPT-6 Astra 参与塑造,帖子附有完整过程与提示词。这条的价值在于「单图起手 → 反推叙事」的路径,适合研究如何用一张定调图锁定视觉方向后再展开剧本。
官方放出了从单张图到短片的完整过程和提示词,做 AI 短片前期开发的可以看它怎么用一张图定调、再让模型把故事撑起来。
点击打开原平台查看,能否访问取决于网络环境
03
@AlchainHust
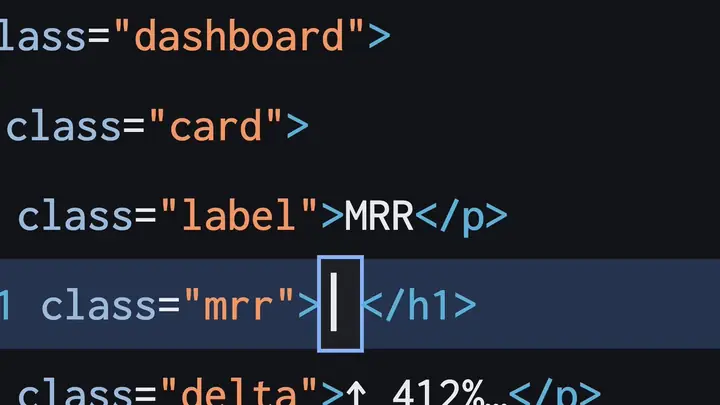
花叔(@AlchainHust)展示 huashu-motion 直出网站宣传片的效果,为 @marclou 的 trustmrr 做了一支宣传片,提示词仅输入网站链接。展示的是「给网址→出成片」这一极简输入路径,适合观察产品宣传片这类标准化内容的自动化程度。
只丢一个网站链接就出宣传片,做产品片和商业短视频的可以看看这个输入方式能省多少前期活。
点击打开原平台查看,能否访问取决于网络环境
04
@xdeconstructed
创作者 Nate(@xdeconstructed)称用 Voyager(@startvoyager)制作了一部短片,卖点是可以同时改剧本、走位、粗剪、声音设计和调色,顺序随意、灵感来了就改,不用从头重做,且能接上自己常用的桌面工具。片子是一个系列的第一部,讲一个男人凌晨 1 点买酸奶,撞上醉酒陌生人,几天后她的楼要被拆。作者声明非赞助,并称会用在客户项目里。
一位创作者用 Voyager 把剧本、剪辑、声音、调色放在同一条流程里随时改,不用推倒重来。做后期和剪辑的可以看看这种非线性改法能不能搬进自己的项目。
点击打开原平台查看,能否访问取决于网络环境
05
@_adishj
开发者 Adish Jain 称团队内部已实现「视频 AGI」,新视频 Agent 仅凭两句提示一次生成一支关于 @garrytan 的视频,包含全部 B-roll、字幕、动态图形和素材检索,作者称自己未做任何剪辑。产品尚未发布,原文仅写「coming out soon」,无模型名、无参数、无成片链接。
作者称新视频 Agent 用两句提示一次生成含 B-roll、字幕、动态图形的完整视频,且未做任何剪辑,但产品尚未上线。做后期和批量出片的可以先记下这个方向,等上线实测。
点击打开原平台查看,能否访问取决于网络环境
06
@wshuyi
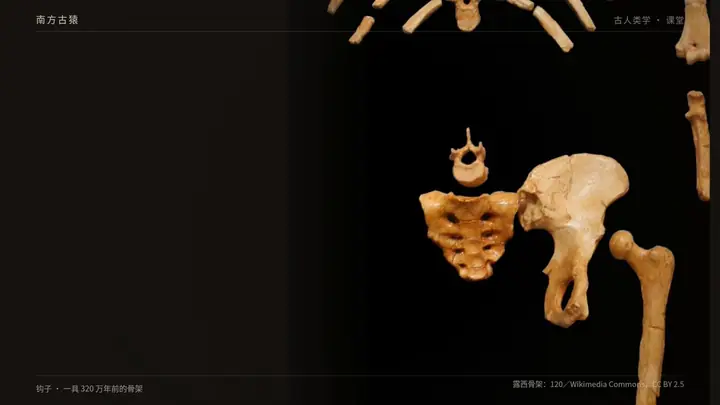
博主 @wshuyi 称此前用 Claude Code 搭配 Opus 5.5 做视频,这次改用 DeepSeek Harness 加最新版 DeepSeek 4.1 Flash 1017 版做了一条短视频,自评效果与 Opus 有差距,但验证了纯国产模型以动画形式做科普视频这条路可行。
同一个人用 Claude Code + Opus 5.5 做过一批视频,这次换成 DeepSeek Harness 加国产模型跑同一条路,结论是效果有差距但动画科普能走通。想压低成本的团队可以照这个组合试一轮。
点击打开原平台查看,能否访问取决于网络环境
07
@MeshyAI
Meshy 官方账号发布一条演示:在 Meshy 中生成并贴图沙发、浴缸、购物车等模型,再导入 Blender 搭建「全部起飞」的场景。展示的是 AI 生成三维资产与 Blender 场景搭建之间的衔接用法,成片为短演示片段。
Meshy 官方演示的一条小工作流:沙发、浴缸、购物车在 Meshy 里生成并贴图,再进 Blender 摆场景做动画。做三维资产和场景搭建的可以看看这个衔接方式。
08
@XRarchitect
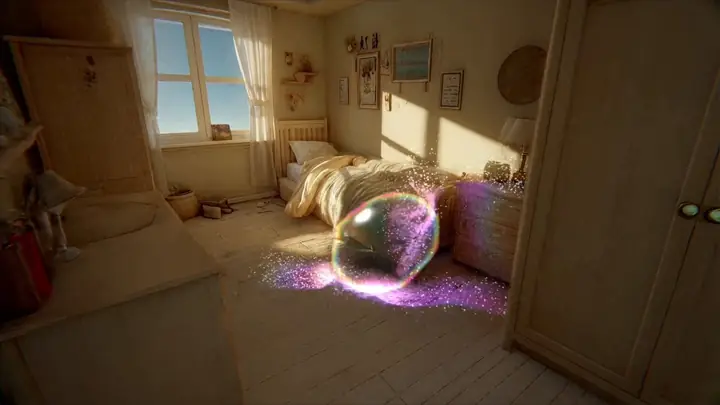
开发者 Ian Curtis(@XRarchitect)发布演示:用 WebGPU 在高斯 splat 构建的场景中实现实时传送门跳跃,带声音,World Labs 官方账号转帖。演示展示了 splat 场景的实时漫游与空间切换效果。
高斯 splat 场景里做实时传送门穿越,带声音,World Labs 转帖。做虚拟场景和空间叙事的可以看看这种实时漫游的接法。
点击打开原平台查看,能否访问取决于网络环境
09
@dashiAIxz
博主「大师的AI小灶」发帖称这是近期看过最惊艳的 AI 作品,作者为抖音账号 MetaAI,认为其风格参照了《椒麻堂会》,并评价故事调度、细节巧思和艺术表达都属顶级。帖子本身未附作品画面或链接。
只有一句观感和作者名,没有作品链接也没有画面,编导和视觉师想拉片也无从下手,这条先放过。
点击打开原平台查看,能否访问取决于网络环境