01
@OpenAI
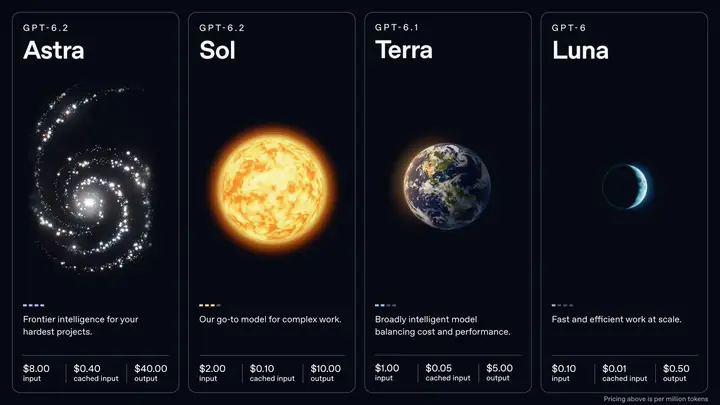
OpenAI 发布 GPT-6.2 Astra 与 Sol 两款模型,即日起面向 Plus、Pro、Enterprise、Edu 用户开放,可在 ChatGPT Work 和 Codex 中使用,开发者可通过 API 调用 gpt-6.2-astra 与 gpt-6.2-sol。Pro 500 订阅者可对两个模型启用 Ultrafast,该能力也首次向 Pro 200 订阅者开放,从 GPT-6.2 Sol 开始。
两个新模型同时上线 ChatGPT Work、Codex 和 API,Pro 500 还能用 Ultrafast 提速,做剧本批量处理和 Agent 工作流的可以接 API 跑一轮看稳不稳。
点击打开原平台查看,能否访问取决于网络环境
02
公众号
快手可灵 AI 发布图像创作模型 Kling Image 4.0,已全量上线并面向企业客户与开发者开放 API。采用「理解生成统一」架构,首次支持原生 8K 图像生成,内置 110+ 种预设影调风格和 70+ 种商用字体,支持最高 15000 tokens 文本输入、单图最多生成 2000 字,一次描述可生成最多 10 张风格连贯的组图,以及电商详情页等超长画幅长图。
原生 8K、一次出 10 张风格连贯组图、内置 110+ 影调风格,做 KV 海报和电商长图的视觉师这周可以拿自己的项目跑一遍看一致性。
点击打开原文
03
Microsoft AI
Microsoft AI 发布首个语音到语音模型 MAI Realtime 1,起步价 $0.01 每分钟音频。官方称其在 Big Bench Audio 和 τ-Voice 两项基准上,质量、速度、价格均超过 GPT Realtime 2.1。语音到语音意味着输入输出都是音频,不经文本中转,适合实时对话类场景。
微软首款语音到语音模型,每分钟音频 $0.01 起,官方称在 Big Bench Audio 和 τ-Voice 上质量、速度、价格都压过 GPT Realtime 2.1。做 AI 配音、虚拟角色对话、实时字幕的可以接 API 跑一周比价。
点击打开原文
04
@arena
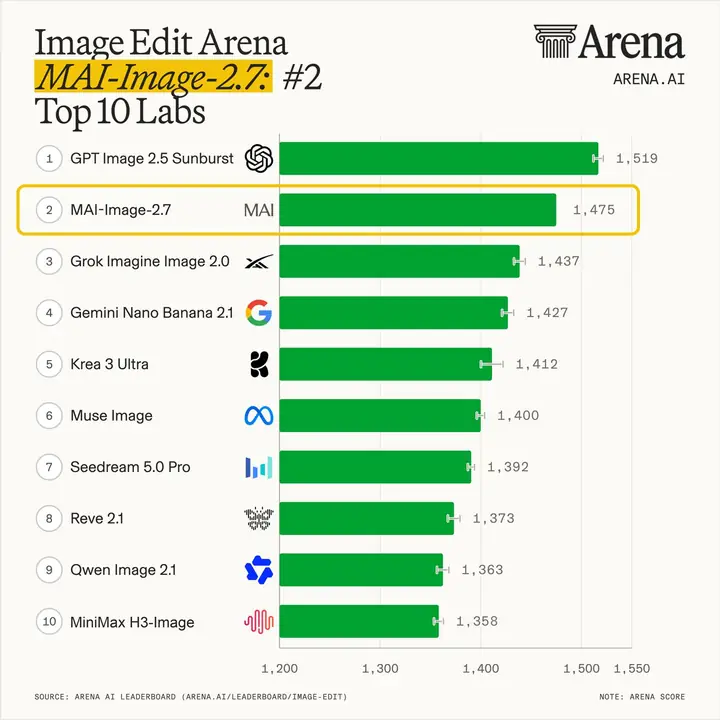
微软 MAI-Image-2.7 结束预览正式上线,在 Arena 三个图像榜上综合排到第 2 名实验室,定价每张 0.035 美元,处于性价比前沿。具体名次为多图编辑第 3、单图编辑第 4、文生图第 4,整体比 2.6 版高约 50 分。涨幅集中在单图编辑:写实电影感从第 8 升到第 3,文字渲染从第 13 升到第 4,产品/品牌/商业设计从第 10 升到第 4,3D 建模从第 9 升到第 4,人像从第 9 升到第 4,卡通动漫奇幻从第 11 升到第 5。
单图编辑从第 8 冲到第 3、文字渲染从第 13 到第 4,每张 0.035 美元。做海报、产品图和 KV 的视觉师可以拿同一批 prompt 跟现用模型对跑一轮。
点击打开原文,能否访问取决于网络环境
05
@magnific
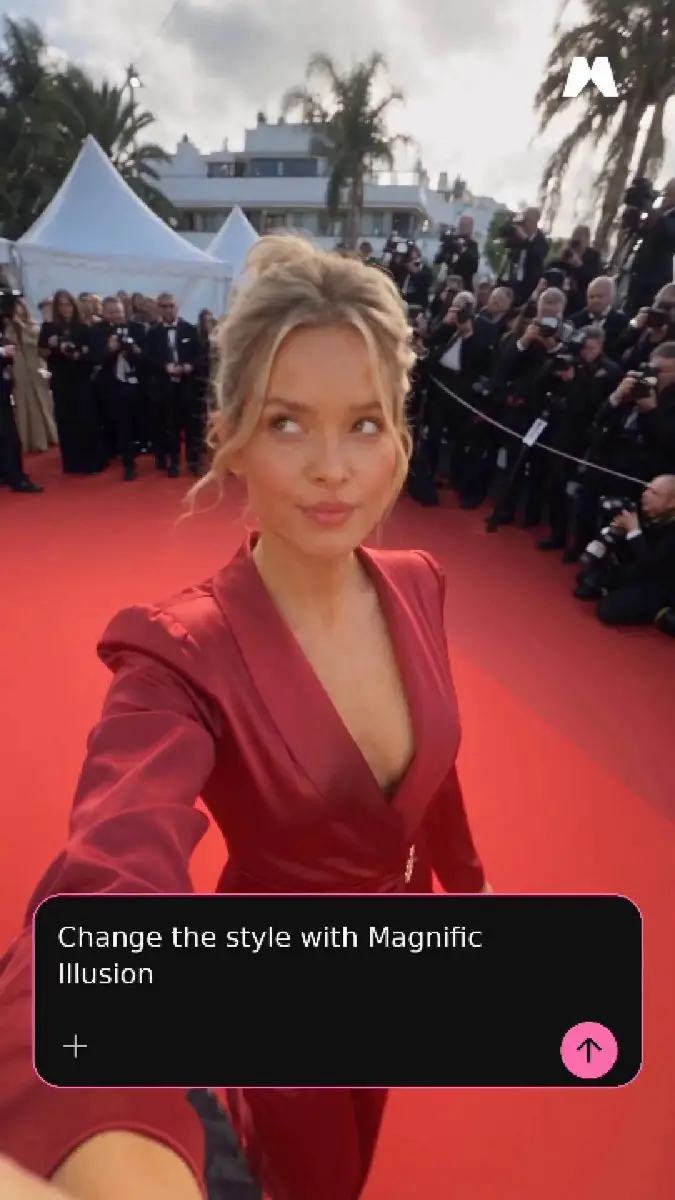
Magnific 发布 Illusion,输入任意视频即可替换其中的人物、服装、产品或整体外观,底层由 Seedance 2.5 提供支持,已在 Magnific 网页端、MCP 接口以及桌面端和移动端 App 上线可用。对后期和视觉团队来说,这是把已有素材直接改人改装的路径,短剧补拍、广告换产品、旧片翻新都可以先拿一段素材试稳定性。
拿现成视频换人、换衣服、换产品、换整体风格,底层是 Seedance 2.5,网页、MCP、桌面和手机端都能用。做后期替换和短剧补拍的可以拿一段旧素材试改,看人物和服装能不能稳住。
点击打开原平台查看,能否访问取决于网络环境
06
@perplexity_ai
Perplexity 发布 Orchestrator API,可按任务选择合适模型,并基于可用性、容量和延迟自动选择提供商。开源权重模型与专有模型统一在一个 API 中接入,计费统一。对需要在一个流程里串多个模型、又不想分别对接各家账号和账单的技术整合者,这套接口把选模型和换供应商的事收进了一层。
一个 API 里同时接开源权重和闭源模型,按可用性、容量、延迟自动换供应商,账单还统一。自己搭批量生成流程的技术整合者可以接进去测一周,看切换模型时省不省事。
点击打开原平台查看,能否访问取决于网络环境
07
@JensenHuang
黄仁勋在 X 发文,称过去一周收到朋友、业界同仁和陌生人的支持,感谢表达善意的人。他提到 53 年前来到美国、成为美国公民是人生最自豪的时刻之一,英伟达是他的毕生事业。他承认未达到英伟达对每个人的标准、个人生活犯了严重错误,给董事会制造了问题,表示完全认错并配合董事会独立调查。他称离职后收到员工、投资人、合作伙伴和客户要求他回归 CEO 的呼声,若董事会认为回归符合股东、员工、公司和美国利益,他愿意回归。
英伟达人事风波当事人自述,跟 AI 创作工作流没关系,做片子做短剧的可以直接划过。
08
@OpenBMB
面壁智能 OpenBMB 转发社区开发者 @kadirrbrtt 基于 VoxCPM2 声音克隆做的本地优先视频配音工具 VoxaDub,流程覆盖转录对齐(可选说话人分离)、本地 Hy-MT2 上下文翻译、VoxCPM2 语音合成、时长适配,以及与原始背景音合成,唇形同步作为可选独立步骤。对做译制、多语种发行和短剧出海的后期团队,这是一条从原片到配音成片的完整本地流程参考。
转录对齐、翻译、克隆配音、时长适配、混回背景音一条流程走完,唇形同步还能单独开关。做译制短剧和海外发行的后期,这套本地跑的流程值得扒下来试。
点击打开原平台查看,能否访问取决于网络环境
09
@vista8
向阳乔木(@vista8)介绍开源项目 SubCast:支持搜索订阅国内外播客节目,用本地 ASR 模型转写无字幕音视频,支持本地 CLI 和 API 配置的 LLM 问答,另有 AI 导读、时间戳跳转、金句海报、收听统计,授权后可一键导入 YouTube 订阅频道,下载地址在评论区。
本地 ASR 转写无字幕音视频,还能出 AI 导读、时间戳跳转和金句海报,项目开源。做后期和字幕的可以拉下来跑一遍,看转写准不准、能不能接进自己的流程。
点击打开原平台查看,能否访问取决于网络环境
10
GitHub Trending (AI)
GitHub Trending 上出现一个名为 GitHub-Copilot-app 的仓库,描述为 agent-native 桌面客户端,用于在多个 GitHub 仓库间查找、运行、调度并落地软件工作。定位是开发者写代码的桌面入口,不涉及图像、视频、音频的生成或编辑能力。
编程工具的桌面客户端,跟拍片剪片不搭边,做创作自动化的可以路过。
01
@SUOHA_AI
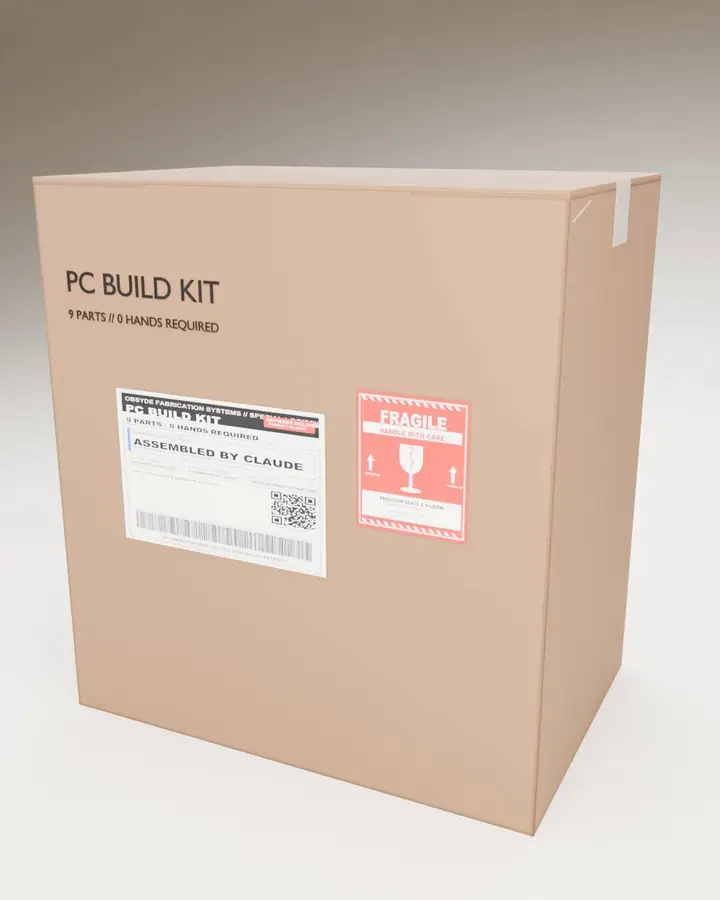
作者用 Gemini 4 Carbon 编写纯 Python 代码,在本地 Mac mini M4 上驱动 Blender Cycles 光线追踪,生成一支 35 秒 60 帧的 3D 电脑装机动画。全片 2100 帧共 7722 行代码,从零生成耗时约 4 小时,未使用视频生成模型,未下载外部 3D 模型、贴图或音效,全程未打开 Blender 界面。作者自评总体表现略弱于 Opus 5.5 和 Fable 5.2。
不抽卡、不开 Blender 界面,纯 Python 代码在本地 Mac mini M4 上跑 Cycles 出 35 秒 60 帧 3D 动画,做三维和产品演示的可以看这条思路。
点击打开原平台查看,能否访问取决于网络环境
02
@Cara_Mosquito
作者针对字节 11 月 9 日发布的 Seedream 5.5 做实测,官方宣传点是同一张图连续改 100 轮、未指定修改的区域像素级保持。作者用影视人的办法逐像素叠图对比,跑了 6 轮,结论是各模型各有所长。做视觉开发、角色一致性和 KV 修改的可以看这套验证方法,判断局部重绘能不能直接用在成片素材上。
字节说同一张图连改 100 轮、没让改的地方像素级不动,作者用影视人的办法叠图验了 6 轮。做视觉开发和 KV 的可以看这套验证思路,自己拿素材复一遍。
点击打开原文,能否访问取决于网络环境
03
@ashebytes
X 用户 @ashebytes 称自己提前拿到了 OpenAI 全新 GPT-6.2 Astra 的访问权限,过去几周把它当作主要的智能视频剪辑助手使用,并表示会分享一些使用感受和自己风格的 AI VFX 作品。
个人提前试用体验,只说了「几周来当主力剪辑助手」和会附上自己风格的 AI VFX,没有参数和流程。做后期的可以留意这条,但别指望能抄到具体做法。
点击打开原平台查看,能否访问取决于网络环境
04
@aiwarts
作者把 Anthropic 常驻智能体指南的五个组件——事件收件箱、定时器、记忆、权限、发件箱——翻成一段提示词写进自己的 Grok Bot,专治定时任务空转浪费额度:要求按任务 ID 和内容版本去重、无实质变化只回「无更新」、不自行扩充来源或新建任务。稳定跑三天后,空跑从每周约 18 次降到 3 次,总用量从 75% 降到 55%,一年省 840 美元。
把 Anthropic 那份常驻智能体指南拆成五个组件写成一段提示词,塞进自己的 Grok Bot 治定时任务空转,空跑从每周 18 次降到 3 次。自己搭自动化流程、被额度烧得心疼的可以照着改一版。
05
@poteto
xAI 的 Lauren Tan 介绍 Grok Bot 的用法:通过 connectors 给越多上下文它越强;建议用语音口述约 10 分钟,像带新员工一样把工作流讲清楚,发送前让 bot 用自己的话复述确认,并提到可让它连接常用工具、保存自身技能以精确复现流程。
把带新人的那套讲法搬给 AI:语音口述十分钟讲清流程,发出去前让它复述一遍确认,再让它存成技能反复用。做制片和统筹的可以拿这套方法管自己的杂事。