01
公众号
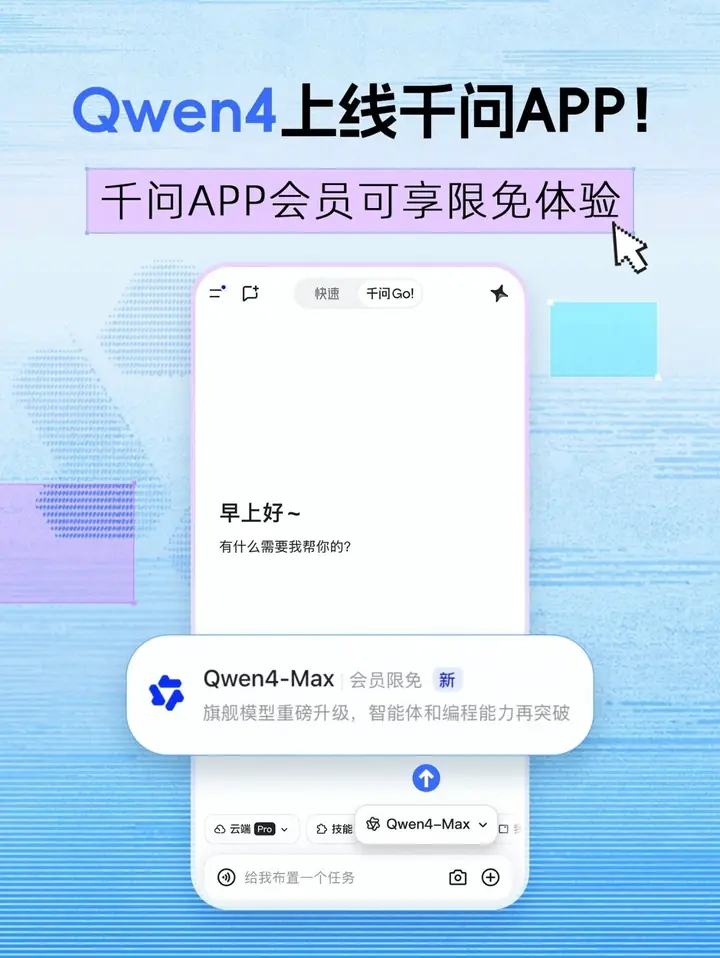
阿里巴巴 11 月 16 日发布新一代基座大模型 Qwen4-Max,总参数 2.4T,具备原生视觉能力,支持百万上下文。官方称基于新架构和训练优化,在智能体和编程等关键能力上持续进化,可在金融、法律等专业领域从信息检索走向专业交付。上线期间千问 APP 会员限免体验,使用 Qwen4-Max 不消耗会员额度。
2.4T 参数、原生视觉、百万上下文,官方主打的是智能体和编程能力,不是出片。做剧本长文拆解、资料检索的编导可以拿千问 APP 限免期试一轮,指望它改画面的这周不用点。
点击打开原文
02
多平台
WorkBuddy 接入腾讯混元 Hy4 同日在 4 个第三方平台上线可用:Tencenthunyuan / 腾讯混元 / 公众号 / AIHOT 全部动态。
WorkBuddy 接入腾讯混元 Hy4 当天在这 4 个平台都能用上,按手上已开通的账号挑一个直接测,不用等单一渠道。
点击打开原文
03
OpenAI Blog
LVMH 媒体部门与 OpenAI 宣布战略合作,双方称将用 AI 支持新闻业,并让 LVMH 旗下出版物通过 ChatGPT 更易被访问。合作的具体工具、落地形式与时间表均未在公告中展开。对做品牌片、商业内容的团队来说,这是甲方侧的内容分发动向,暂不涉及创作工具或制作流程。
奢侈品集团的媒体板块和 OpenAI 牵手,方向是让旗下刊物通过 ChatGPT 更好触达读者。做品牌内容、商业影像的可以留意这类甲方侧动向,跟拍片工作流本身关系不大。
04
404 Media
404 Media 调查发现,音乐人 Samantha Shokin 的公有领域保加利亚民歌翻唱在 YouTube 被 Media Nov Records 发起版权投诉下架,两次申诉均被自动驳回,找不到人工客服。追查后她发现对方运营着 500 个 AI 灌水频道,正利用 YouTube 自动版权检测系统批量投诉。还被多位电子音乐人采样。
500 个 AI 灌水频道靠自动版权系统反咬真人创作者,申诉两次全被机器驳回。做原创音乐和配乐的该看看这套机制怎么被钻空子。
点击打开原文
05
多平台
阿里发布 同日在 3 个第三方平台上线可用:OpenRouter / OpenRouter 可直接调用 / Vercel AI Gateway。
阿里发布 当天在这 3 个平台都能用上,按手上已开通的账号挑一个直接测,不用等单一渠道。
06
@elevenlabs
ElevenLabs 宣布日本语音 AI 实验室 Kotoba(@Kotoba_tech)团队加入公司,Kotoba 的日语语音研究将并入 ElevenAgents,目标是让更多企业用日语自然地服务客户。Noriyuki Kojima、Jungo Kasai 等团队成员一并加入。对做日语配音、出海内容本地化和语音 Agent 的团队来说,这是 ElevenLabs 日语能力补强的信号。
ElevenLabs 把日本语音 AI 实验室 Kotoba 整个团队收进来,日语语音研究直接并进 ElevenAgents。做日语配音、出海短剧和客服语音的后期可以留意后续模型更新。
点击打开原平台查看,能否访问取决于网络环境
07
@ArtificialAnlys
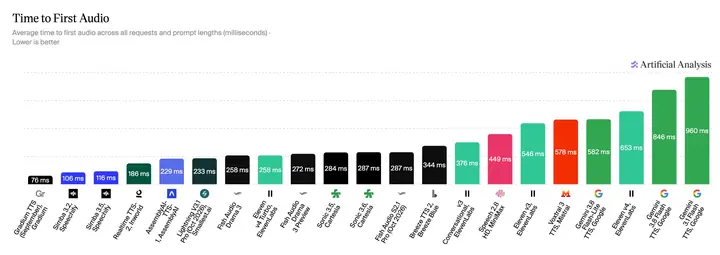
Artificial Analysis 推出 Time to First Audio 基准,专门衡量 TTS 模型从输入到开始发声的延迟,参评模型跨度从 76 毫秒到接近 1 秒。此前该机构的语音评测多集中在音质与自然度,这次把响应速度单列成榜。做实时配音、虚拟角色对话、直播数字人的团队可据此挑选低延迟模型。
TTS 开始发声的速度被单独拎出来排名,快的 76ms、慢的近 1 秒。做 AI 配音和虚拟角色实时对话的,选模型时多一个可查的硬指标。
点击打开原文,能否访问取决于网络环境
01
@shengtang135754
作者麦麦提(@shengtang135754)复盘自己此前作品《微光同行》的制作过程,以「手把手」形式讲手绘绘本风视频怎么做,开头先列出需要准备的几样东西(原文提到 Google 相关工具,具体清单需看正文)。适合想复刻温暖手绘质感的创作者对照流程走一遍。
作者把自己做的《微光同行》拆成步骤讲,从准备工具到成片一路走完,做绘本风、治愈系画面的视觉师可以照着跑一遍。
点击打开原文,能否访问取决于网络环境
02
Luma AI Blog
Luma 官方博客拆解画布智能体的做法:把 Orca 主智能体的视野扩展到画布对象及其相互关系,让它能读懂参考图、生成变体、笔记、画框分组之间的对应。子智能体 Laya 负责画布整理,例如把多条广告方向连同各自参考图并排铺开供审阅,布局代码负责校验并落地改动,人可同时在画布上继续工作。
Luma 官方讲 Orca 怎么把整理画布的活交给子智能体 Laya,以及布局代码怎么边改边不打断人。自己搭 AI 创作流程的技术整合者可以看它怎么把「素材和参考的对应关系」变成机器能读的结构。
点击打开原文
03
Latent Space
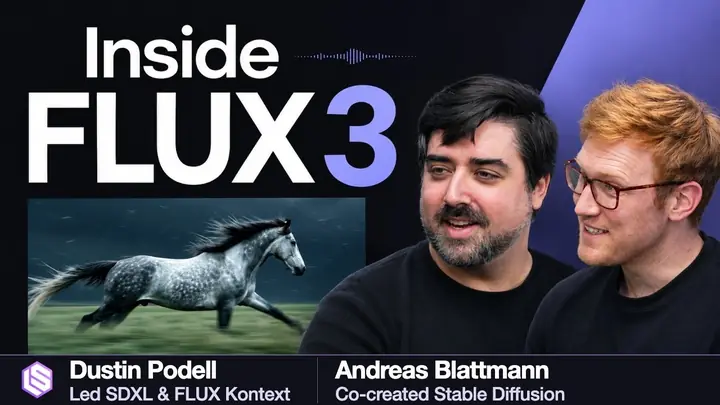
Latent Space 访谈 Black Forest Labs 的 Andreas Blattmann(Latent Diffusion 共同发明人)与 Dustin Podell,围绕 FLUX 3 谈视觉智能的构建思路。Andreas 用接球举例:手在球到达前就开始移动,这种知识写不成轨迹公式——静帧只能显示球在哪,视频能显示它怎么到那,撞击声能补上镜头没拍到的接触瞬间,这是 BFL 转向视频与世界模型的论据。访谈还提到 Stability AI 解体后核心团队在 Anj Midha 帮助下独立成立 BFL,并做出 Flux 系列图像模型。
BFL 两位核心讲清了从图像到视频的判断依据:静帧告诉你球在哪,视频告诉你球怎么到那,声音告诉你何时撞上。做视觉开发和分镜的可以听他们怎么定义「视觉智能」。
点击打开原文
04
@arena
Arena 宣布 Qwen4-Max 进入竞技场,并放出 Peter Gostev 的实测视频,在 3D 场景(金门大桥、体素罗马、把画作转成 3D 世界)、小游戏、创意场景与运镜、网页设计与可用性、交互讲解(闪电、Enigma 密码机)等题目上,与 Opus、GPT、Kimi、Fable 的输出逐项对比,提示词放在推文串里。视频末尾还讨论了定价尚不明确的问题。
Peter Gostev 拿 Qwen4-Max 跟 Opus、GPT、Kimi、Fable 逐项对打,3D 场景、小游戏、网页设计、交互讲解都有,提示词在推文里。想换模型做前端和 3D 原型的可以按章节挑着看。
点击打开原平台查看,能否访问取决于网络环境
05
Luma AI Blog
Luma AI 博客发文盘点 AI 电影生成器的选型维度:成片分辨率最高 4K、部分工具支持原生音频、从剧本解读到分镜生成再到修改的完整流程、跨场景角色一致性依赖参考图与多关键帧控制、多模型工作区可免切换平台对比效果、以及高质量导出格式与调色剪辑软件对接。文中提到 AI 影片已进入电影节展映、House of David 等制作把 AI 纳入专业流程,美国版权局也在审视 AI 辅助作品与人类作者身份的边界。
厂商博客的选型清单,把 4K 输出、原生音频、角色一致性、多模型工作区、调色与剪辑软件对接这几条列成评估维度,做 AI 短片前期选工具时可以拿来当对照表,别指望有实测数据。
点击打开原文
06
@don_tech1
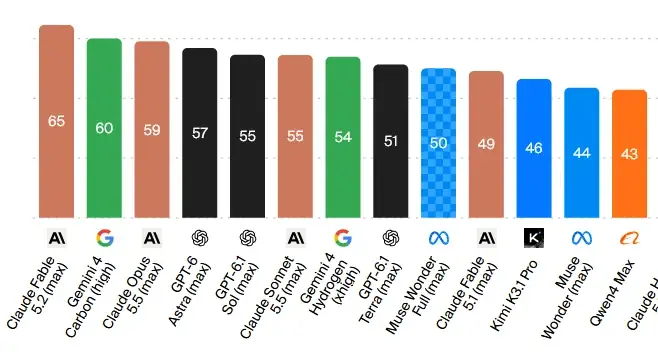
博主 @don_tech1 点评 Qwen4 Max 发布后的舆论翻车:上一代 Qwen 3.8 Max 评分 34 分、单次任务成本 10.02 美元,这代涨到 43 分、成本降到 3.27 美元,性能涨近 30%、推理成本降近 70%。但对比 Gemini 4 Carbon 60 分、Claude Opus 5.5 59 分、GPT-6.1 Sol 55 分,Qwen4 Max 排在第 38 名,2.4T 参数加 Max 后缀带来的高预期落空。
一条关于 Qwen4 Max 命名的吐槽帖:评分 43 分排 38 名,但单次任务成本从 10.02 美元降到 3.27 美元。跑 API 算成本的团队可以看看这组数字,拍片的不用凑热闹。
点击打开原文,能否访问取决于网络环境
07
@cfenghub
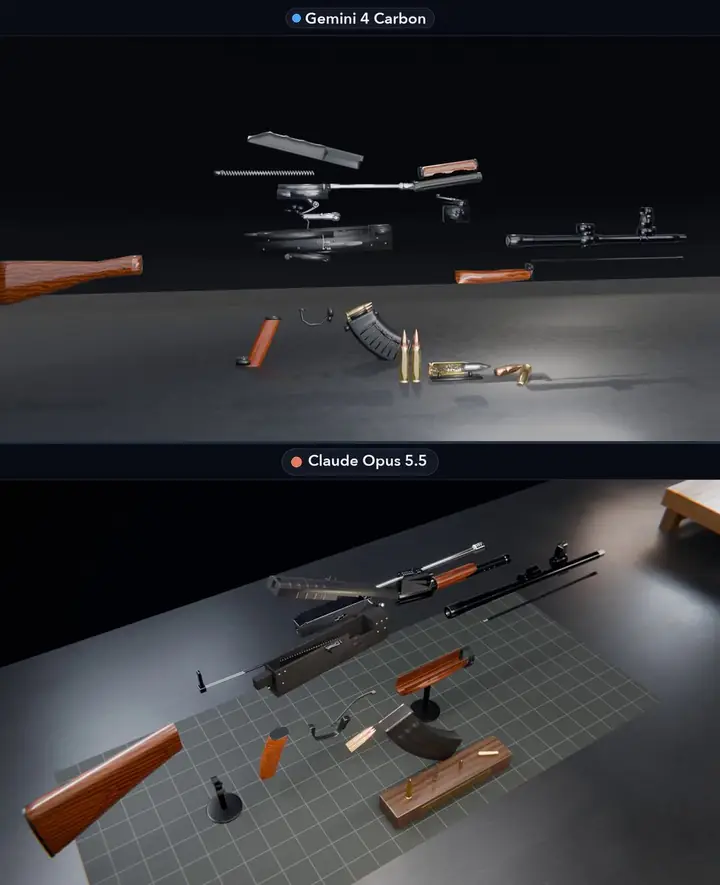
作者用同一条提示词、零外部 3D 模型,让 Gemini 4 Carbon 与 Claude Opus 5.5 分别写 Python 驱动 Blender 生成 AK47 组装动画。Gemini 4 Carbon 出的是正面平视视角,复进簧、弹匣、子弹等零件全部拆出;Claude Opus 5.5 则切到俯拍斜视角,零件拆得工整,并主动补上带网格的工作台切割垫、底座支架和木质子弹座。作者据此认为 Opus 5.5 在主动补全场景氛围和审美直觉上更强。
同一条提示词、零外部 3D 模型,让两个模型各写 Python 驱动 Blender 出一段 AK47 拆装动画,差别在镜头选择和场景补全——Opus 5.5 自己加了切割垫、支架和木质子弹座。想比较模型「审美直觉」的可以看这段对照。
点击打开原平台查看,能否访问取决于网络环境