01
@MiniMax_AI
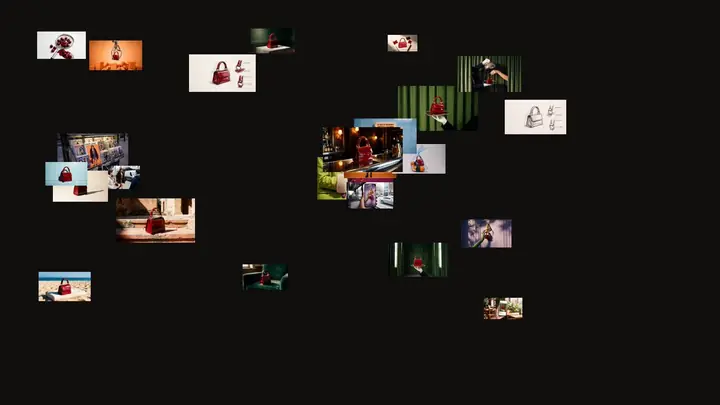
MiniMax 官方演示开放权重模型 H3 Image 的电商与广告用法:从草图或产品图出发,一次生成棚拍、生活方式等多场景且画面保持一致的成套图。据其引用的 @eachlabs,该模型约 10 秒生成原生 4K 图像,任意长宽比下最高 16MP,支持最多 16 张参考图,可精准编辑添加或替换物体、渲染文字、信息图与 UI 版式,现已在 each::labs 可试用。
从草图或产品图一次出棚拍到生活方式的成套广告图,每张场景还保持一致,做电商视觉和 KV 的这周可以拿自己的产品图跑一轮看废片率。
点击打开原平台查看,能否访问取决于网络环境
02
@fal
fal 发布 ChatGPT 插件,把图像和视频生成能力接进 ChatGPT 对话,用户不离开对话界面就能用其平台上的模型生成、编辑和迭代创意素材,覆盖从概念到成品的流程,安装入口在 openai.com/business/plugins/fal/。对做视觉开发和分镜预演的创作者,意味着可以在同一个对话里反复改图改片,省掉在聊天和生成工具之间来回切换的动作。
在 ChatGPT 里就能调 fal 上的模型出图出片、边聊边改,做分镜草图和视觉迭代的可以装上试一轮,看它能不能替掉来回切工具那一步。
03
X
Google 在 Gemini API 上线 Gemini Decision 1 决策模型,每百万输入 token $0.10 且无额外费用,原生支持图像、音频、视频和 PDF,256K 上下文窗口,可回答 1K 个问题,API 可免费试用。Google Labs VP Josh Woodward 转发称团队常用它构建应用,附图基准显示 JeeBench 92.2%、MMAU 71.8% 等项领先对比模型。
多模态输入加 256K 上下文,价格压到每百万输入 token 一毛钱,做工具链的可以接 API 试它能不能替掉一层规则判断。
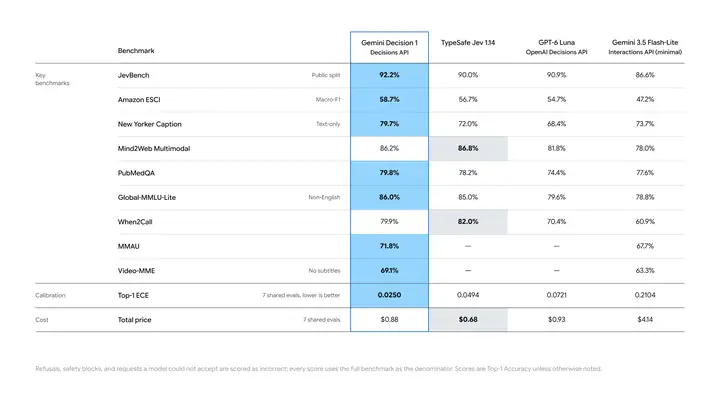
点击打开原文,能否访问取决于网络环境
04
Google AI Blog
Google AI Blog 发布 Gemini Decisions API,由新模型 Gemini Decision 驱动,官方定位是「快速、校准过的多模态判断」。原文只给出这一句产品定位。
Google 官方上线 Decisions API,主打多模态「快速判断」,但原文只给了定位没给参数和用例。做自动化筛选、批量打标的可以点开看接口形态,纯拍片的先放一放。
点击打开原文
05
Hacker News (Top)
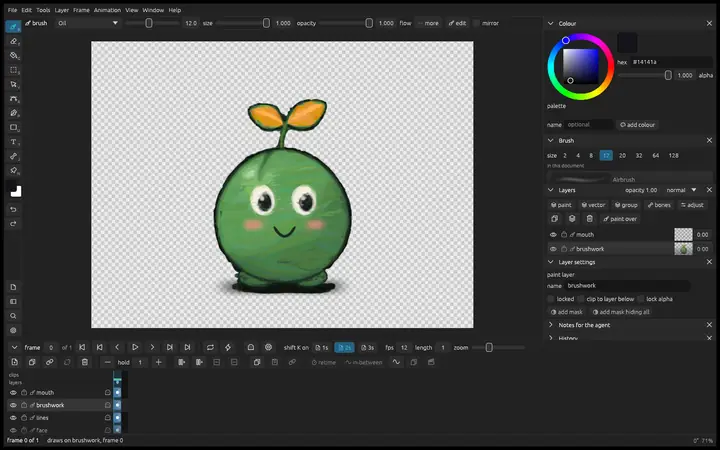
Klad 是一款 2D 绘画与动画应用,人和编码 Agent(Claude Code、Codex 等能跑命令的)共用同一张画布:人用笔在编辑器里画,Agent 通过命令行用同一套笔刷画,双方实时看到对方笔触。应用内没有图像模型,Agent 决定画什么,Klad 提供笔刷、图层和时间轴。落下的每一笔都保留为带路径、压感、笔刷、颜色的笔画,形状保留控制点,填充保留区域,可单点修改而非重抽。示例中 Agent 为「小芽生物」画了 4344 个笔画与填充,随后把角色拆成五组、205 个关键帧做成动画,未重绘任何一帧。示例图由 Claude Fable 5.2 经命令行逐笔绘制。源码可见授权,年营收 50 万欧元以下公司及个人可免费使用,运行于 macOS。
Agent 通过命令行在同一张画布上落笔,笔触带路径、压感、笔刷和颜色,改哪片叶子就改哪片,不用重抽。做角色设定和道具图的可以试它跟 Claude Code 配合出图。
点击打开原文
06
@demishassabis
Google DeepMind 的 Demis Hassabis 宣布发布 DNA 序列模型 AlphaGenome 2,可预测 DNA 变异在不同特定细胞类型中的影响,用于理解复杂疾病,已通过 API 向学术研究开放,文档地址 alphagenomedocs.com。这是生命科学方向的科研模型,不产出图像、视频或音频内容,与影视创作流程无交集。
基因组学研究模型,预测 DNA 变异对特定细胞类型的影响,已通过 API 向学术研究开放。跟影视创作没关系,编导和短剧团队直接跳过。
点击打开原平台查看,能否访问取决于网络环境
07
@OpenRouter
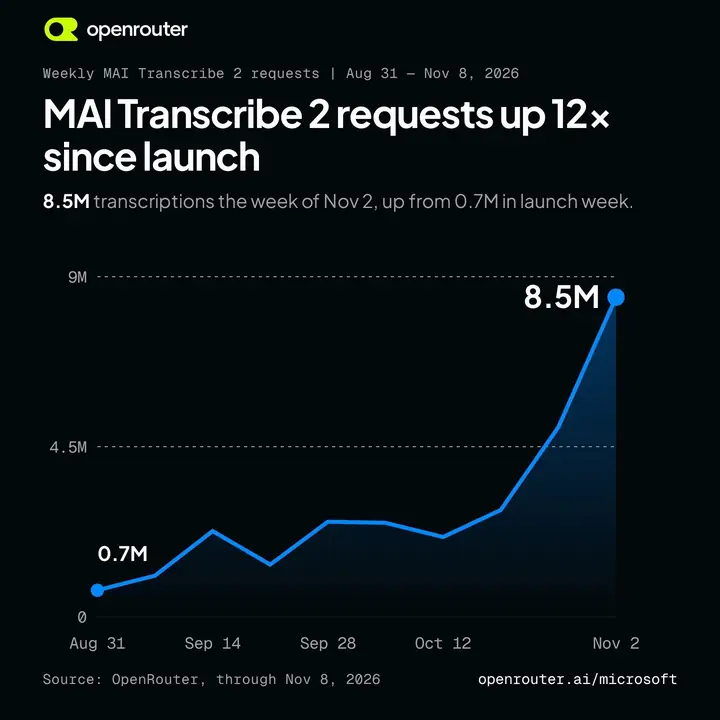
OpenRouter 公布数据:MAI Transcribe 2 上线以来请求量增长 12 倍,上周完成 850 万次转写,9 月上线首周为 70 万次;同期整个语音转文字类别的请求量增长 3 倍。榜单页 openrouter.ai/rankings/transcription 可查各转写模型的实际调用排名。对做字幕、配音对轨、长素材整理和口播切片的人来说,这是一份按真实调用量排出的选型参考。
一周 850 万次转写、比上线首周涨 12 倍,语音转文字正在被大量真实业务吃掉。做字幕、配音对轨、素材整理的后期可以拿它跟手上方案比一遍准确率和价格。
点击打开原文,能否访问取决于网络环境
08
MarkTechPost
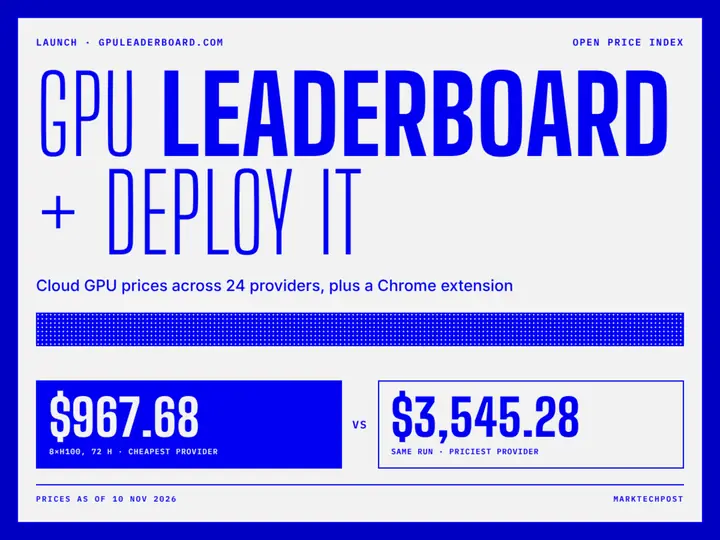
Marktechpost 上线 GPU Leaderboard,抓取 24 家供应商共 201 个实时 GPU 报价,按每 GPU 小时单价排序,支持按卡型、档位、地区、可用性筛选,另有按整次运行计价的推理成本计算器(选卡型、卡数、时长、利用率)。默认示例为 8×H100 跑 72 小时、90% 利用率,合计 576 GPU 小时,最低 Latitude 967.68 美元(1.68 美元/卡时),15 家中位数 1716.48 美元,最高 CoreWeave 3545.28 美元。同步推出 Chrome 扩展 Deploy It。
24 家供应商 201 个实时 GPU 报价按每小时单价排序,还能按整次运行算推理成本。自己搭生成流程、要长期跑批量出片的团队可以拿它比一轮价。
点击打开原文
01
公众号
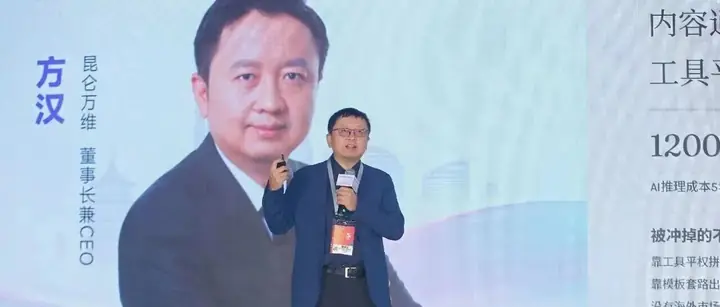
昆仑万维董事长兼CEO方汉在杭州AI文娱(短剧)产业对洽会上分享判断:AI短剧产能问题已解决,竞争从单点工具转向覆盖生产到发行的系统能力。他援引数据称今年前9个月上线短剧约49万部,海外市场规模超60亿美元、同比增长67%,爆款率仅约千分之五;昆仑万维2026年9月AI短剧平台单月流水近1亿美元,月度上新剧集中95%以上由AI生成。
49万部短剧、爆款率千分之五、海外60亿美元,方汉这组数字把AI短剧的真实盘子摊开了。做短剧和做出海的可以拿它校准预期:单点工具已经不够,拼的是从生产到发行的整套能力。
点击打开原文
02
@bangbuilds
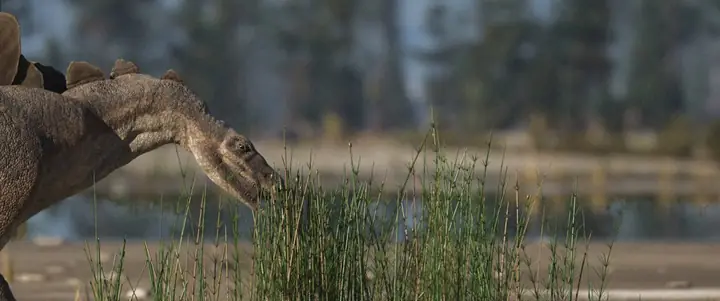
作者用 Claude Fable 5.2 写 Python 脚本驱动 Blender,从零做出一段恐龙短片:镜头、光线、动作都通过改参数重来,不用反复抽卡,哪里不对改哪里。作者据此提出疑问——Seedance 这类视频模型会不会被代码路线取代,以及这是否是 Claude 不做视频模型的原因。
用代码调镜头、光线、动作参数,改哪重跑哪,不用抽卡赌运气。做分镜预演和需要精确复现的镜头可以试这条路,跟视频模型是两套打法。
点击打开原平台查看,能否访问取决于网络环境
03
@jerrod_lew
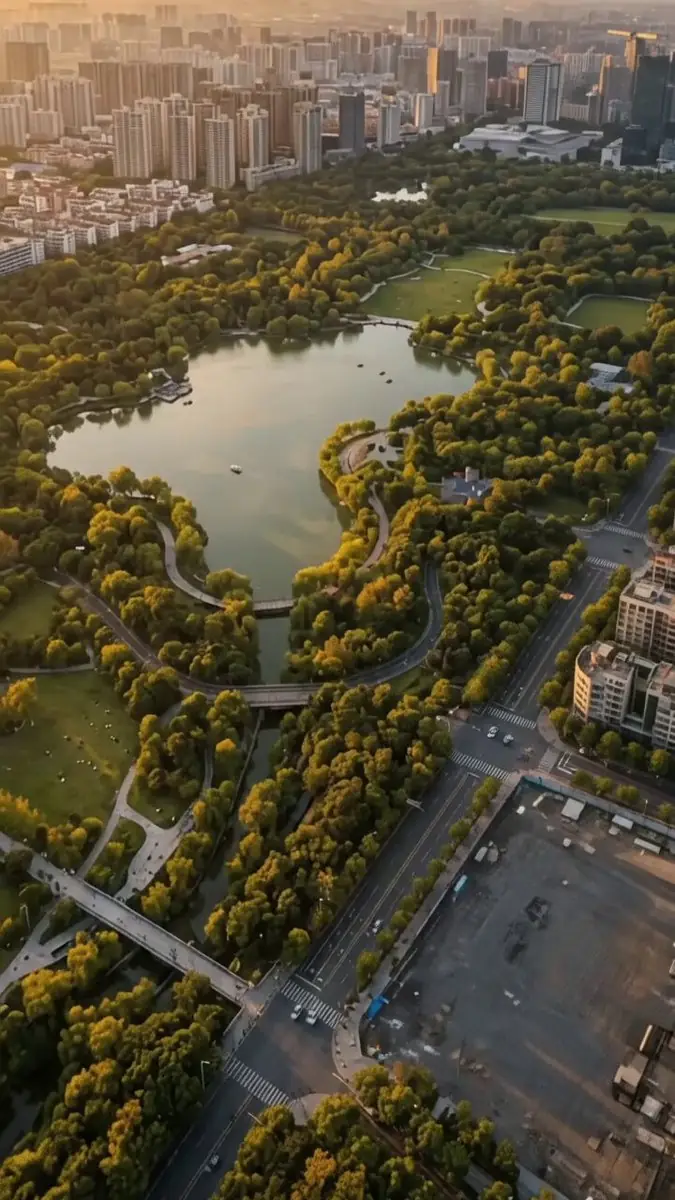
创作者 @jerrod_lew 分享用 Gemini Omni 1.2 Flash 做动画的用法:上传一张图片,提示生成「顺序层叠」风格的动画,镜头会快速推近(crash zoom)到画面中的特定元素上,提示词和原图放在评论区。适合做分镜预演、海报动效和单图转镜头运动。
一条可复用的玩法:上传单张图,提示词让画面按图层顺序展开、镜头快速推近到指定元素,做分镜预演和 KV 动效的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
04
Luma AI Blog
Luma AI 官博发文对比 InVideo 在商业广告项目中的短板:生成内容仅 25-40% 片段可用,需大量重生成;不提供 HDR、EXR 等后期专用导出格式;跨场景保持角色、产品与视觉风格一致需人工反复审校;基于场景的编辑方式导致复杂修改只能整段重生成而非局部调整。文中以一支主片、六个社交版本、三个市场本地化的投放需求为场景,强调后期流程衔接与品牌一致性。
Luma 官博点名 InVideo 的四个坑:生成片段只有 25-40% 能用、不支持 HDR/EXR、角色品牌一致性要反复修、改镜头得整段重生成。做商业广告和品牌片的可以拿这份清单对照自己手上的工具。
点击打开原文
05
@felixrieseberg
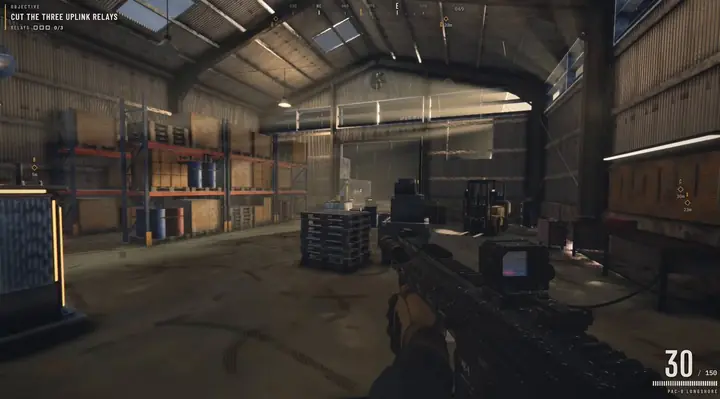
开发者 Felix Rieseberg 用单次提示让 Fable 5.2 从零生成一个可玩的游戏,模型、音效、贴图全部由模型产出,无人工反馈介入。API 计费约 550 美元,消耗约 270 万输出令牌和 4.45 亿输入令牌(大量走缓存),总耗时 8 小时,成品已发布在 Claude Artifact 上可直接试玩。
一次提示跑 8 小时、烧掉约 550 美元 API 费用,模型、音效、贴图全由模型自己生成。想摸清单次提示能撑多复杂的活儿,这个成本账可以拿来当参照。
点击打开原平台查看,能否访问取决于网络环境
06
@Hailuo_AI
MiniMax 旗下海螺(@Hailuo_AI)发推面向游戏开发者,称「你的下一个世界可能从一个 #H3Image 提示开始」,指向 H3 的图像生成能力,配文为悬念式喊话,未附示例图或具体参数。
海螺官方一句「你的下一个世界可能从一个 H3Image 提示开始」,没给图没给参数,做游戏美术的可以留意 H3 的图像能力,拍片的先路过。
点击打开原文,能否访问取决于网络环境
07
@xiaomanhedy
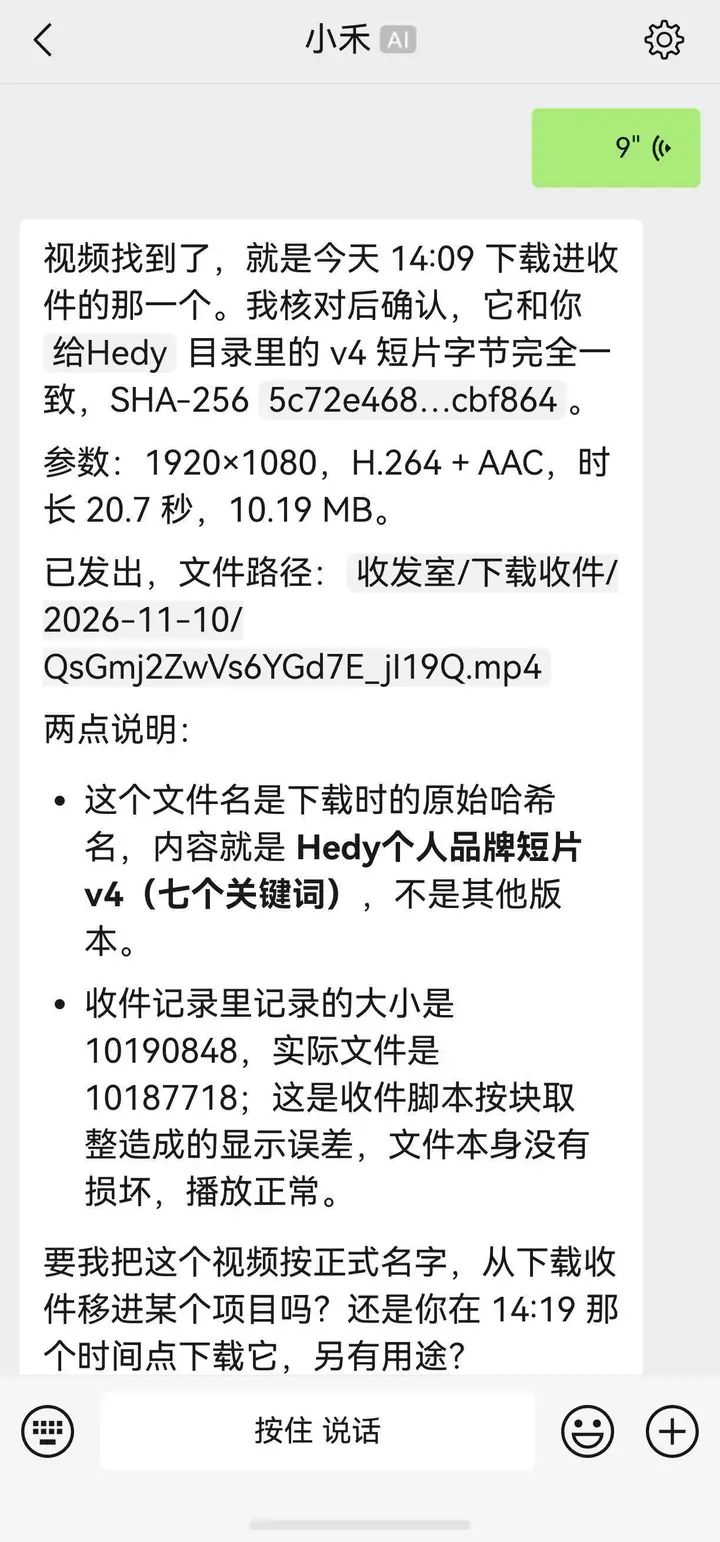
用户 @xiaomanhedy 分享 WorkBuddy 自带微信助理的使用体验:人在外面时在微信里发指令,即可把电脑里的文件发到手机;打通本地上下文后不再依赖「文件传输助手」在手机和电脑间来回传。文件起名、建文件夹也交给 AI,按用户预设的目录规则自动重命名、归档分类、调取发送。
个人使用体验分享:在微信里喊一声就能把电脑文件发到手机,还能按预设目录规则自动重命名归档。做素材管理的可以看看这个思路,跟拍片本身关系不大。
点击打开原文,能否访问取决于网络环境
08
@bidyut_io
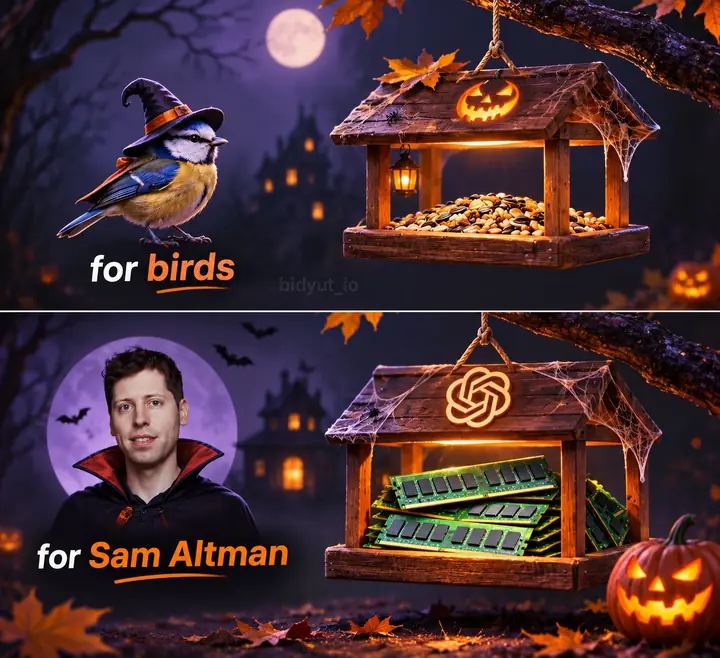
用户 @bidyut_io 发帖对比 ChatGPT Image 2.5 与 2.6 两个版本,称差异比预期明显,配图展示两版出图效果。
只有一句「差异比想象中明显」加两张对比图,没说是哪方面变好。做视觉的可以点开图自己看,别指望有结论。
点击打开原文,能否访问取决于网络环境