01
公众号
可灵AI 公众号发布创作者 TechHalla 对 Kling 4.0 与 Kling 4.0 Flash 的实战测评,包含投石机抛车、音乐视频《PACK ANIMALS》、3D 动作迁移等四项测试,重点考察多镜头调度与角色一致性表现。正文页面当前需验证访问,具体参数与逐项结论需打开原文查看。
可灵官方号转的第三方实测,四项测试里投石机抛车和 3D 动作迁移最能看出多镜头调度和角色一致性稳不稳,做 AI 短剧的可以照着这几个场景自己跑一遍对比 4.0 和 Flash 的差别。
点击打开原文,能否访问取决于网络环境
02
B站「AI 短片/短剧/视频」搜索
B 站 UP 主「AI漫剧制作全教程」发布的视频,围绕红果短剧禁令展开,标题称将全面下线并波及 AI 漫剧圈,同时附上过审全流程制作教程。属于面向 AI 漫剧从业者的政策解读加实操流程讲解。做 AI 短剧和漫剧的可以对照自己手上的项目,看内容合规和送审环节该怎么调整。
红果这波下线直接砸在 AI 漫剧的饭碗上,视频里把过审流程拆了一遍。做短剧和漫剧的当周看,先弄清哪些内容会被卡再动手。
点击打开原平台查看
03
@rileybrown
Riley Brown 描述的一次完整流程:在 Uber 上让 Claude Duet 用它的虚拟机收集视频素材,再让 Duet 唤起家里 Mac Mini 上的 Claude Code 会话,用 Blender 做视觉特效;渲染阶段 Claude Code 在 Runpod 上按分钟租算力跑 Blender 场景,剩余部分回 Mac Mini 渲完,上传到他的视频版本管理应用后通过 Duet 回传链接审片。30 分钟内来回改了 5 轮定稿。他平时就用 AI 先做视频小样再实拍,这条是分镜阶段的做法演示。
从 Uber 上发指令到成片回传只用 30 分钟,中间 Claude Code 自己上 Runpod 按分钟租算力渲 Blender 场景。想搭远程自动出片流程的,这套串法值得照着捋一遍。
04
AIHOT 全部动态
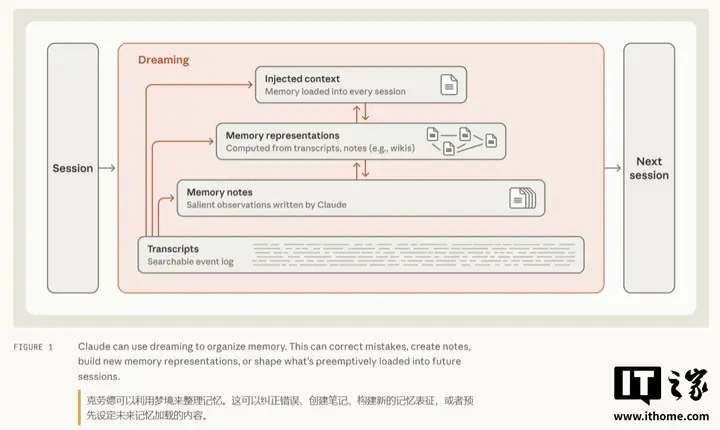
Anthropic 11 月 6 日发布研究文章《The components of agent memory》,把 Claude 智能体的跨会话记忆拆成会话日志、记忆笔记、知识表征(如 Wiki)、注入上下文四层,并引入「做梦」机制:在两次交互的空闲时间回顾日志、纠错、提炼规则、更新知识库。CL-Bench 数据库问答中,Claude Opus 5.5 与 Sonnet 5.5 带记忆平均得分 0.838 / 0.833,无记忆基线 0.655 / 0.644。《宝可梦红》测试里 Fable 5 只维护 10 个记忆文件拿到 4 枚徽章,Sonnet 3.7 写了 413 个文件只拿 1 枚。约 35 万份企业文档测试中,「做梦」从 2 次扩到 128 次,25 个问题达标率从 13% 升到 48%,Wiki 结合搜索后综合得分从 54% 升到 61%。
Anthropic 把智能体记忆拆成日志、笔记、知识库、注入上下文四层,还加了空闲时「做梦」纠错。搭长周期创作 Agent 的技术整合者可以照着这套结构改自己的记忆方案。
点击打开原文
05
@DeepBlueX0
作者用同一套 15 秒古风舞蹈 MV 提示词(固定人物 ID、抹胸汉服、中国古典舞、分镜按 0-3/3-6/6-9 秒逐段描述动作与镜头运动)分别跑 Gemini Omni 1.2 Flash、Seedance 2.0 Fast 和 Muse video,并附人物五官参考图。结论是各有胜负:Seedance 2.0 Fast 人物动作更流畅、参考图脸部 ID 保持更好,Gemini Omni 1.2 Flash 在真实感和清晰度上更强。
同一段古风舞蹈 MV 用三个模型跑,作者给出结论:Seedance 动作更顺、参考图脸部 ID 更稳,Omni 真实感和清晰度更好。做人物舞蹈类短片的可以照这个对比自己测一轮。
点击打开原平台查看,能否访问取决于网络环境
06
@ZondarkAI
作者实测 Claude Duet 语音模式:主 Agent 不下场执行,只负责对话、理清意图、拆任务,再派给多个子 Agent 后台并发干活,对话与执行分离。一小时内派了三件事——搜罗潜在客户并整理公开联系方式、做赛道调研、挂长期监控盯油价调价窗口;随口提的话也会被自动提取成待办。局限是国内购物、打车类 App 调不动,只能接国外软件生态。
开车一小时用语音把找客户、赛道调研、盯油价三件事派给后台子 Agent,主 Agent 只负责理意图拆任务。做制片和项目统筹的可以看看这种「动嘴派活」的用法。
点击打开原文,能否访问取决于网络环境
07
@aiwarts
X 作者「卡尔的 AI 沃茨」用商汤 SenseNova-6.8-Flash 实测四类生成产物:代码动画、UI、3D 和 SVG 动态海报,并与 Opus 5.5 做效果对比,同时给出可复用的「去 AI 味」调整方法。适合需要批量产出网页动效、界面稿和动态海报的视觉与前端创作者参考。
作者拿商汤 SenseNova-6.8-Flash 跑了代码动画、UI、3D、SVG 动态海报四类产物,还对比了 Opus 5.5,做视觉和前端物料的可以照着试一遍。
点击打开原文,能否访问取决于网络环境
08
B站「AI 短片/短剧/视频」搜索
B 站 UP 主在微星尊爵 N16 Flip AI+ 上实测 RTX Spark 平台的本地 AI 能力:128GB 统一内存跑起权重约 113GB 的大模型,测了 256K 长上下文,并用 ComfyUI 跑生图和 MiniMax H3 视频生成,逐项记录能否装下与生成速度是否实用。机器本身是 360° 翻转二合一,4K OLED 触控屏配收纳式触控笔,另测了 Windows on Arm 的软件兼容性。
128GB 统一内存实跑 113GB 大模型、256K 上下文,还用 ComfyUI 出了图和 MiniMax H3 视频。想评估本地跑 AI 出片可行性的团队,可以看它卡在哪一步。
点击打开原平台查看
09
@HappyS6688
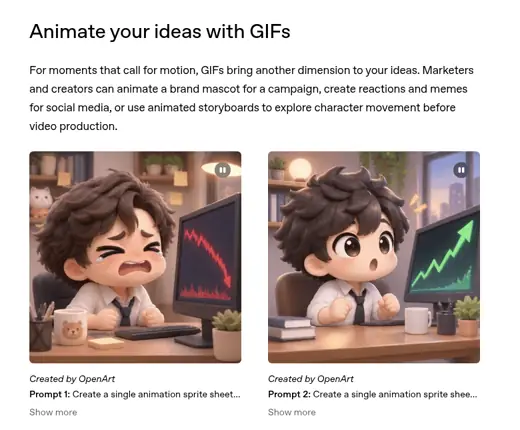
作者拆解 OpenAI 官方页上的两段 GIF 示例提示词,写法一致:一张图排 6 帧(3 列 2 行、每格同尺寸、从左到右从上到下读、第 6 帧顺回第 1 帧),并固定机位、锁定同一角色服装背景,只让表情和动作逐帧变化,同时写明不要文字、边框和格子线。文中给出可直接套用的模板句式,并指出 6 帧只是官方示例写法、可按动作长短自行调整。文中提到 OpenAI 11 月 4 日上线 Images 2.6,ChatGPT 全部订阅档位可做 GIF,出图比之前快 50%。
作者把 OpenAI 官方两段示例提示词拆成可套用的模板:3 列 2 行排 6 帧、固定机位锁死角色服装背景、第 6 帧顺回第 1 帧。做表情包和循环小动效的可以直接拿去改。
点击打开原文,能否访问取决于网络环境
10
Luma AI Blog
一篇梳理 Higgsfield 能力边界的文章,列出四项限制:跨多个片段时人脸和产品会漂移,角色一致性不可靠;多数工作流输出分辨率封顶 720p,上广播交付需额外放大;没有原生专业后期支持,素材无法直接进调色流程;缺少图层式编辑,改局部只能整段重生成。文中以 50 条多市场视频变体、六集系列角色统一、交付调色师三个需求为例,说明这些限制会直接拖慢周期并让消耗难以预估。
把 Higgsfield 的坑列成清单:多镜头人脸漂移、多数流程封顶 720p、没有图层式局部改。做系列片和要交付调色的团队,先拿这份清单对一遍自己的流程再决定用不用。
点击打开原文

