01
@ViggleAI
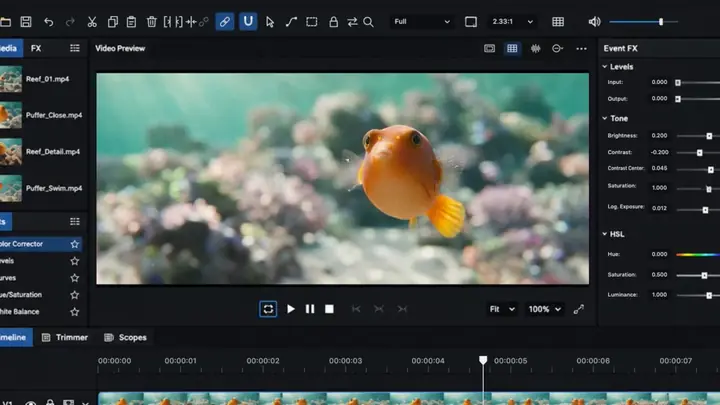
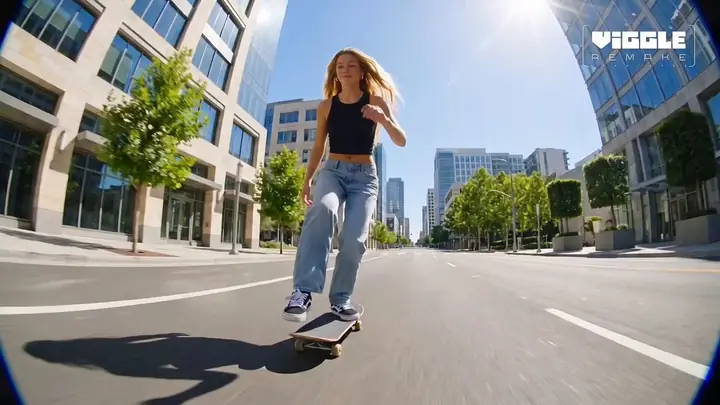
Viggle Remake 视频转换智能体开放模型权重(该产品 11 月 5 日已发布,huggingface.co/Viggle/Viggle-Remake)。可重选场景中所有角色并保持跨镜头一致,支持换物体、改背景、重新风格化、添加 VFX,最长 2 分钟,支持继续对话修片;720p 每 10 秒 0.96 美元起。
换角色、换物体、改背景、加 VFX 都在一条片子里完成,还能跨镜头保持角色一致,最长 2 分钟、720p 每 10 秒 0.96 美元。做短剧和后期的最该先拿自己素材跑一遍,看跨镜头一致性扛不扛得住。
点击打开原平台查看,能否访问取决于网络环境
02
The Decoder
Mira Murati 创立的 Thinking Machines 发布第二代模型 Inkling 2 Small,MoE 架构,总参数 594B、每次激活 17B,支持文本与图像输入,思考深度可调。Artificial Analysis 智能指数得分 31,较上代提升 18 分,与 Gemini 3.8 Flash 大致持平,agent 类任务提升明显。代价是输出 token 更多、单任务成本为上代 6 倍。目前通过 Tinker 平台以闭源形式提供,Apache 许可的权重后续开放。定位是供微调的基座模型。
594B 总参数、17B 激活的 MoE,Artificial Analysis 智能指数 31 分,比上代涨 18 分,主打 agent 任务。做创作流水线自动化的可以留意它后续开放权重,拍片的暂时用不上。
点击打开原文
03
@NotionHQ
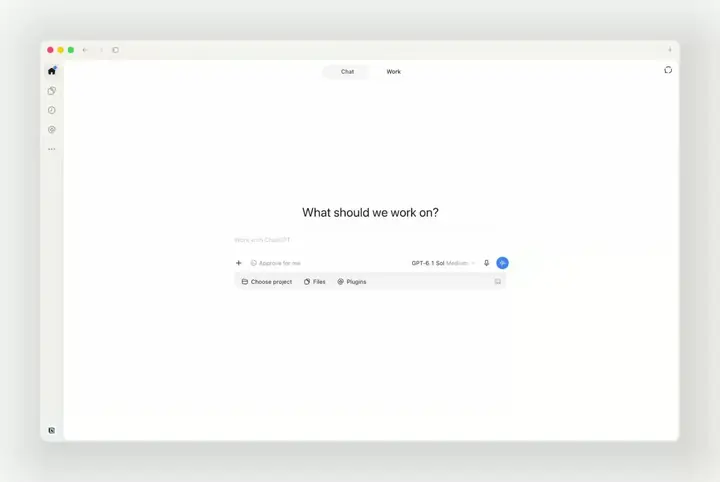
Notion 官方宣布为 ChatGPT 开发了一款 Notion 插件,把真正的 Notion 编辑器嵌进 ChatGPT 内部:用户可以在对话中创建页面,看着内容随聊天逐步成形,再跳进去自己手动编辑,全程不离开对话界面。属于文档协作工具与聊天助手的打通,面向的是资料整理和写作场景。
Notion 官方给 ChatGPT 做的插件,聊天时页面边生成边成形,能直接跳进去改。做项目文档和剧本大纲的可以试,跟拍片流程关系不大。
点击打开原平台查看,能否访问取决于网络环境
04
@OpenRouter
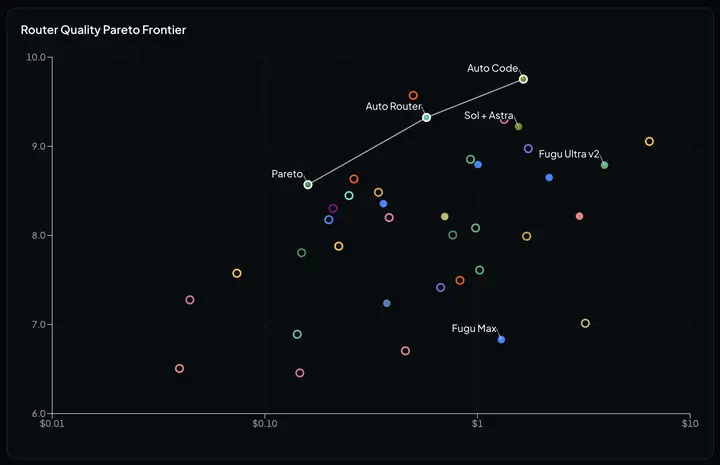
OpenRouter 发布新一代模型路由器:Auto Router 面向通用问答与智能体,Auto Code 面向编码智能体。官方称 Auto Code 基准表现接近 Opus 5.5,成本低 74%,p90 延迟 0.65 秒,并展示每次请求的路由决策过程。对自建批量生成流程、需要按任务自动切换模型并压 API 成本的团队,这是可接入的一层调度。
Auto Code 官方称基准接近 Opus 5.5、成本低 74%、p90 延迟 0.65 秒,还能看每次请求的路由决策。自己搭批量生成流程、要控 API 成本的技术整合者可以接上试跑。
点击打开原文,能否访问取决于网络环境
05
TechCrunch AI
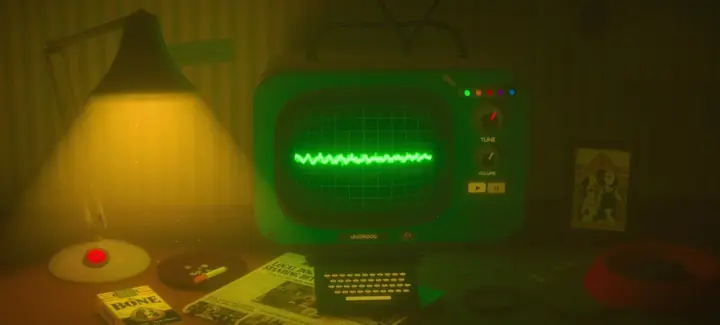
Underdog 发布文本转语音模型 Woof,体积仅 31.7MB,可在浏览器和多数设备本地运行,同时能生成语音与音乐。官方配套做了一个复古科技主题的网页小游戏:打字机输入任意文字即朗读,旋钮可切换生成不同风格音乐,全部在浏览器内完成。对做配音、互动叙事和轻量音频工具的团队,这是一个可本地部署的小体积 TTS 选项。
31.7MB 的语音模型塞进浏览器,打字就能念出来、转旋钮还能出音乐,做配音和互动叙事的可以拿它试本地化方案。
点击打开原文
06
@OpenRouter
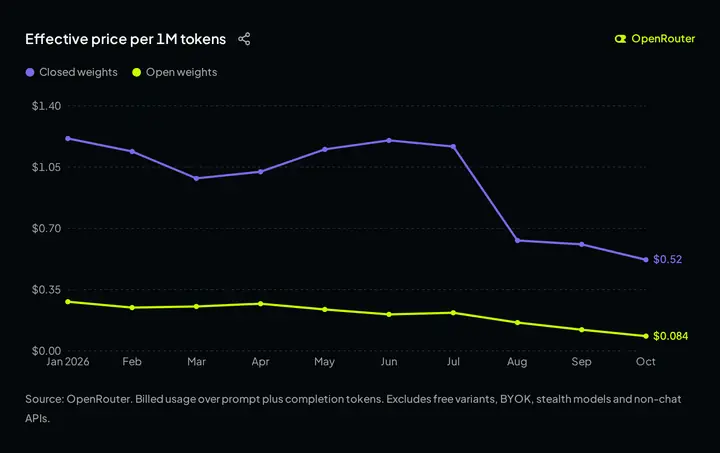
OpenRouter 按计费用量统计,自 1 月以来每 token 有效价格下降 57% 至 70%:封闭权重模型从 $1.21 降至 $0.52 per 1M tokens,开放权重模型从 $0.28 降至 $0.084 per 1M tokens,两者价差从 4.3 倍扩大到 6.2 倍。统计排除免费变体、BYOK、隐身模型和非聊天 API。
封闭权重模型从 $1.21 掉到 $0.52 每百万 token,开放权重从 $0.28 到 $0.084,价差反而从 4.3 倍拉到 6.2 倍。做批量生成、跑长片素材的制片可以拿这组数重算一遍成本模型。
点击打开原文,能否访问取决于网络环境
01
@Gorden_Sun
创作者 Gorden Sun 称 Gemini Omni Flash 1.2 大致能达到 Seedance 2.0 九成水平,速度更快、价格更低。Gemini Pro 可在 AI Studio 使用,Flow 额度充足但尚未上线。他同时提到安全审核很严格,不少词会触发拦截。
个人实测口径:速度更快、价格更低,AI Studio 里约 60 秒 720P 额度,Flow 额度充足但还没上线。做短剧的可以先去 AI Studio 跑几条比废片率,注意审核卡得严。
点击打开原平台查看,能否访问取决于网络环境
02
@xiaohu
作者用 Gemini 3.8 Flash TTS 解决配音、OmniHuman 1.5 做真人形象对口型,素材收集、文稿、动效、配音配乐、剪辑、渲染到封面设计全程由 Claude Code 驱动,本人只提意见和修改。成本方面口型约 2-3 元,Claude Code 100 美金周额度只消耗约 1%,配音走 Google AI Studio 赠送额度。
一条把配音、对口型、剪辑、封面全交给 Claude Code 跑的个人实测,口型成本 2-3 元、周额度只花 1%,做后期和短剧的可以照着搭一遍。
点击打开原平台查看,能否访问取决于网络环境
03
@NVIDIAAI
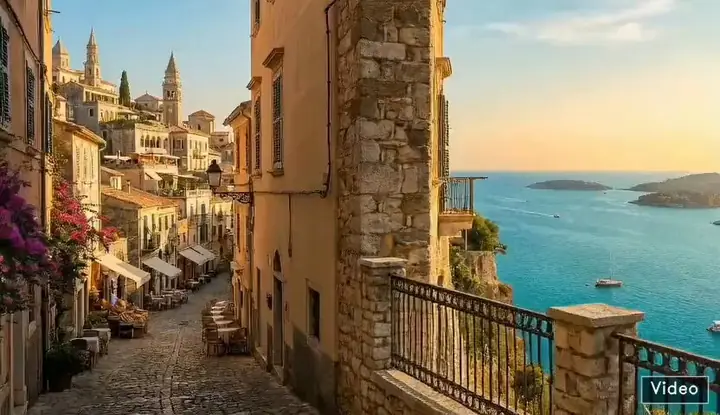
NVIDIA 官方介绍 Lyra 2.0(该产品 10 月 5 日已发布),把单张图片转成可沿自选相机路径探索的 3D 环境。做法是把视频生成和 3D 重建结合,模型会参考先前视角、学习纠正累积的视觉误差,让探索后回到熟悉位置时画面保持一致。论文、代码和演示已在项目页公开。
一张图变成能自己走镜头的 3D 场景,走回原地画面还能对上,做虚拟置景和场景预演的可以看论文和 demo 怎么用。
点击打开原平台查看,能否访问取决于网络环境
04
@arafune
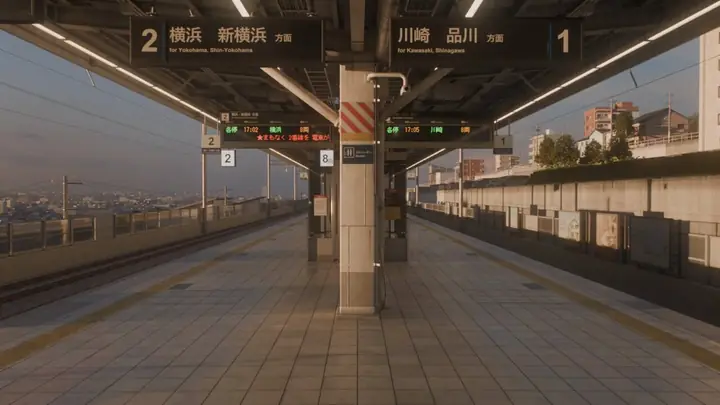
日本创作者荒船泰廣用 Blender 配 Claude Opus 5.5 做三维测试,称品质相当好。建模几乎全部自己完成,Tripo 只用了约 5%;文字等部分纹理借助 ChatGPT,着色器几乎全部以程序化方式完成;声音使用 HunyuanVideo-Foley,幕后制作过程也由 AI 协助完成。
作者用 Claude Opus 5.5 在 Blender 里建模、写程序化着色器,Tripo 只占 5%,音效用 HunyuanVideo-Foley 补。做三维和视觉开发的可以看这套分工怎么切。
点击打开原平台查看,能否访问取决于网络环境
05
Luma AI Blog
Luma AI 官方发布 Luma 与 Higgsfield 的对比文章,从品牌与代理公司视频制作角度拆解两者差异:Luma 支持 HDR 输出与 16-bit EXR 导出以对接后期流程,提供团队工作区、实时协作与访客权限,并与 Serviceplan Group 等代理集团建立合作;生成端 Luma 用 Ray 3.2 搭配更完整的创作流程,Higgsfield 则聚合 Kling、Veo、Seedance 等多个视频模型。文章强调改稿、产品替换、本地化版本与最终交付对广告项目按期过审的影响。
Luma 官博的对比文,把 HDR 输出、16-bit EXR 导出、团队协作空间和 Serviceplan 合作摆出来,做品牌广告和代理公司活儿的可以看看后期交付这一段。
点击打开原文
06
Luma AI Blog
Luma 官方博客发布八款 AI 图生视频模型横评,按输出质量、功能与专业适用性排序,评估维度包括 16-bit HDR 工作流(Luma Ray3 HDR 支持)、原生音画同步生成、首尾帧控制引导运动,以及授权、剪辑灵活性和后期兼容性。文中引用 2026 年行业报告:近三分之二数字视频广告买家已用生成式 AI 做创意生产,预计 2027 年 AI 将贡献其 43% 的广告素材。
八款图生视频模型横评,重点落在 16-bit HDR、原生音频、首尾帧控制这些能直接进后期流程的指标上。做分镜转镜头和调色交付的可以对着自己那套流程比一遍。
点击打开原文
07
Luma AI Blog
Luma AI 官方发布横向对比,比较 10 款 AI 视频模型的单次生成时长、续接延长方案、参考图输入与创作控制能力,并指出单次时长因模型而异,部分靠续接拼长序列。文中提到 Ray 3.2 支持 HDR 与 EXR,便于把生成素材接入后期调色与合成。对比维度还包括运动、角色与构图的稳定性,以及团队审片、修改、交付的顺畅程度。
Luma 官方把 10 款视频模型的单次出片时长、续接方式、参考图控制摆在一起比,还提到 Ray 3.2 的 HDR 和 EXR 能直接进后期。做长镜头和广告片的可以对着这张表挑模型。
点击打开原文
08
@ring_hyacinth
创作者 Ring Hyacinth 分享自己片子的做法:用 Opus 5.5 写出一条主题旋律,再交给 Suno 把这条旋律扩展成不同场次的背景音乐,让整片的配乐保持统一;Opus 5.5 同时用于早期的分镜动画。对做 AI 短片和短剧的人来说,这是一条把「音乐一致性」落到具体两步流程上的可复用思路。
一条片子的配乐统一问题,被拆成「Opus 5.5 写主题旋律 + Suno 按场扩展」两步解决,做后期和声音的可以照这个思路试一遍。
点击打开原平台查看,能否访问取决于网络环境
09
@GaoYipeng
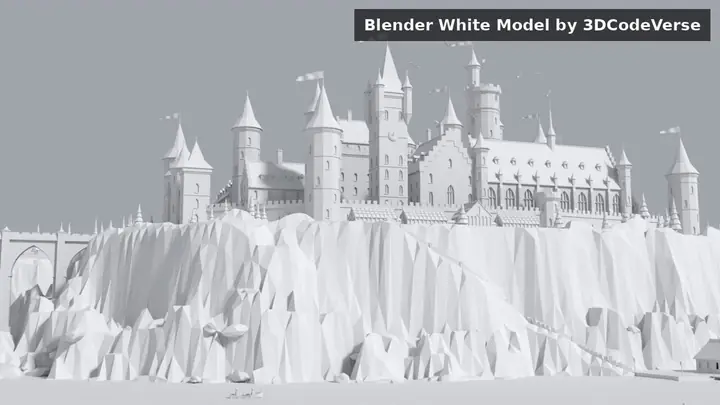
作者用 3DCodeVerse 的 Blender 白色模型加一段文本提示,直接让 Gemini Omni 1.2 Flash 出渲染结果,没有给材质也没有布光。这条展示的是白模转成片的用法,适合做场景概念图和视觉开发时先看效果再决定要不要进三维细做。
拿 Blender 白模加一句提示词就能出带材质灯光的渲染图,做视觉开发和场景概念图的可以照这个思路试一轮,看能不能省掉打光和贴图那步。
点击打开原平台查看,能否访问取决于网络环境
10
@0xMaxs
推文转述「土豆姐」的做法:让 AI 回看与人的历史聊天记录,把反复出现的错误和需要人工干预的环节整理成下次可直接复用的工作流程。她有一个叫 Dr. Eggbot 的助手,专门检查其他 Bot 和对话记录,判断哪个 Bot 总在某件事上做不好、是否该补技能、拆出新的专职 Bot 或调整已有自动化任务,把历史对话当作可复用的上下文来源。
思路不新但落地:把反复纠正 AI 的地方攒成可复用的流程,再拆出专职 Bot。自己搭自动化流程的可以照着改一版。
点击打开原平台查看,能否访问取决于网络环境