01
@dotey
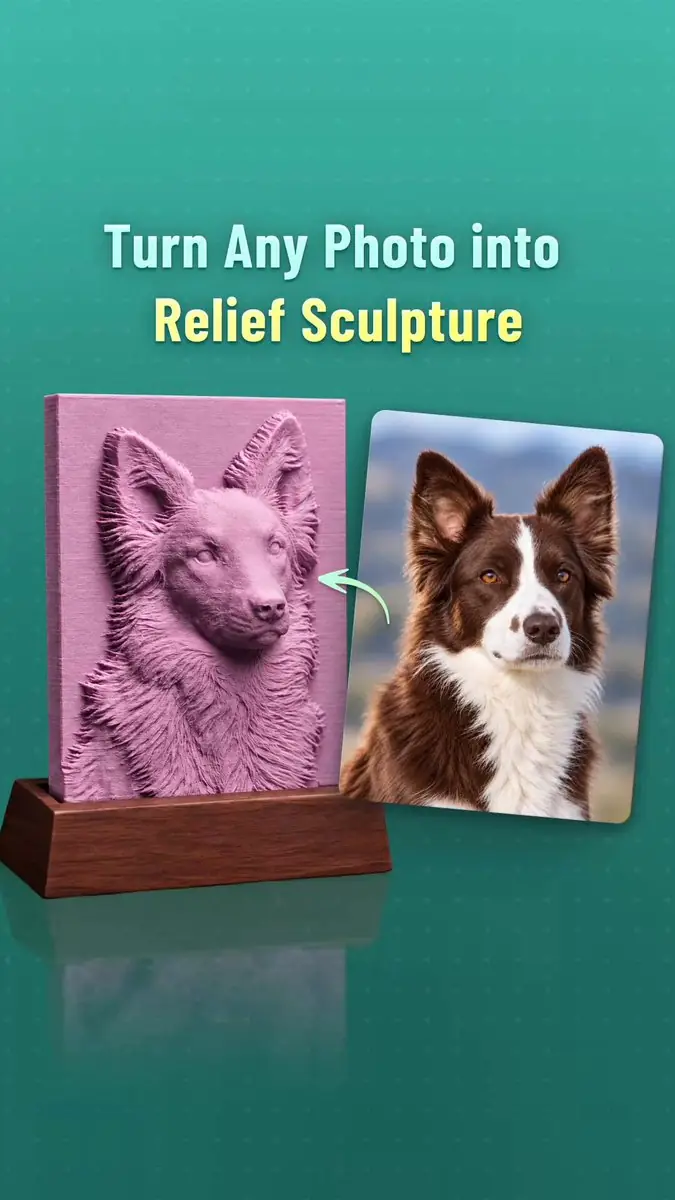
OpenAI 11 月 4 日发布图像模型 Images 2.6,ChatGPT 与 Codex 全档位用户当天可用,覆盖电脑、手机、网页版,开发者可通过 API 调用。新增 SVG 矢量图导出(可直接用于网站、App、印刷品)、GIF 动图生成(支持文字、照片、手绘草图输入,可调播放速度、逐帧查看修改),出图速度较上版快 50%,改图时能更准确定位修改区域。API 分两版:Flare 偏速度,低画质下最快约 6 秒一张;Sunburst 偏画质,中高画质细节更多,多轮改图后人物与商品一致性更稳。另新增图片标注(圈选局部修改)与复杂度参数。OpenAI 称全球每周生成 40 亿张图。
SVG 导出意味着 AI 出的图标、Logo 能直接进设计稿和印刷品,不用设计师照着重画;GIF 用精灵图拼帧,拍片前试角色动作很省事。做视觉和 KV 的这周可以拿 API 跑一轮。
点击打开原平台查看,能否访问取决于网络环境
02
@GeminiApp
Google Gemini 宣布 Gemini Omni 1.2 Flash 视频模型即日起向所有 Google AI 订阅者推送,Gemini 应用内支持多轮对话式剪辑与更稳定的画面。Google AI Ultra 订阅者可单次生成并编辑最长 15 秒视频,支持 3s 到 15s 任意时长、更自然的多人对话口型同步和更连贯的运镜。模型由 Google DeepMind 更新,可先出 360p 或 720p 草稿($0.07/s,成本低 30%)再放大至 1080p 或 4K。
视频生成开始能像聊天一样反复改,Ultra 单次最长 15 秒,还能先出 360p 草稿再放大到 4K,做短剧和广告的可以拿它试一轮改片流程。
点击打开原平台查看,能否访问取决于网络环境
03
@krea_ai
Krea AI 官宣推出全新 Krea Video,主打在浏览器内直接生成好莱坞级画质视频。功能包括电影感相机控制、100+ 热门预设、可直接用于 UGC 的模板、视频剪辑、风格迁移和声音生成,现已开放试用。对做短剧和投放素材的团队来说,生成到剪辑到配音在同一页面完成,省掉跨工具导来导去。
Krea 把生成、剪辑、风格迁移、声音塞进一个浏览器页面,还给了 100+ 预设和 UGC 模板。做短剧和投放素材的可以先去跑几条,看预设能不能省掉调参那一步。
点击打开原平台查看,能否访问取决于网络环境
04
@Baidu_Inc
百度发布 ERNIE 5.5 Flash Base 模型,官方博客提供介绍页,同时在 Hugging Face 开放下载入口(huggingface.co/baidu/ERNIE-5.5-Flash-Base)。原文只给出发布与下载渠道,未列出参数规模、上下文长度、推理速度或价格等具体指标。对做本地部署、私有化推理的技术整合者来说,权重可下载意味着能自己跑起来测;对拍片和后期环节,这条暂时没有可直接用的创作能力。
百度把 ERNIE 5.5 Flash Base 权重放上 Hugging Face,官方博客同步给了介绍页。做本地部署和私有化流程的技术整合者可以先去下权重跑一遍,看能不能接进自己的生成流程。
点击打开原文
05
@thsottiaux
OpenAI 发布安全专用模型 GPT-6 Cyber,称在多个网络安全用例上表现突出,并强调能力提升的同时对齐更好。该模型此前驱动了已公布的 Linux 内核研究,Mozilla、Palo Alto Networks、Calif、Cisco 及 OpenAI 自身安全团队已在使用,目前向部分 Daybreak Red 客户开放,访问范围将逐步扩大。
网络安全垂直模型,跟拍片、出图、剪片都不沾边,创作团队路过即可。
点击打开原平台查看,能否访问取决于网络环境
06
@theworldlabs
World Labs 发布 Frameboy demo,把两个月前推出的自回归世界模型 Atlas 放到云端 GPU 上串流,支持实时探索生成世界,最高 15 fps,并具备像素级相机控制。相比只能出固定片段的视频模型,这套是能边走边看、随时改机位的交互式场景。做虚拟预演、场景勘景和镜头调度的可以关注它的相机控制精度和帧率表现。
Atlas 世界模型从云端 GPU 串流,能实时走进生成场景、像素级控相机,最高 15 fps。做虚拟场景预演和镜头走位的可以点开 demo 感受一下交互节奏。
点击打开原平台查看,能否访问取决于网络环境
07
@perplexity_ai
Perplexity 上线 Teammates 功能,智能体可承接任务,调用 Computer tasks、skills、memory 和工具主动工作,彼此之间能协作,还能在 Slack 中给同事发消息。目前已向 Max 订阅用户开放网页版。
Perplexity 的 Teammates 能自己接活、互相协作、还能在 Slack 里给同事发消息,本质是办公自动化智能体。跟拍片剪片不沾边,做团队协作流程的可以瞄一眼。
点击打开原平台查看,能否访问取决于网络环境
08
@choblin29
据 WSJ 报道,OpenAI 总裁 Greg Brockman 承认 2026 年上半年「相当艰难」,Anthropic 在企业 AI 领域领先,他提到「我们有 Codex,但没人谈论它」。第三季度情况反转:OpenAI 年化收入单季增长 70%,企业收入翻倍,商业客户已占其收入多数,他把转折归功于 GPT-5.6 Sol 和 ChatGPT Work。被问 2027 年能否 IPO,他答「我想可以」。
OpenAI 总裁自述上半年被 Anthropic 在企业市场压着打,靠 GPT-5.6 Sol 和 ChatGPT Work 一个季度把年化收入拉高 70%。关心大模型商业格局和工具选型的制片可以扫一眼。
点击打开原文,能否访问取决于网络环境
09
@imjustnewatai
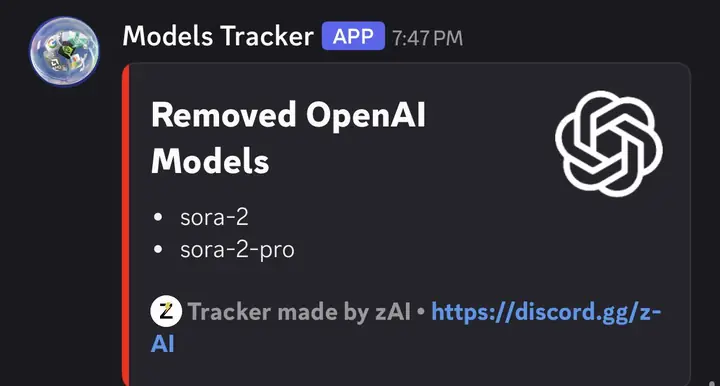
账号 @imjustnewatai 发推称 OpenAI 将要发布新的 Sora 模型,点名「Sora 2」,属第三方爆料。对做 AI 短片和短剧的团队,这条只说明 Sora 线可能有下一代,具体画质、时长、音频能力要等 OpenAI 官方公布后才能判断是否值得改工作流。
只有一句爆料加两个眼睛表情,没有参数没有时间没有官方口径。做 AI 视频的可以记一笔等官宣,别当已发生的事去排期。
点击打开原文,能否访问取决于网络环境
01
@PixVerse
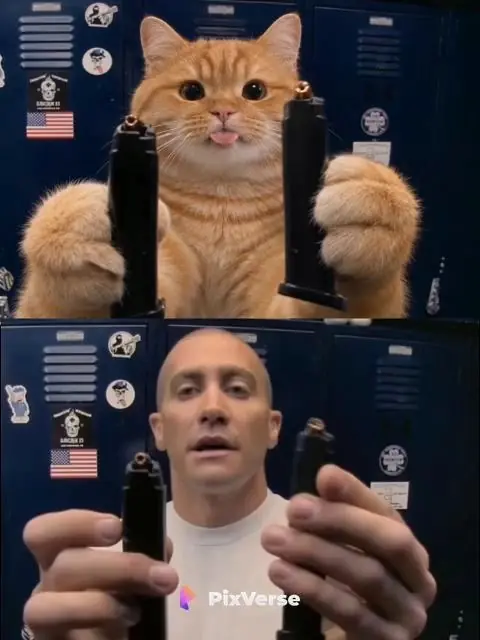
PixVerse 官方演示 Depth Map Control 用法:在 PixVerse 打开该功能,上传想复刻的视频作为深度参考,再添加自己的角色、物体或场景,写提示词生成,即可用自己的角色复刻任意视频的动作。适合需要把现成动作素材迁移到自己角色上的镜头复用场景。
上传参考视频当深度图、换上自己的角色再写提示词,四步就能把别人的动作搬到自己的片子里。做分镜预演和短剧动作戏的可以照着跑一遍,看角色一致性稳不稳。
点击打开原平台查看,能否访问取决于网络环境
02
Runway
Runway 发布技术研究《Runway Characters: Serving a 57B Video Diffusion Transformer for Real-Time Conversation》,讲如何让约 57B 参数的自回归视频扩散 transformer 以 24 fps 支撑可对话的实时虚拟角色,硬件侧用四张 H100 跑通。对做实时虚拟角色、AI 主播、互动剧的技术整合者,这是一份关于大模型实时出画的服务侧方案参考。
57B 的视频扩散 transformer 跑到 24 fps 实时对话,四张 H100 就够,做虚拟角色实时互动的技术整合者可以看它的服务方案怎么拆。
03
公众号
创作者 SwordSpeed 用 Kling 4.0 做了 30 秒无对白科幻短片《THE CABLE(电缆)》第一章,目标是验证 AI 动画能否保住 1988–1992 年日本手绘赛璐璐 OVA 的质感。他设了三个测试点:复古画风在镜头运动中是否退化、赛博格角色跨镜头是否保持一致、零重力环境下头发与碎片的惯性次级运动。结论是三项均达标,其中发丝级次级运动表现最突出。
拿 30 秒无对白短片专门测三件事:复古赛璐璐画风在运动里会不会糊、赛博格角色跨镜头脸崩不崩、零重力下发丝和碎片的惯性。做风格化动画和角色一致性的视觉师可以照着这个测试思路跑一遍。
点击打开原文
04
@vastxie
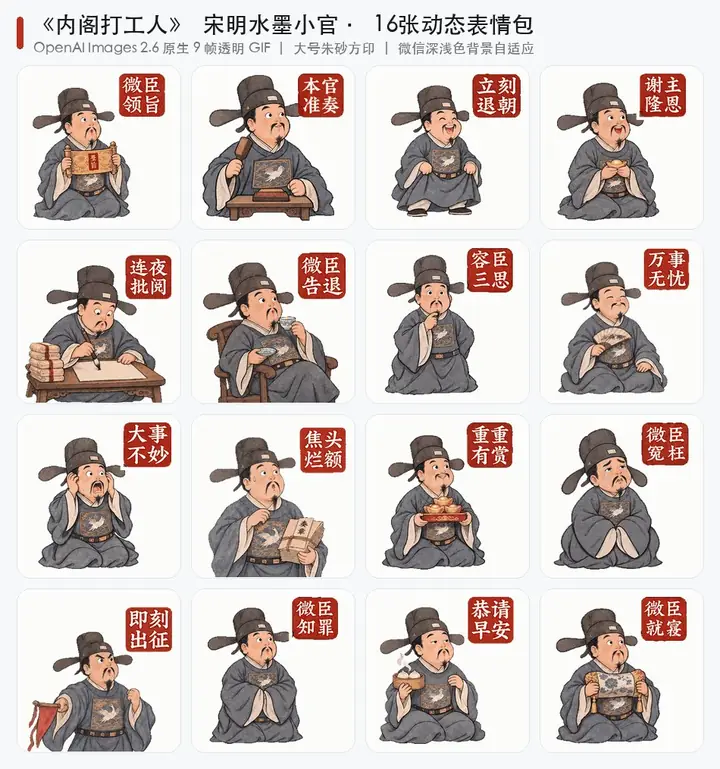
作者用 Pro 订阅赠送的 API 额度调用 gpt-image-2.6,完成《内阁打工人》《精神稳定的藏狐》两套微信动态表情包共 32 张,含前期测试总花费 4 刀出头。流程四步:generations 接口开 output_format="gif"、size="320x320"、background="transparent" 直出 3×3 母版 9 帧透明动图,抽第 0 帧存 anchor.png 锁人设;其余 15 张喂 anchor.png 走 edits 接口并发,只改动作与配字;prompt 里强制写死 NO white sticker border / NO white outline,避免微信深色模式下帽翅耳朵缝隙残留白边;最后用 Python 按 9 帧联合包围盒居中缩放到 240×240,保留前景原始 RGB 做 GIF89a 透明量化,裁好 cover 和 icon 直接上传微信表情后台。
作者用 Pro 订阅赠的 API 额度,4 刀出头跑完两套 32 张动态表情包,锚点图锁人设、edits 接口并发、深色模式去白边、Python 打包四步都写清了。做角色 IP 和表情包生意的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
05
X
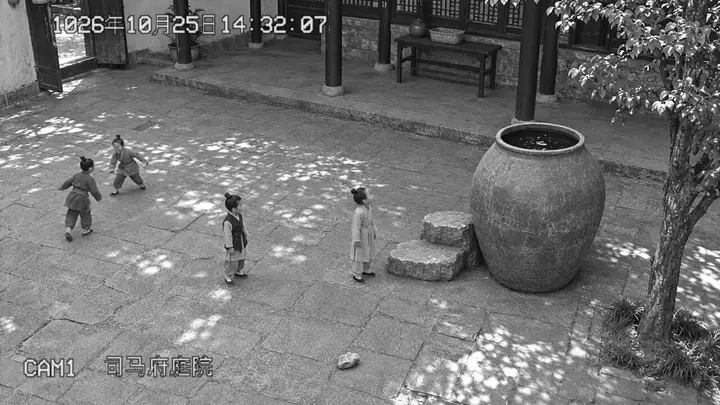
MiniMax Design 用 H3 演示中国古代成语故事的「档案监控录像」风格视频,公开了完整做法:先用人物和庭院做参考图,再把落水、想办法、砸缸、救人分段生成并固定机位,最后用 VCR OSD Mono 与 GNU Unifont 绘制低分辨率点阵时间戳,轻微模糊放大后用 FFmpeg 叠加到画面上模拟老监控字幕。分段生成加固定机位是控制多镜头连贯性的关键,假时间戳则是伪纪实质感的来源。
把「司马光砸缸」拍成老监控录像,关键不在模型而在那层假时间戳——点阵字体加轻微模糊再用 FFmpeg 叠上去。做复古质感和伪纪实的后期可以照这套跑一遍。
点击打开原平台查看,能否访问取决于网络环境
06
Luma AI Blog
Luma 官博面向广告公司讲 AI 创作工具的用法,核心场景是已定稿的创意被临时追加需求时如何局部修改而非重做:保留已通过的版式只改单个元素、多市场标题本地化、从 brief 到交付走同一套流程。文中提到 HDR 工作流与 EXR 导出可接入专业后期,并点名 Serviceplan、Dentsu、Publicis Groupe 等代理商。
讲的是改稿场景:客户临时加三个版本、四个市场本地化、换主视觉视频,不用从头重做。制片和后期可以看它怎么把 HDR、EXR 导出接进现有流程。
点击打开原文
07
@GrayNoteLab
作者给出两步做法:先让生图模型按想要的画面生成连续动作的 36 宫格图,再把宫格图连同指令交给 GPT,要求严格按从左到右、自上而下的顺序从第 1 帧播到第 36 帧,仅正向播放不倒放、每帧 10ms(约 100FPS)、无插帧无画面融合、无限循环。作者补充宫格数越多画面越流畅,每帧时长越大播放越快。
用生图模型出 36 宫格连续动作图,再交给 GPT 按帧序拼成无限循环 GIF,每帧 10ms。做表情包、循环动效和短剧转场的可以照着跑一遍。
08
Recraft AI Blog
Recraft 官方博客讨论图像生成的两条接入路径:走 fal、Replicate 这类模型市场,还是直连厂商 API,并给出多数生产团队最终采用的混合方案。文章把模型市场定位为图像生成的核心基础设施,按「什么时候该走市场、什么时候该直连」分场景说明。对需要自己串生成流程的技术整合者,这是一份选型参考;不涉及具体模型能力或价格数据。
讲 fal、Replicate 这类模型市场和直连官方 API 各自适合什么场景,以及多数团队最后会走的混合方案。自己搭生成流程的技术整合者可以对照着看,纯拍片的编导这条用不上。
点击打开原文
09
@jamesyeung18
创作者 James Yeung 称把 4 张图片丢进 Seedance 2.5,几乎没写提示词就得到一段 30 秒视频,属于多图参考直接出片的个人实测分享。
个人实测:4 张参考图、几乎不写提示词,直接出 30 秒成片。想试多图参考做连续镜头的,可以照这个思路跑一遍看稳定性。
点击打开原平台查看,能否访问取决于网络环境
10
Luma AI Blog
Luma 官方博客发布面向开发者和企业团队的 Sora API 替代方案指南,核心论点是 Sora 仍处于受限访问状态,团队需要能直接接入现有流程的平台,强调帧级控制、专业导出格式和 API 支持。文中重点介绍 Luma Layers(由 Uni-1 驱动):把物体、文字、背景拆成可独立编辑的图层,上传图也能分解;产品替换靠匹配光照、透视和比例,多素材一致性靠保留版式与风格只改目标元素,文字层可单独改标题、日期、CTA 而不重生成整张图。
Luma 自己写的选型指南,把「Sora 还没开放」当由头推自家 Layers 和 Uni-1 图层拆分。要接视频生成 API 的技术整合者可以扫一眼对比维度,视觉师重点看图层化编辑那段。
点击打开原文