01
@ViggleAI
Viggle 发布视频转换 Agent「Viggle Remake」并同日开放模型权重(Hugging Face 可下载)。能力包括:替换场景中角色且跨镜头保持一致、更换物体与背景、改风格或加 VFX,单条最长 2 分钟,支持继续对话修正任意镜头。720p 定价每 10 秒 0.96 美元起,官方称低于 Higgsfield Genjutsu 的一半。
换角色、换背景、改风格、加 VFX 都在一条对话里改到满意,跨镜头还能保持一致,720p 每 10 秒 0.96 美元。做短剧和后期替换的可以拿它跑一遍废片率。
点击打开原平台查看,能否访问取决于网络环境
02
公众号
可灵AI 宣布 Kling 4.0 Flash 向所有用户全面开放,可通过 Kling AI 官网和 API 使用,同时支持 MCP、CLI 及 AI 插件接入;创作者可在 Adobe Photoshop、Premiere Pro 和 After Effects 中通过可灵插件调用该模型,入口为 klingai.com。对后期和短剧团队来说,模型直接进 PR/AE 意味着不用导出再导入,剪辑和合成环节就能出片。
可灵 4.0 Flash 这次不只开官网和 API,还给了 MCP、CLI 和 PS/PR/AE 插件,后期直接在剪辑软件里调模型,做短剧的可以跑一遍看废片率。
点击打开原文
03
@Kimi_Moonshot
月之暗面官方宣布开放 Kimi K3.1 Pro 模型权重,下载地址为 huggingface.co/moonshotai/Kimi-K3.1-Pro,官方表示将继续推进 open intelligence。具体规格需看 Hugging Face 模型卡。对自建推理环境、想拿开源权重做私有化部署或微调的团队,这是可直接下载的入口;对以视频/图像生成为主的创作流程,这条不涉及画面或声音能力。
月之暗面把 K3.1 Pro 权重挂上 Hugging Face,官方只留了一句「继续推进开放智能」。想本地部署或微调的自建团队可以先去仓库看模型卡,做片子的人这条先放着。
点击打开原文,能否访问取决于网络环境
04
The Decoder
OpenAI 基于新模型 Images 2.6 在 ChatGPT 上线 GIF 生成,正向网页、桌面、移动端的全部 ChatGPT 和 Codex 用户推送。用户可用文字提示或上传照片生成 GIF,并调整动画速度、编辑单帧;官方示例「做一只跳舞的猫」会生成同一角色的多个细微变体,再按翻页书方式串成 GIF,跨帧角色一致性是这次的关键改进。Images 2.6 同时提升整体出图速度,面向开发者放出 API 模型 GPT-Image-2.6「Flare」(偏效率)与「Sunburst」(偏画质),两个变体此前随 Image 2.5 首次推出。OpenAI 称 ChatGPT 与 API 每周生成图片已超 40 亿张,比 9 月多出 10 亿。
ChatGPT 现在能按文字或上传照片直接出动画 GIF,还能调速度、改单帧,靠的是 Images 2.6 的跨帧角色一致性。做表情包、片头小动效、分镜预演的可以上手试一轮,看角色会不会跑形。
点击打开原文
05
OpenAI Blog
OpenAI 官方博客宣布将收购 Pierre Computer Company, Inc.,官方表述是借此扩充 Codex 在代码构建、理解与审查方面的工具能力。对做 AI 编程与自动化流程的团队,后续值得观察 Codex 在代码审查环节的能力变化;对影视、短剧、视觉类创作者,这条与日常出片流程没有直接关系。
OpenAI 官方宣布收购 Pierre Computer,用来扩充 Codex 在代码构建、理解和审查上的工具。做 AI 编程自动化的可以留意后续 Codex 能力变化,拍片团队这条可以先放着。
06
多平台
OpenClaw 接入腾讯混元 Hy4 同日在 2 个第三方平台上线可用:公众号 / AIHOT 全部动态。
OpenClaw 接入腾讯混元 Hy4 当天在这 2 个平台都能用上,按手上已开通的账号挑一个直接测,不用等单一渠道。
点击打开原文
07
@rohanpaul_ai
Atmanity 发布实时形象模型 Atmee v2,用 1 张照片和 10 秒语音生成可实时视频通话的会说话角色。Atmee v2 负责渲染面部和身体,另一个模型 Causeur 驱动表情和手势跟随对话。发布方称比 Seedance 2.5、Wan 3.0 等视频模型快最多 50 倍、便宜 10-100 倍,开发者凭 atmee.ai 邀请码通过 API 接入。
一张照片加 10 秒语音就能实时视频通话,官方称比 Seedance 2.5、Wan 3.0 快最多 50 倍、便宜 10-100 倍。做虚拟角色对话和数字人直播的可以拿邀请码接 API 试延迟。
点击打开原平台查看,能否访问取决于网络环境
08
@CY160909
开源项目 REA-Video,装好后把视频交给 Agent,自动拆出每个镜头并判断画面是实拍、AI 生成还是代码动效,同时反推每个镜头的 Prompt、运镜方式、剪辑节奏、字幕和音效,最终生成一份带关键帧截图的完整复刻方案。免费开源,支持本地视频分析,GitHub 地址已公开。对做拉片分析、竞品拆解和 AI 短剧流程复用的团队,等于把「看片学做法」这一步自动化了。
给它一条成片,自动拆镜头、判实拍还是 AI 生成,再倒推 Prompt、运镜、剪辑节奏和音效,出一份带关键帧的复刻方案。做拉片和后期拆解的可以装起来跑一遍。
09
@doodi_dev
开源项目 anidoodle 发布,可在 Claude Code、Codex、Grok Build 中调用,用代码生成手绘风格的插画、动画和产品介绍视频。提供圆珠笔、蜡笔、水墨、版画、像素画等 32 种风格,每支片子附带画面被逐笔绘制的过程镜头,配乐同样由代码作曲。新版本加入 three.js 3D 视频、自动配音与字幕,另有一个评审 AI 反复检查并修正结果。Apache-2.0 免费,GitHub 星标 1227,可选装 373MB 真实乐器音色包。
32 种手绘风格、画面逐笔绘制过程自带、音乐也用代码写,还能自动配音加字幕。想不打开剪辑软件就出产品介绍片的,可以拿它跑一条试试。
点击打开原平台查看,能否访问取决于网络环境
10
@PixVerse
PixVerse 官方在 X 上推广其 Canvas 功能,附 app.pixverse.ai/canvas 直达链接,定位为电影创意的起点工具。官方文案只给了一句「每部电影都始于一个创意,用 PixVerse Canvas 创作你的创意」,做 AI 短片前期构思和分镜的可以进 Canvas 页面自己看一遍实际能做什么。
PixVerse 官方放出 Canvas 入口,定位是「每部电影都始于一个创意」的前期构思环节。做分镜和视觉开发的可以点进去摸一遍,看它能不能接在现有出片流程前面。
01
@aiwarts
作者实测用 Grok Bot 搭配 Vercel 开源的 agent-desktop,让一个 Agent 操控本机其他 Agent 和应用,包括用剪映做 AI 剪辑。两条路线对比:amontlabs 的 LCU 走 macOS accessibility API 读界面元素,能识别按钮输入框,但剪映是 Electron 自绘 UI,时间线拖拽区对无障碍接口几乎不可见,指令收不到,平均耗时 4-5 分钟;agent-desktop 走 CGEvent 注入,直接模拟真实鼠标键盘事件,800ms 慢速拖动被剪映当作真人操作,本身是 CLI 不做推理,单独跑零额度消耗,写成脚本回放同样零消耗,只有遇到素材、导出分辨率等可变项才需模型介入。同一段剪辑第一次 13 分钟,第二次 37 秒。缺点是占用窗口,不像 LCU 能后台跑,作者建议配 mac mini。
作者把两条本机操控路线拆开对比:LCU 走无障碍接口读界面,agent-desktop 直接模拟鼠标键盘。同一段剪映剪辑第一次 13 分钟、第二次回放 37 秒,做后期和批量出片的可以照着搭一遍。
02
@Cryptoxorz
开源项目 video-shotcraft 是专为 Claude Code 和 Codex 打造的 AI 视频 Skill,作者 @VincentWei93,已获 16.9k+ Star。对 Agent 说一句「帮我的产品做个宣传片」,它会自动截取真实产品页面与文案,从 124 张镜头配方卡(150 个动效预设,提炼自 Linear、Raycast、Figma 等宣传片)中挑选分镜,用 Remotion 逐帧渲染代码级动画,自动卡点配乐并加 Freesound 音效,交付后带浏览器端编辑器 Motion Workbench,可一键导出剪映草稿二次微调。
16.9k Star 的开源 Skill,从 124 张镜头配方卡里挑分镜、Remotion 逐帧渲染、自动配乐,还能导出剪映草稿再改。做产品宣传片和后期剪辑的可以装起来跑一遍。
点击打开原平台查看,能否访问取决于网络环境
03
@FlowbyGoogle
Google Flow 官方账号给出 5 种电影感运镜提示词与对应场景:crash zoom 用于喜剧或戏剧性冲击,hyperlapse 用于 B-roll 蒙太奇和时间流逝,bullet time 用于定格英雄时刻或展示服装,fly over 用于从角色身后揭示宏大世界,tracking shot 用于跟随奔跑跳跃的主体。核心方法是把运镜动作和这场戏要达成的目的对上,再写进提示词。
官方把 crash zoom、hyperlapse、bullet time、fly over、tracking shot 五种运镜和场景目的对应起来,编导可以直接照着改分镜提示词。
点击打开原平台查看,能否访问取决于网络环境
04
@guanmo_ai
作者用 Opus 5.5 生成分镜架构与程序化算法,画面走 Canvas 2D 实时噪声渲染,声音由 Web Audio API 振荡器与噪声包络合成,最后用 Headless Chromium 加 FFmpeg 逐帧导出成片,全程无图片素材、无视频模型、无音频采样。技术上把角色与场景写进同一套几何设定,用光照方向和值噪声把树冠量化成四五个平涂色块;动画按一拍二每秒 12 帧更新、运镜保持 24 帧,制造动静帧率差;配乐为 F 大调 64 BPM,与画面共用同一条时间轴函数。
不调任何视频模型,靠一个 170KB 的 HTML 单文件在浏览器里实时作画配乐,作者把分镜、Canvas 渲染、Web Audio 合成到 FFmpeg 出片的流程全拆开了。做二维动画和想摆脱抽卡式生成的编导可以看这套确定性做法。
点击打开原平台查看,能否访问取决于网络环境
05
@Morry4AI
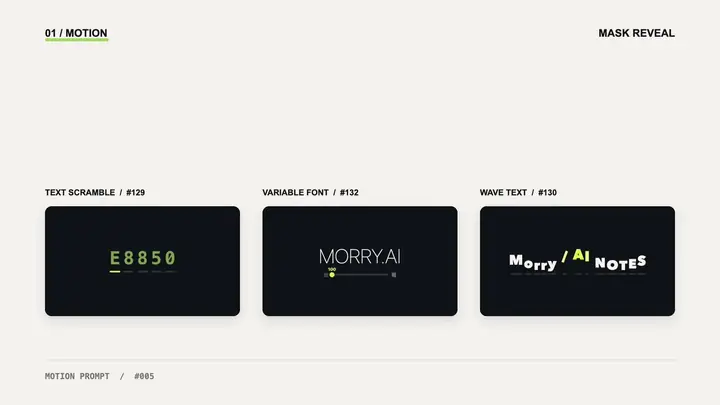
Morry.AI 分享开源动效参考库 motion-prompt,收录 168 种动画效果,覆盖文字动画、镜头运动、UI 交互、网页动效,每种可在线预览并附对应 AI 提示词与实现参考。用法有两种:直接在在线 Gallery 挑效果、复制提示词交给 Codex 配合 HyperFrames Skill 生成;或安装 Skill 后按名称调用、或描述需求让 Codex 先推荐 3 种合适效果再制作。作者用它结合 HyperFrames Skill 做了一段动效视频。
168 种动效每种都配了提示词和在线预览,做片头字卡、转场、UI 动效的可以直接照着抄描述,不用再凭空跟模型形容「要那种弹一下的感觉」。
点击打开原平台查看,能否访问取决于网络环境
06
@hiwise_aigc
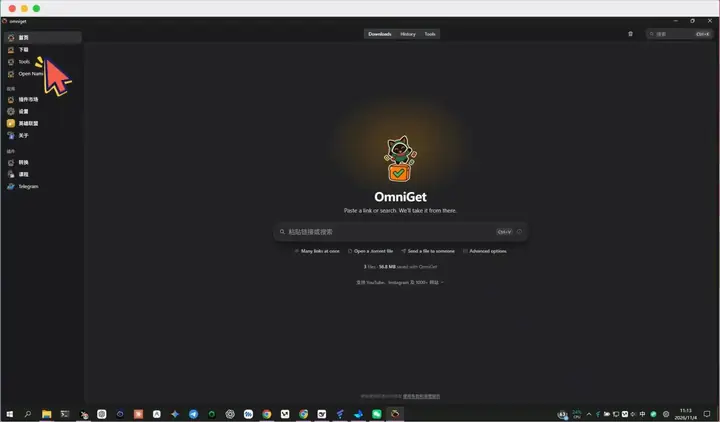
开源工具 OmniGet 支持复制链接直接下载视频,作者实测小红书、抖音、YouTube 均可正常解析,覆盖 X、B站等 1800+ 网站及 Udemy、Coursera 等课程平台,另支持批量下载、字幕提取、音视频转换,Windows/macOS/Linux 三端可用,免费无广告,代码托管在 GitHub。
开源免费的下载工具,小红书、抖音、YouTube、B站都能解析,还带批量下载和字幕提取。做 AI 视频要囤素材、扒参考片的,装一个省掉到处找解析站。
点击打开原平台查看,能否访问取决于网络环境
07
@CuiMao
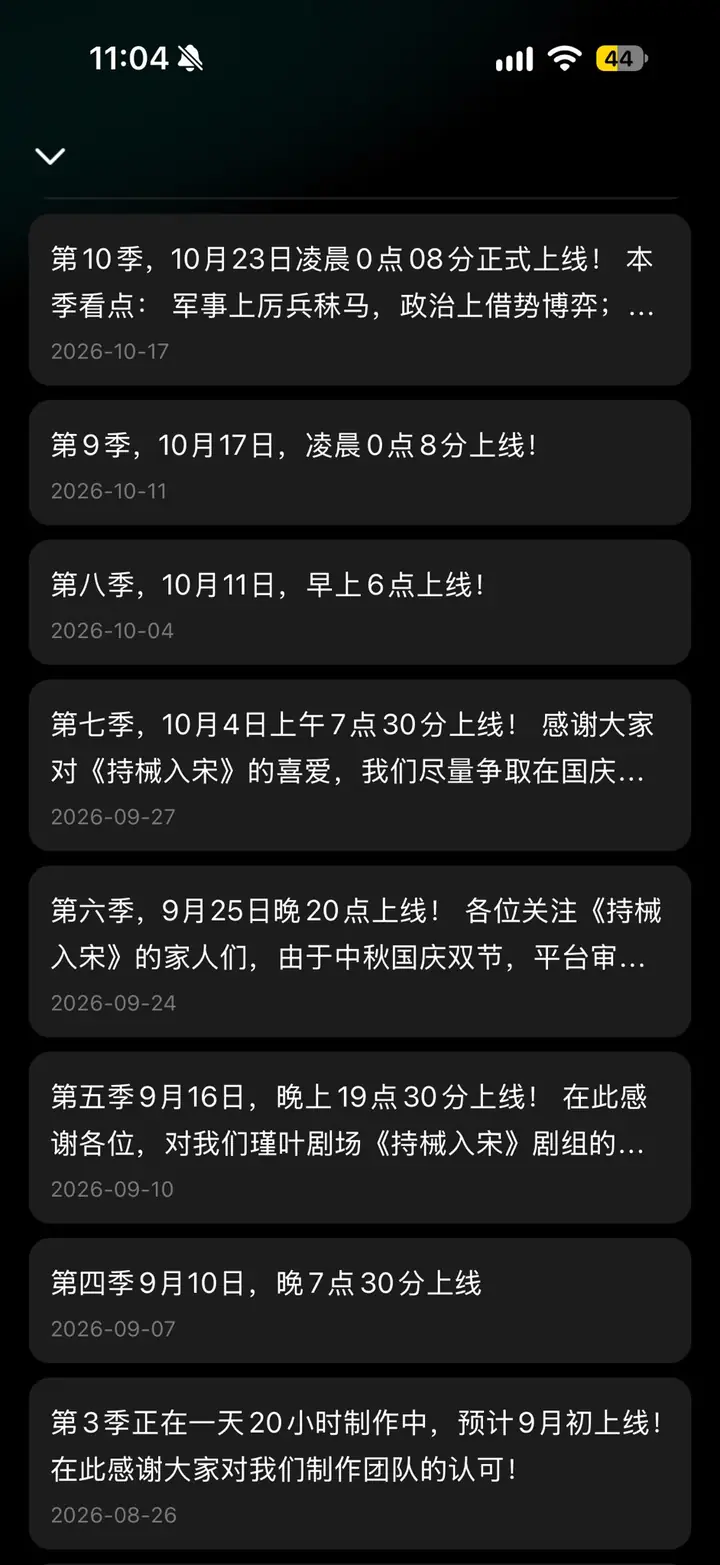
作者 @CuiMao 称看完一千集 AI 短剧《持械入宋》,认为从 Seedance 2.5 起 AI 短剧对真人短剧形成压制:团队更新频率约一周一百集,能呈现战争大场景;做法是投入时间做资产建模并多次抽卡,使外形各异的角色演技达到观看底线。作者还提到期待 3.0/3.5 版本,以及把《飘渺之旅》《搜神记》《诛仙》等网文短剧化。
一位观众看完千集 AI 短剧后的观感:Seedance 2.5 下团队一周出百集、能拍战争大场面,靠资产建模加多抽卡把配角演技拉到及格线。做短剧的可以看看这个产能参照。
点击打开原文,能否访问取决于网络环境
08
@perplexity_ai
Perplexity 官方披露:Computer 为龙虾商 Get Maine Lobster 管理 3 万美元 Meta 广告支出,收入达其常规广告的 3.5 倍,ROAS 高出 63%,表现优于其原代理机构。Computer 自动完成了创意分析、广告制作和媒介购买三个环节。
Perplexity 官方晒的客户案例:Computer 管 3 万美元 Meta 投放,收入 3.5 倍、ROAS 高 63%,创意分析到媒介购买全自动。做投放和制片的可以看它怎么把素材生产和买量串起来。
点击打开原平台查看,能否访问取决于网络环境
09
@EngMoElgaraihy
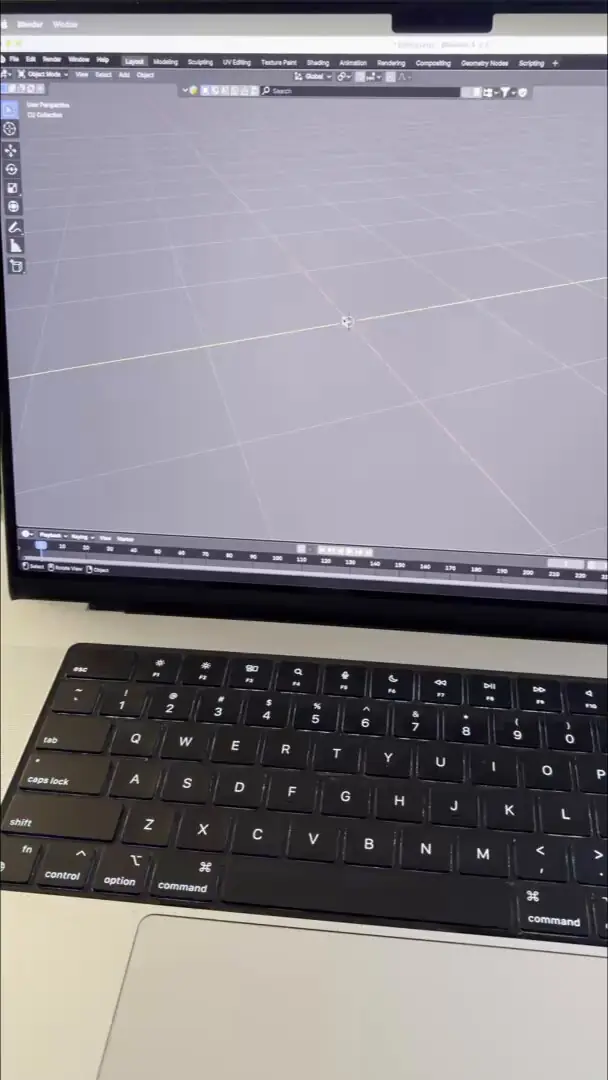
开源项目 Camera to Blender 的工作流:手机拍摄任意实物照片,由 Tripo3D 生成 3D 模型,点「Send to Blender」后模型直接出现在 Blender 中,生成耗时 30-60 秒。GitHub 仓库链接在推文评论区。对需要快速把实拍道具转成三维资产的视觉开发和场景预演环节,这是一条可自己搭起来跑的流程。
手机拍张桌上物件,Tripo3D 生成模型后一键送进 Blender,30-60 秒出结果。做场景资产和道具预演的视觉师可以拿它试跑一遍。
点击打开原平台查看,能否访问取决于网络环境
10
@blak3shao
Blake Shao 把自己做动作图形(motion graphics)提示词的工作流打包成一个技能,开源在 GitHub(StewdioAI/blank-page)。他的定位是「动效版 Midjourney」:输入一个粗略想法,扩写成有表现力的初稿,再在此基础上继续开发。适合卡在动效提示词起步阶段的人拿来当起点。
把动效提示词的门槛压成「给个粗想法就出初稿」,作者开源在 GitHub 上。做片头、字幕动效、视觉包装的可以拉下来跑一遍,看它扩写出来的初稿能不能直接进后期。
点击打开原平台查看,能否访问取决于网络环境