01
@chetaslua
X 用户 @chetaslua 称发现 Google Omni Flash 1.2,列出三项能力:1080p 与 4K 输出分辨率、帧插值、参考与扩展(reference、extend)。该用户同时表示开始征集提示词,想用上一版模型做不好的提示来测新版本。目前信息来自个人爆料,非 Google 官方发布。
爆料称 Omni Flash 1.2 支持 1080p/4K 输出、帧插值和参考扩展,做 AI 视频的可以盯一下这几个能力点,等官方确认后跑一遍看画质和镜头延展稳不稳。
点击打开原平台查看,能否访问取决于网络环境
02
@emmanuel_2m
Scenario 开源 3D OS,把一整套 3D 制作拆成 6 个部门共 80 项技能:动画(任意角色绑定、从视频提取动作)、美术(预演与分镜、角色与生物)、建模(图生 3D、硬表面武器载具)、材质灯光(PBR 材质与重贴图、灯光渲染)、世界(可行走 3D 场景、天空盒与 splat 场景)、流程(重拓扑与 UV 烘焙、游戏可用导出),另有专家工具层直接驱动 Blender、Maya、ZBrush、Unreal、Unity、Godot、Roblox。从一张草图到游戏可用资产,各部门依次交接。运行在 Scenario 上,可接入 Claude Code、Codex 或 Cursor。
把建模、绑定、材质、灯光、预演拆成 6 个部门 80 项技能,还能直接驱动 Blender、Maya、Unreal。做 3D 资产和预演的视觉师可以拉下来跑一遍,看它接不接得上自己那套流程。
点击打开原平台查看,能否访问取决于网络环境
03
公众号:生数科技(Vidu·视频)
生数科技与腾讯云在腾讯全球数字生态大会上签署战略合作协议,围绕视频生成大模型、云基础设施与行业解决方案展开合作。Vidu 全系列模型已入驻腾讯云 TokenHub,上线 Vidu Q4 Preview、Q3 Pro 及 Vidu S2 等模型,其中 Q4 Preview 支持最高 4K 输出、最多 15 张参考图与 3 段参考音频。
Vidu 全系模型进了腾讯云 TokenHub,Q4 Preview 支持 4K 输出、15 张参考图加 3 段参考音频。做短剧和角色 IP 的可以看看多参考图能不能稳住人物一致性,技术整合方则多了一条云上调用路径。
04
@OpenRouter
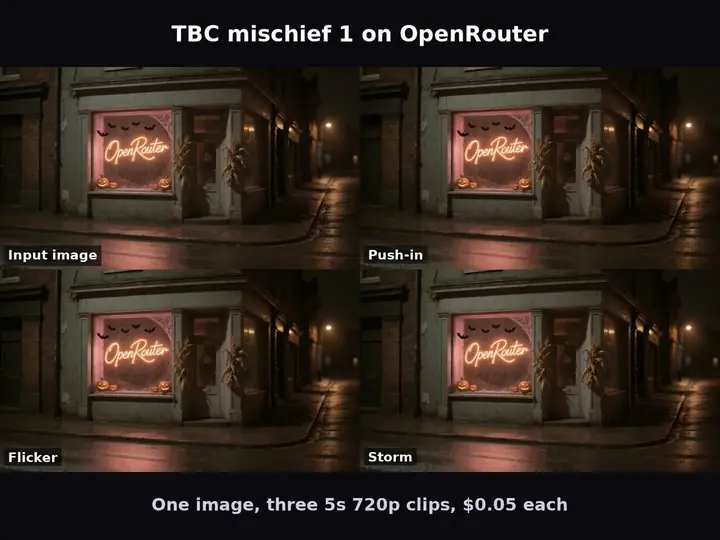
OpenRouter 宣布 The Biological Computing Company 的 mischief 1 模型上线,支持一张起始图加提示词生成 3 秒或 5 秒、480p 或 720p 的视频片段,价格从每秒视频 0.005 美元起,入口为 openrouter.ai/tbc/mischief-1。该模型基于该公司四年脑细胞电极培养研究。
每秒 0.005 美元、480p/720p、3 或 5 秒片段,价格低到可以拿来做批量试错。技术整合者可以接 API 跑一轮,看这种脑细胞培养出来的模型出片稳不稳。
点击打开原平台查看,能否访问取决于网络环境
05
@ArtificialAnlys
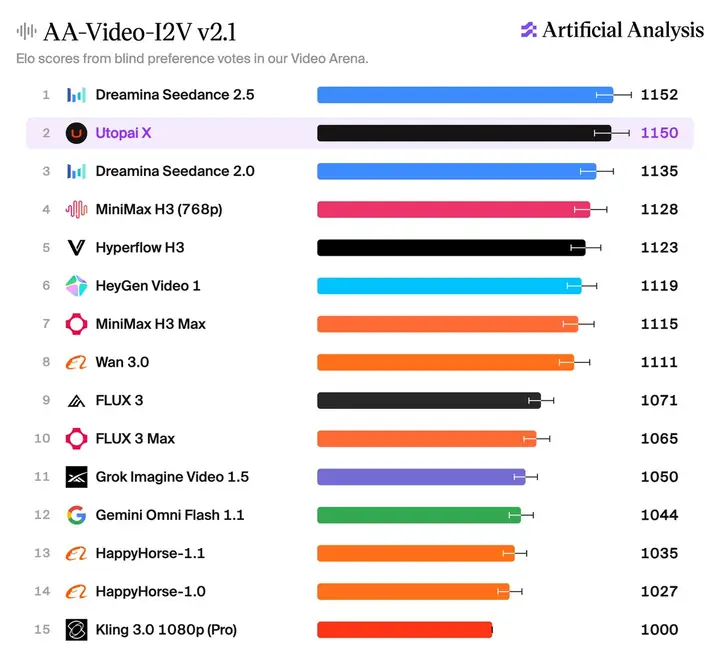
Artificial Analysis 榜单显示,Utopai Studios 基于 MiniMax H3 后训练的 Utopai X 在 AA-Video-I2V v2.1 排第二,仅次于 Dreamina Seedance 2.5,是唯一同时进入图生视频与文生视频两个榜单前二的模型,也是 H3 系里排名最高的(高于 MiniMax H3 768p、Hyperflow H3、MiniMax H3 Max)。官方测试称其在物理、多场景与叙事类提示词,以及 Frontier、UI/UX 与动效设计、生产力场景表现更好。目前只在 Utopai 自家制作平台 PAI 内可用,1080p 每秒 93 PAI credits,无公开 API,PAI 订阅 15 美元/月起含 1000 credits。
基于 MiniMax H3 后训练的 Utopai X 在 AA 图生视频榜排第二,仅次于 Seedance 2.5,物理和多场景叙事提示词表现最好。做短剧和分镜的可以拿它跟 Seedance 对跑同一批镜头。
点击打开原平台查看,能否访问取决于网络环境
06
@PixVerse
PixVerse 官方宣布 PixLight 2026 征片 10 月 31 日截止,仅剩 1 天,奖金池 30 万美元,分 Pilot 赛道与剧本赛道两条投稿路径,投稿链接随推文给出。有已完成成片或剧本项目的创作者需在截止前提交。
PixVerse 官方征片只剩一天,30 万美元奖金池分 Pilot 和剧本两条赛道,手上压着成片没投的编导和短剧团队今天就得交。
点击打开原文,能否访问取决于网络环境
07
@ArtificialAnlys
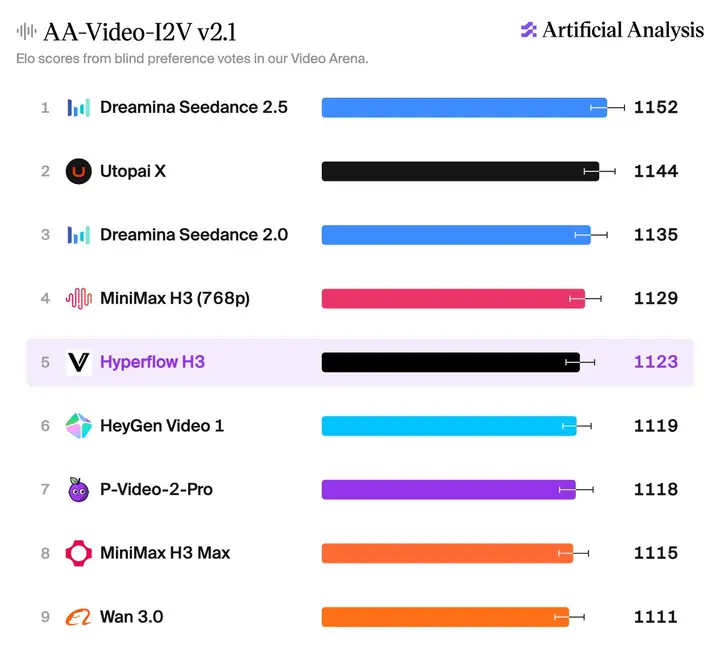
Artificial Analysis 榜单显示,Video Rebirth 的 8 步 LoRA Hyperflow H3 在 AA-Video-I2V v2.1 排第 5、AA-Video-Editing v1.1 排第 3,两项价格均不到 Dreamina Seedance 2.5 的一半。8 步出图意味着单条生成步数少,配合低价对高频出片和反复改片的场景有成本优势。
8 步 LoRA 的 Hyperflow H3 在 I2V 和视频编辑两个榜分别排第 5、第 3,价格还不到 Seedance 2.5 的一半。做批量出片和后期改片的可以拿它跟现用模型比一轮成本。
点击打开原平台查看,能否访问取决于网络环境
08
GitHub Trending (AI)
GitHub 上的 EntranceStarfish/VoiceStudioV2 是 VoiceStudio 的非官方分支,把实时变声、文本转语音、声音克隆和配音四项能力打包成本地语音工作室,完全离线运行,不需要云端服务和 API key,并提供可直接替换的 OpenAI 兼容接口。做 AI 短剧配音、后期声音替换和批量旁白的团队,可以把它接进现有流程里试离线出活的质量和速度。
变声、配音、克隆、TTS 全塞进一个本地跑的包里,还带 OpenAI 兼容接口,做 AI 短剧配音和后期声音的可以拉下来跑一遍,看离线出活稳不稳。
点击打开原文
09
@acroqube
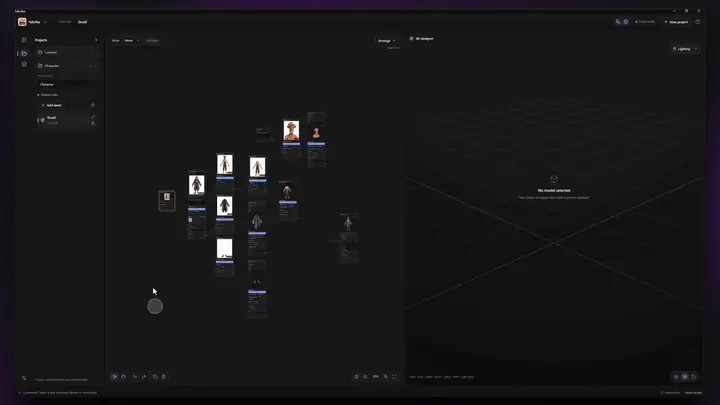
开发者 Zvezdan(@acroqube)发布自建 3D AI 工具 Fabrika,采用节点式工作流,内置 3D 视口与配套工具,作者称仍处早期阶段但已具备一定能力。定位是替代他本人不满意的现有 3D AI 工作方式。
个人开发者嫌现有 3D AI 流程不好用,自己搭了个带 3D 视口和节点编辑的工具,目前还在早期。做 3D 资产和场景的可以收藏着看后续。
点击打开原平台查看,能否访问取决于网络环境
01
@leaf_sanren
作者用 Claude Code 写代码直接生成剪映草稿,推送到剪映 v11.7 后可在 App 首页打开,进入图层手动微调字幕、转场、画中画等效果,成片即演示视频。作者称不走剪映官方接口,而是按 v11.7 的加密方式写入草稿,代码已开源在 GitHub(YeJe-cpu/easy-jianying)。对后期的价值在于把 AI 生成的结构化剪辑结果落进熟悉的剪辑软件里改,避免整段重渲染。
用 Claude Code 生成剪映草稿文件,炫技、字幕、转场、画中画全在代码里排好,进剪映再手动微调图层,省掉反复重渲染的等待。后期和做批量短剧的可以扒开源码跑一遍。
点击打开原平台查看,能否访问取决于网络环境
02
@Kling_ai
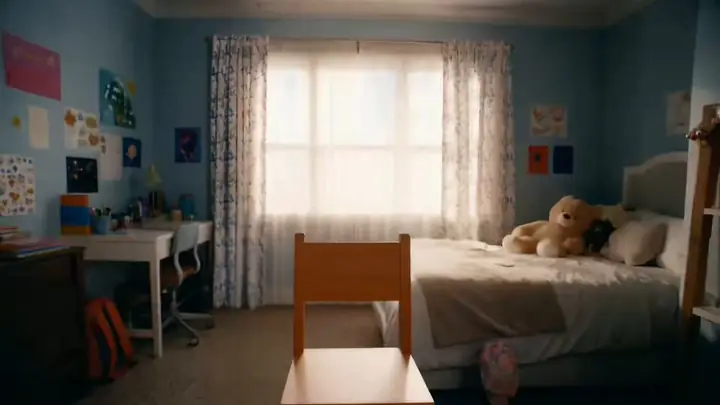
可灵转发 Simon Meyer 团队用 Kling 4.0 制作的万圣节 AI 短片,团队公开了制作流程:花两周时间反复迭代怪物、场景和风格的首帧;提示词只写谈话要点而不写死台词,让模型即兴作答;用 Kling Flash 快速生成多个镜头版本再挑最佳。
两周磨首帧、提示词只写谈话要点让模型即兴接话,这套做法对拍对话戏的编导有直接参考价值,可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
03
@Saccc_c
作者称通过 Renoise MCP 接入 Codex 等 Agent,可自动完成分镜规划、视频素材生成、剪辑、配乐到渲染出片的全流程,内置产品宣传片、3D 动画等视频 Skill,不写专业提示词也能复用现成工作流。文中演示用 Codex + Renoise MCP 三句话复刻国外爆款宣传片的镜头节奏与视觉风格,并做了一支麦当劳广告短片;另列出一句话生成产品宣传片、知识科普动画、口播自动精简配动态字幕三个场景。
作者用 Codex 接 Renoise MCP,三句话复刻爆款宣传片节奏并做了支麦当劳广告,分镜、素材、剪辑、配乐、渲染一条流程走完。做后期和接商单的可以照着跑一遍看质感够不够。
点击打开原平台查看,能否访问取决于网络环境
04
@PixVerse
PixVerse 官方发布一条 30 秒 16:9 写实冒险惊悚片提示词,用 4 张参考图分别锁定美洲豹、雨林、瀑布水潭和背包客,要求全程保持人物身份、服装、花纹与背包一致。提示词按 0–5s 到 26–30s 分七段给出镜头调度,从美洲豹突袭、泥地摔倒到跳入水潭逃生,并规定自然滤光、电影感对比、硬切与正常速度,无对白和文字。
官方给了一份能直接抄的完整分镜提示词:4 张参考图锁角色和场景,七段时间码写清镜头调度。做 AI 短片和动作戏的可以拿去跑一遍,看多镜头一致性稳不稳。
05
@elvar_official
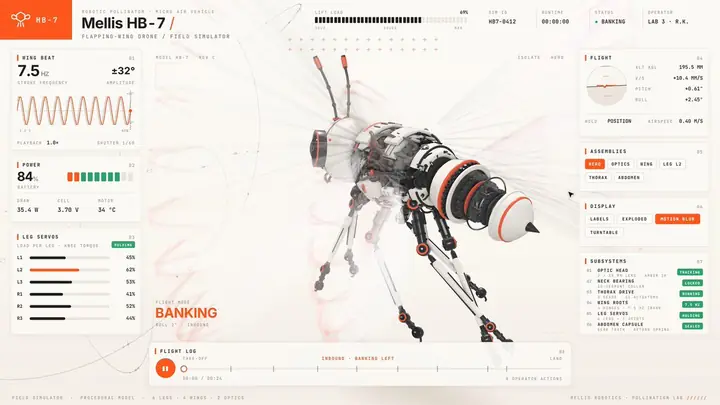
作者 Elvar 把整套 3D 工作流打包成一个 Claude 技能,给 Opus 5.5 一张参考图,要求把每个部件都用代码实现:外壳、齿轮、软管全部是 three.js 代码,大齿轮下藏了 260 个活塞、螺丝和线缆。出片前先让模型把渲染结果与原图并排比对三轮;第一版只是悬停,改成每 2-3 秒拆开一个部件,拉一条腿对应伺服杆就翻成 DETACHED 状态。两天做了 7 个,模拟已上线 playground,技能、playground 和 9 条 prompt 一并公开。
一张参考图让 Opus 5.5 用 three.js 把每个零件写成代码,还先对着原图比三轮渲染再出片。做视觉开发和机械/产品类镜头的可以看看这套拆解思路。
点击打开原平台查看,能否访问取决于网络环境
06
公众号
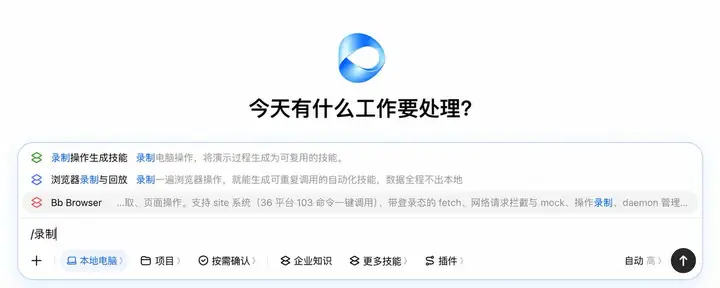
豆包工作新增类似 Codex 的录制回放功能:录制电脑操作并配语音讲解,AI 生成步骤后复刻执行,最长录制 30 分钟。作者实测发现用户占用窗口时它会主动暂停而非重试,适合没有 API、跨多软件的工作流;作者用它录制随机跨平台浏览节奏采集小红书低粉爆款内容,降低风控检测概率,并计划把 Codex 上做好的 skill 迁移过来省额度。
录一遍电脑操作配语音,AI 自己复刻成可重复执行的步骤,最长 30 分钟。没有 API 的跨软件流程、素材采集这类脏活可以交给它跑。
点击打开原文,能否访问取决于网络环境
07
@hiwise_aigc
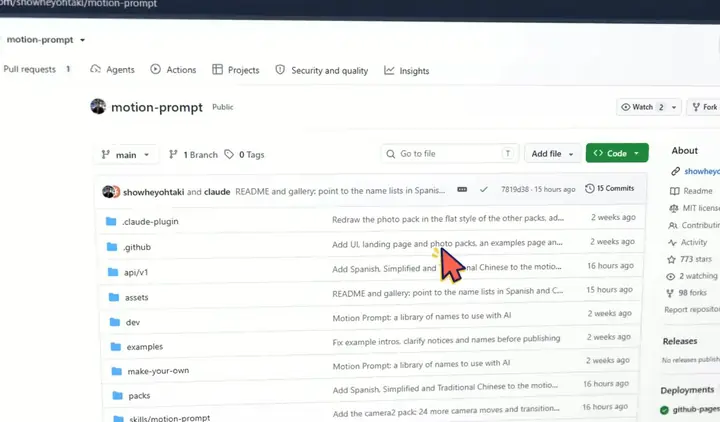
作者启明破晓推荐开源 Skill「Motion Prompt」,把各类动画、运镜、转场、UI 动效整理成可视化案例库,看到想要的效果可直接取用对应提示词与实现参考交给 AI,减少反复描述。安装命令为 npx skills add showheyohtaki/motion-prompt,项目地址 showheyohtaki.github.io/motion-prompt,面向 Claude Code、Codex 等 Vibe Coding 场景。
把动画、运镜、转场、UI 动效做成可视化案例,看到哪个顺眼就把提示词和实现参考丢给 AI,省掉「高级一点、丝滑一点」这种无效沟通。用 Claude Code、Codex 做动效的可以装一个试试。
点击打开原平台查看,能否访问取决于网络环境
08
公众号
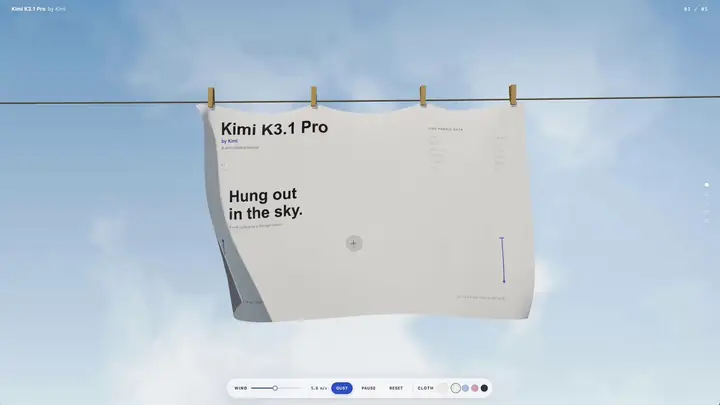
月之暗面官方介绍 Kimi K3.1 Pro 的 3D 创作教程(该产品 10 月 24 日已发布),区分参数化建模与网格化建模两种方式及对应工具选择,给出 4 个案例的具体操作:Unreal Engine 里搭东方天宫、做可 3D 打印的台灯、纯代码调用 Blender 生成建筑、用 Tripo 加 Blender 搭微缩城市,另附「图胜于言」「先搭灰模再细化」等 5 条使用技巧。
月之暗面官方拆了参数化建模和网格化建模两条路,四个案例从 Unreal 天宫到可 3D 打印台灯都有具体操作。做场景概念和美术预演的可以照着跑一遍,看能不能替掉一部分手工建模。
点击打开原平台查看,能否访问取决于网络环境
09
@hx831126
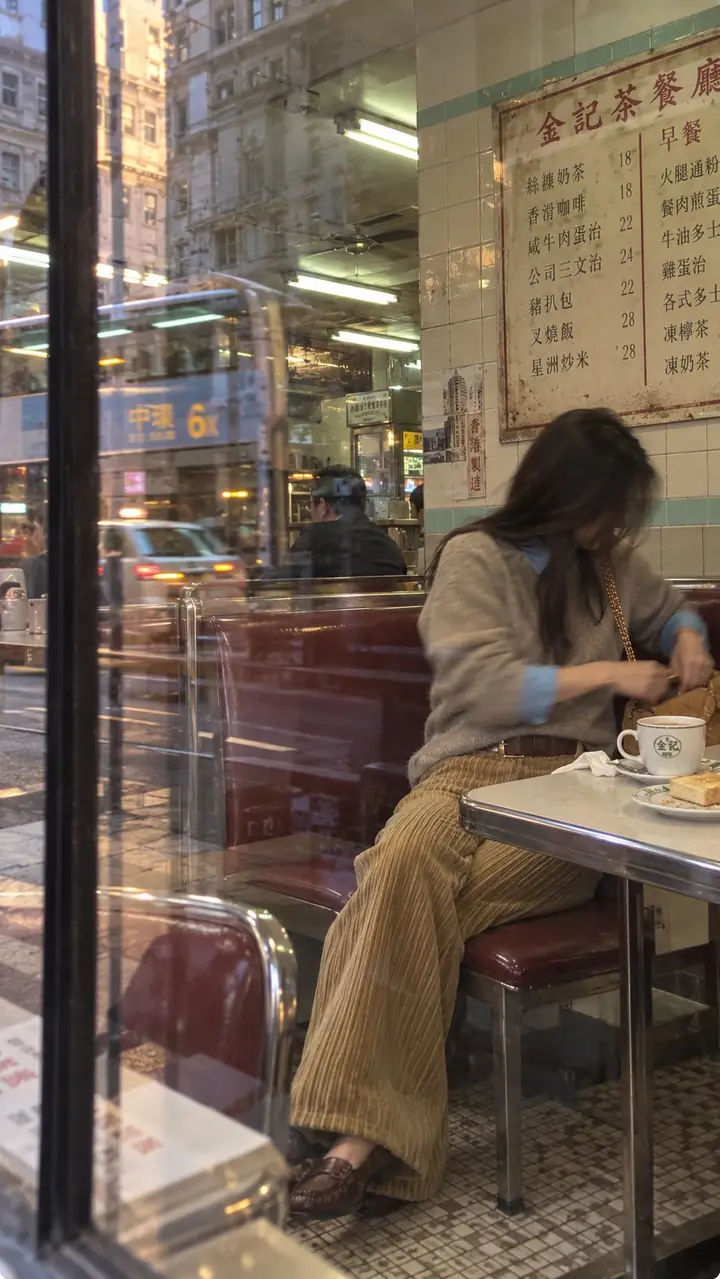
作者对比了自己前后两版出图提示词:早期写「iPhone 拍摄、35mm 等效焦距、柔和侧逆光、对角线构图、人物在右三分之一」,现在改用一套 JSON 编译器,只输入临时想到的变量,核心逻辑是「画面先有事情发生,再被手机偶然拍下来」——先设想一个不为摄影而存在的生活瞬间(追公交、被朋友叫住、边走边整理购物袋),拍摄者恰好在场按下快门,模糊、遮挡、偏斜、裁切、视线才各有成因。文中还引述 OpenAI 2026 年 10 月 2 日 GPT-6 使用指南的说法:模型越擅长理解细微差别与模糊信息,过度具体的指导反而可能妨碍结果,建议优先给目标、背景、约束和完成标准。作者把这种转变概括为从「指令控制」转向「意图与条件设计」。
把「模特站着等拍」换成「她正在追公交、被朋友叫住」,模糊和裁切才有理由。做视觉开发和 KV 的可以拿这套思路重写自己的提示词模板。
点击打开原文,能否访问取决于网络环境
10
@AlchainHust
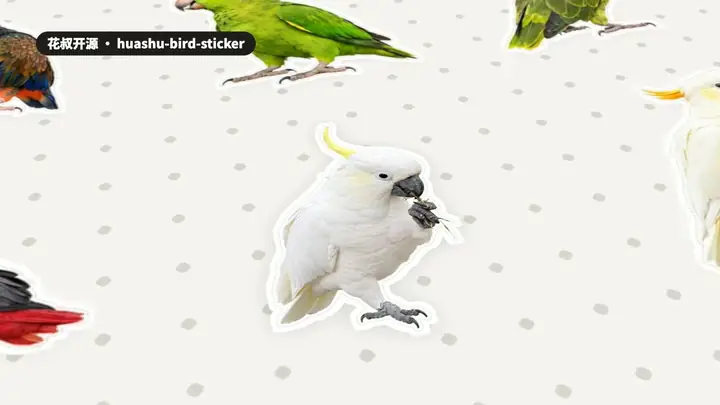
花叔(@AlchainHust)用 Claude Code + Codex 为地球上全部 11,064 种现存鸟类各生成一张贴纸,基于真实参考照片绘制,附 43 种语言名称和物种数据,全部开源在 GitHub 免费使用。流程上由 AI 绘制后交给另一个独立 AI 审查员评分,7,676 种通过标准、3,388 种未通过,数据中标明哪些不合格。作者称消耗 1B+ tokens。
11064 张贴纸全流程 AI 生成,再用另一个 AI 当审查员打分,7676 张过线、3388 张被刷掉。做批量素材和风格统一的视觉团队可以看这套「生成+自动质检」怎么搭。
点击打开原平台查看,能否访问取决于网络环境