01
Hacker News
Mistral 公开旗舰模型 Mistral Large 4(代号 Le Chonk)的权重,1 万亿参数、原生多模态,此前处于公开预览阶段。官方称根据预览期反馈继续扩大强化学习,在编程和防御性安全上大幅提升,推理效率也有明显改善、降低推理成本,并提供三种推理模式平衡成本与性能。模型完全开源、欧洲训练,支持自托管和定制部署。
1 万亿参数、原生多模态、三种推理模式,主打编程和防御性安全,欧洲训练可自托管。做创作工具链的可以留意它能不能接进自己的流程,拍片的先放一放。
点击打开原文
02
@elevenlabs
ElevenLabs 发布 SFX v3 音效生成模型,只需一段文本提示词即可生成音效,官方称可处理的内容范围比前代更广,音乐与人声生成质量同步提升,已在 ElevenCreative 和 ElevenAPI 上线。做后期和声音的可以直接在 ElevenCreative 里试复杂场景音效,或通过 API 接进批量配音配乐流程。
音效模型升到 v3,官方说能处理「前所未有的更多内容」,音乐和人声也一起提了。做后期的可以拿一段大场面戏试,看复杂场景下还能不能一层层叠出层次。
点击打开原平台查看,能否访问取决于网络环境
03
@krea_ai
Krea AI 发布 Ad Studio 广告创作工具,由新的 Krea 3 广告专家模型驱动,输入品牌链接即可批量生成数十条广告,官方称与品牌和产品保持完全一致,现已开放免费试用。对做品牌物料和电商投放的团队,值得实测批量出图的风格统一度和可用率。
贴一个品牌链接就出几十条广告,还强调品牌和产品一致性,做电商投放和品牌 KV 的可以拿自己客户试一轮,看废片率。
点击打开原平台查看,能否访问取决于网络环境
04
@arthurmensch
Mistral CEO Arthur Mensch 宣布发布改进版 Le Chonk 开放权重,方向是智能体编码与网络安全。该模型在 Cognition 的 FrontierCode 上位列开源模型第一,在 Artificial Analysis 上创下 Pareto 效率新基准;网络防御能力经 CrowdStrike、Cloudflare、Rubrik、Zscaler 等厂商测试。权重已在 Hugging Face 开放下载,支持用 Mistral Forge 定制并自行部署。
主打智能体编码和网络安全的开源模型,跟拍片剪片不沾边,做创作工具链底层开发的可以瞄一眼权重。
点击打开原文,能否访问取决于网络环境
05
公众号:昆仑万维(天工)
昆仑万维 10 月 29 日发布 2026 年三季报:前三季度营收 89.37 亿元,同比增长 53.96%,归母净利润扭亏;天工 AI 业务收入 43.21 亿元,同比增长 168.29%,其中 AI 短剧单月流水接近 1 亿美元。这是国内厂商首次把 AI 短剧的流水规模单独摆到财报口径里。
AI 短剧单月流水近 1 亿美元、天工 AI 收入同比涨 168%,这是目前公开数据里少见的短剧变现样本,做短剧和管钱的都该看一眼这个盘子有多大。
06
@SamuelZengML
Edge0_AI 发布开源权重语音模型 Audio8-TTS-Realistic,601M 参数,支持零样本语音克隆——一段短音频即可复刻音色,覆盖 23 种语言,主打类人韵律和富有表现力的表达,体积小到可自行微调与低成本部署。目前位列 Hugging Face TTS Arena 第一(盲听投票),权重已在 Hugging Face 开放下载并可免费试用。
0.6B 参数就能一段短音频克隆音色、覆盖 23 种语言,权重已挂在 Hugging Face 上,做 AI 配音和短剧对白的可以拉下来跑一遍听废音率。
点击打开原平台查看,能否访问取决于网络环境
07
公众号:生数科技(Vidu·视频)
生数科技官方公众号消息:Vidu 与 updream 合作,把 Vidu Q4 Preview 原生模型接入 updream 的 AI 视频创作流程,围绕镜头时序、跨镜角色一致性、高动态动作生成三项指标做全流程验证。这三项正好对应漫剧连续分镜里最容易崩的地方——镜头接不接得上、角色换镜后还是不是同一张脸、打斗和大动作会不会糊。
Vidu 官方号宣布 Q4 Preview 原生模型接进 updream 的创作流程,验证镜头时序、跨镜角色一致性、高动态动作三项。做 AI 漫剧和系列短剧的可以盯这三点看实测。
08
Tripo
Tripo 发布 Tripo Agentic Canvas,用户描述需求后由 Agent 规划、串联并执行工作流,直接产出 3D 资产,无需在多个工具间切换。画布支持批量处理与可复用流程,一次设定可产出多个资产;并可通过 AI 3D Lab 完成资产检查、精修、绑定与编辑。目前处于 beta 阶段,面向所有 MAX 和 Team 用户开放,其他用户逐步放开。
描述需求后 Agent 自己规划并跑完流程直接出 3D 资产,还能批量跑同一套流程、在画布内做检查精修和绑定。做美术资产和虚拟场景的可以申请 MAX 账号试一轮,看批量出件的稳定性。
点击打开原文,能否访问取决于网络环境
09
@ArtificialAnlys
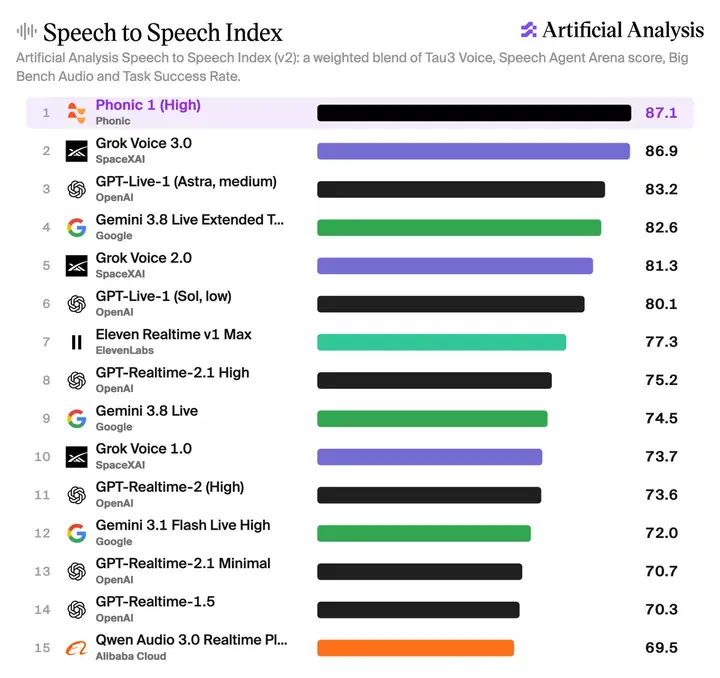
Artificial Analysis 评测 Phonic 的 Phonic 1 (High),以 87.1 分在 22 个模型中登顶语音到语音指数,微弱领先 Grok Voice 3.0(86.9)。分项上 Tau Voice 智能体任务以 79.9% 排第一、领先第二名 5.4 分,Big Bench Audio 98.9% 排第三,首字延迟 0.61 秒为指数前五中最快。价格 $0.07/分钟,折合每小时输入音频 $4.20,通过 Phonic API 调用。
语音到语音榜第一,87.1 分只领先 Grok Voice 3.0 0.2 分,但 Tau Voice 智能体任务领先第二名 5.4 分、首字延迟 0.61 秒。做 AI 配音和虚拟角色对话的可以接 API 测一轮。
点击打开原平台查看,能否访问取决于网络环境
01
公众号
可灵AI实战测评室邀请创作者阿米Amir用Kling 4.0制作粤语温情短片《得闲饮茶》,检验慢节奏情感叙事表现。反馈要点:单次原生输出 30 秒(3.0 最长 15 秒)、全能参考、多关键帧最多 10 张图,动作与节奏安排余地更大;12 个角色资产一致性比 3.0 更稳,粤语对白与口型匹配出色;新增 21:9 画幅。
可灵官方实测室请人用 4.0 拍了部粤语温情短片,30 秒原生输出、最多 10 张关键帧、12 个角色资产一致性比 3.0 稳,做慢节奏情感短剧的可以照着这套参数跑一遍。
点击打开原平台查看,能否访问取决于网络环境
02
@dustinhollywood
创作者 Dustin Hollywood 给出 AI 长片的积分测算:Seedance 2 生成 776 个镜头、90-100 分钟剧情片长度内容约需 160 万积分(上下浮动几千),Seedance 2.5 覆盖约 98 分钟约需 260 万积分,均为 720p 输出。这是按镜头数折算的整片成本口径,可直接用于估算单分钟积分消耗与预算规模。
有人把 AI 长片的账算出来了:776 个镜头、90-100 分钟、720p,Seedance 2 约 160 万积分,2.5 约 260 万。做 AI 长片和短剧的制片可以拿这个数直接倒推预算。
03
AIHOT 全部动态
作者用 Qwen3-TTS 给自建游戏做旁白,1.7B-Base 从 28 秒参考音频提取 2048 维说话人嵌入,加权平均混合出独特音色;把克隆嵌入传入 1.7B-CustomVoice 后可用指令控制情绪(悲伤、低语),效果超出预期。另演示用 14 对男女声求平均得出「性别轴」来移动音色,并测试了嵌入做说话人识别的效果。Qwen3-TTS 分 Base(克隆)、CustomVoice(九个内置音色+指令)、VoiceDesign(文字描述造声)三类模型。
28 秒录音提 2048 维说话人嵌入,加权平均能混出新音色,再喂给 CustomVoice 就能下「悲伤」「低语」这类指令。做游戏配音和 AI 短剧声音的可以照着跑一遍。
点击打开原文
04
@umesh_ai
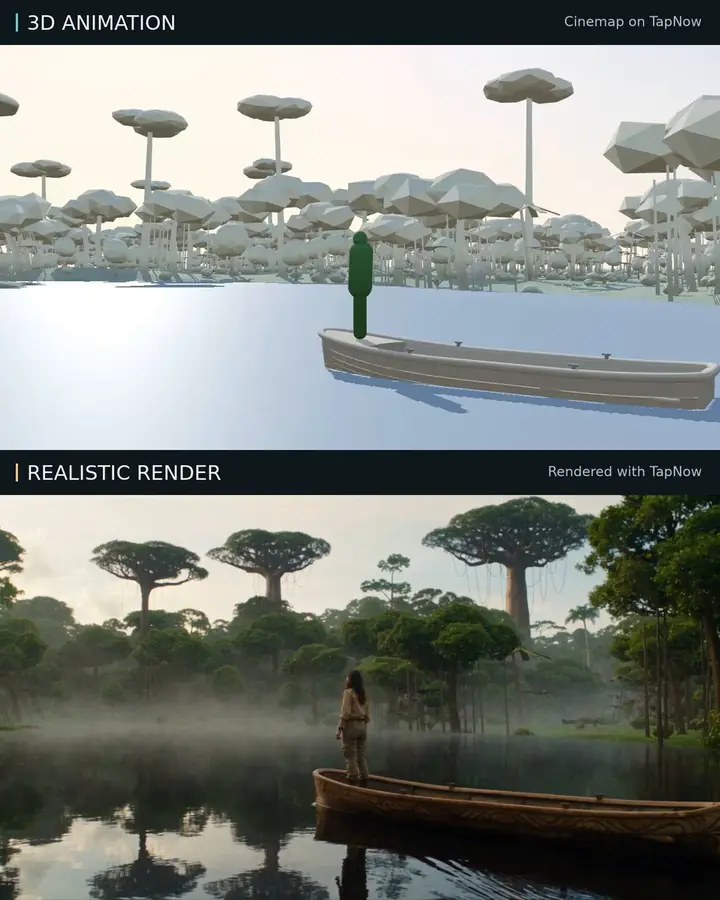
作者 Umesh 用语音命令起头,在 CineMap 里搭出 3D 雨林世界,再把它作为参考图送进 TapNow 做写实渲染,得到最终画面,并附上了完整工作流。这条的价值在于「先用 3D 定构图和机位、再交给生成模型出质感」的两段式做法,比纯文生视频多一层可控性。
语音起手、CineMap 搭 3D 世界当参考、TapNow 出写实渲染,一条从场景到成片的流程。做视觉和分镜的可以照着跑一遍,看 3D 参考能不能把镜头控制住。
点击打开原平台查看,能否访问取决于网络环境
05
@tejasdkulkarni
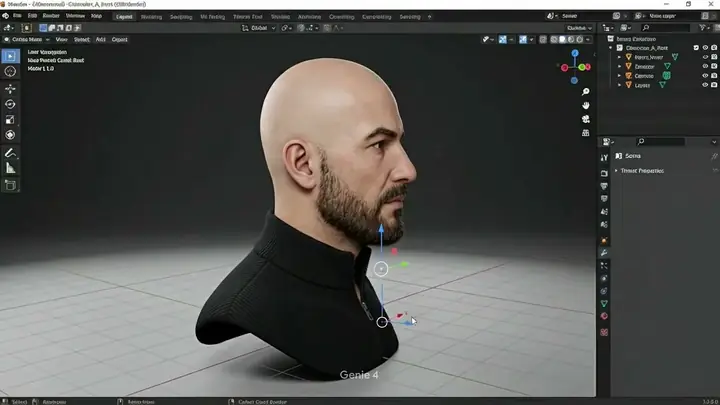
Tejas Kulkarni 发推展示用 Genie 4 实时模拟 Blender,附一段演示,展示的是世界模型对 3D 软件界面的实时模拟能力,不是影视成片。
Genie 4 被拿来实时模拟 Blender 界面操作,属于世界模型跑软件交互的玩法演示,不是出片工具。做 3D 和预演的可以点开看看它模拟到什么程度。
点击打开原平台查看,能否访问取决于网络环境
06
@HERANAM381471
韩国创作者 Director Hera 发布一套 Wan 3.0 提示词技能包,结构参考 Seedance 2.5 的工作方式,覆盖情感表演、相机动线、照明与声音、参考图像和参考视频各自的作用,并附电影、广告、音乐视频三类示例以及按结果反推的修改方法。可在 Codex 中调用,也可直接让 AI 读取这份指令使用。作者注明这是非官方社区技能,实际出片质量尚未测试。
把情感表演、相机动线、灯光声音、参考图作用拆成可套用的提示结构,还带电影/广告/MV 示例和改法。写分镜提示老卡壳的编导可以拿来当模板改。
07
@underwoodxie96
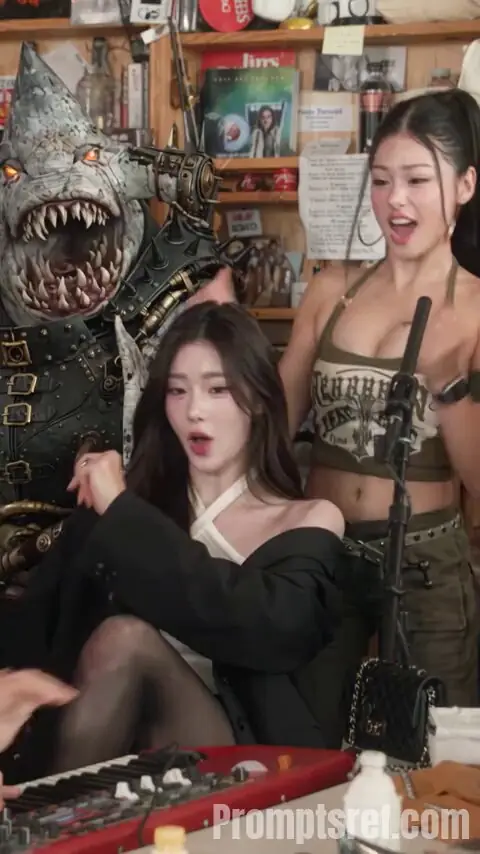
作者演示用 4 张照片把乐队成员和特写主唱替换进一段 Tiny Desk 演出片段,保留原剪辑点、机位和原声,无需写 prompt,附有工具入口链接。对做音乐类短视频和 MV 的后期来说,这种「原片不动只换人」的做法可以直接套到翻唱、乐队宣传片上。
拿 4 张照片把乐队和主唱换进现成演出片段,剪辑点、机位、原声全保留,做 MV 和翻唱视频的可以试这套换人流程。
点击打开原平台查看,能否访问取决于网络环境
08
@PixVerse
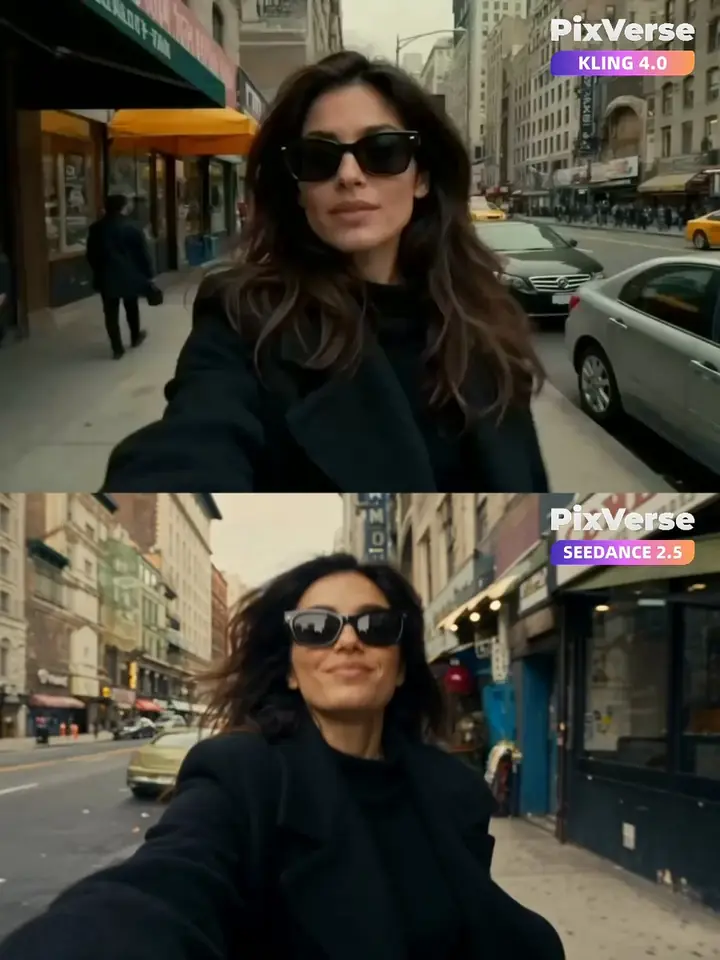
PixVerse 官方账号发起一场模型对比:用同一段 POV vlog 提示词,分别跑 Kling 4.0 与 Seedance 2.5,成片并列展示并公开完整提示词,邀请用户投票选优。对做第一人称视角短片和 vlog 的创作者,这是一组同条件对照样本,可用来判断两个模型在运镜、人物视角和画面质感上的差异。
同一段 POV vlog 提示词喂给 Kling 4.0 和 Seedance 2.5,在 PixVerse 上直接对打,选型纠结的可以看两边出片差异再决定押哪个。
点击打开原平台查看,能否访问取决于网络环境
09
@MeshyAI
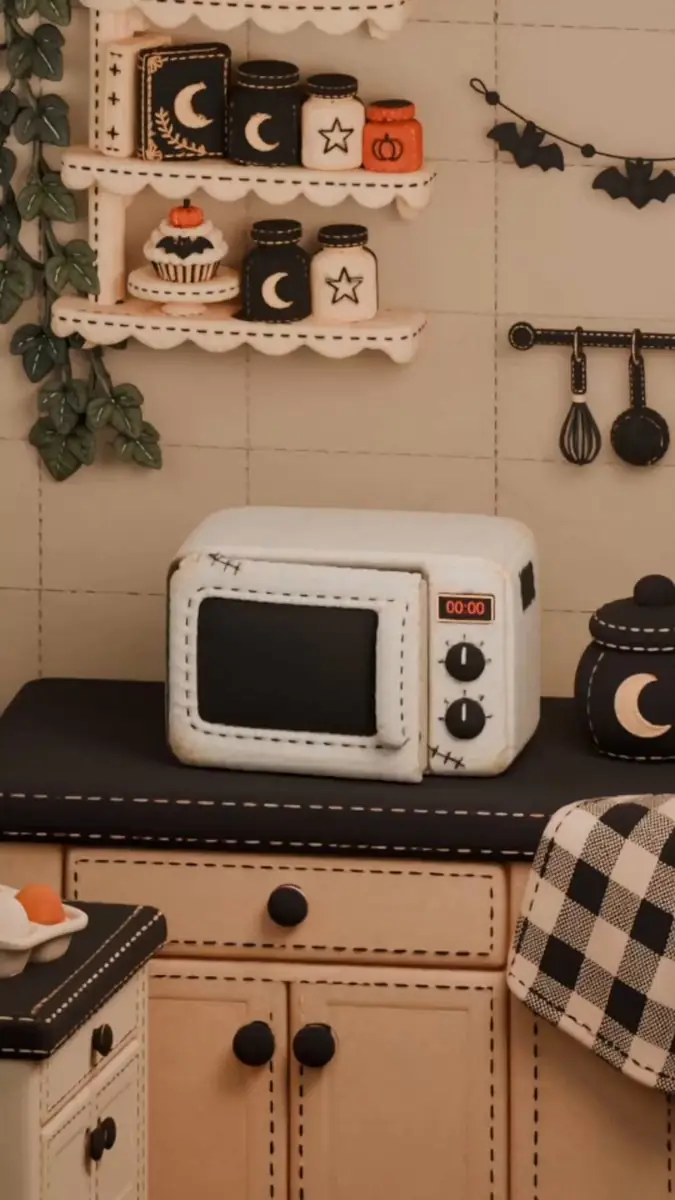
Meshy 官方账号展示一条万圣节厨房小动画:Meshy 生成小猫变身前后两个 3D 模型、微波炉和全部厨房道具,Blender 负责场景布局、材质、灯光、动画与最终渲染,成片是「可爱小猫进微波炉、邪恶小猫出来」的变身梗。做 3D 动画和道具资产的可以看它怎么把 AI 建模塞进传统 Blender 流程。
Meshy 出小猫前后对比模型和微波炉道具,Blender 管布局、材质、灯光、动画和渲染,做 3D 向短片和道具资产的可拆这套分工。
点击打开原平台查看,能否访问取决于网络环境
10
Luma AI Blog
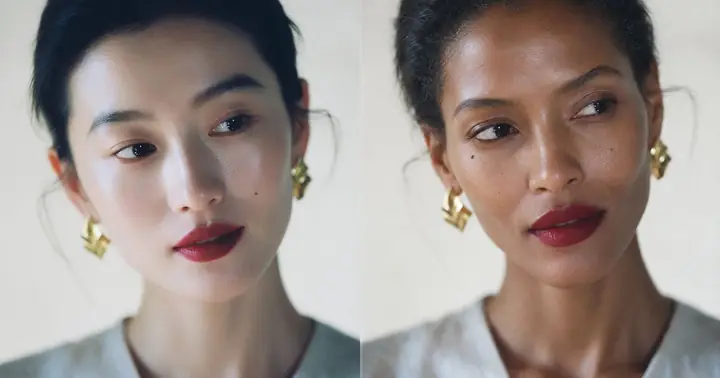
Luma AI 博客文章讨论用 AI 换脸技术做广告本地化:一条已通过的广告图可衍生出多个地区版本,一张主视觉可支撑一批 A/B 测试素材,减少为每个市场单独组织拍摄。文中提到时尚品牌可借此降低重复制作成本,个性化广告结合场景定向投放可实现 2 倍 ROAS,并强调商用换脸需要同意书与披露流程。
讲的是用 AI 换脸把一条已通过的广告素材改成多地区版本、省掉重拍,做品牌广告和投放物料的制片可以看看思路。
点击打开原文