01
@dotey
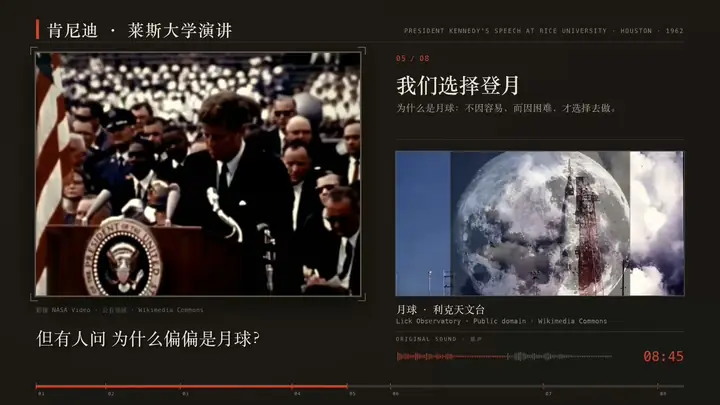
宝玉(@dotey)分享 BaoCut Skill,配合 BaoCut App 完成转录与对齐翻译,用一句自然语言指令即可产出横版版面视频:演讲画面只占局部、配双语字幕、按内容生成章节副标题,并自动检索相关历史图片填入版面,整体走档案馆/纪录片风格。Skill 说明文档已开在 GitHub 的 JimLiu/baocut 仓库 skills/baocut/SKILL.md。做访谈、口播、知识类长视频的后期可以拿它试排版自动化。
把「演讲画面缩到局部 + 双语字幕 + 章节副标题 + 自动配历史图」这套排版交给一句话指令,做访谈、口播、知识类视频的后期可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
02
@tobiadonadon_
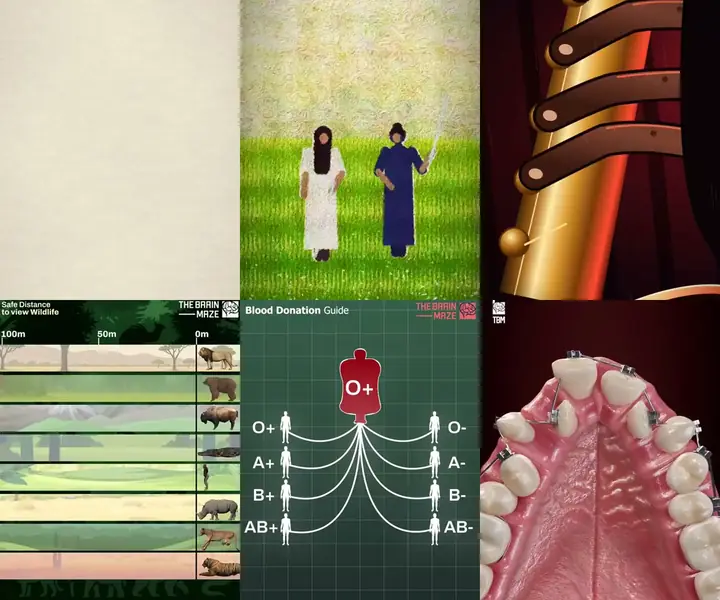
作者 @tobiadonadon_ 用 Claude 搭了一套自动化动画工作流技能:输入一段诗、一句引语或一个故事,再描述想要的画风(油画、水彩、蜡笔、水墨、绘本),它会逐帧绘制、旁白朗读、按词对齐字幕、为每条短片作曲,支持竖屏、方形、横屏,40 秒短片一分钟内渲染完成。Pro 档一天可做 50 条以上,5X 档 250 条。作者称整套工作流与技能免费放出,评论「animator」即可获取。
从一句诗到 40 秒动画短片,画面、配音、字幕、配乐全由 Claude 串起来跑,作者说 Pro 档一天能出 50 条以上。做批量短视频和短剧预演的可以要一份来试跑。
点击打开原平台查看,能否访问取决于网络环境
03
@slashui
作者 @slashui 分享用 GitHub 上的 ffmpeg-skill 配合 Claude 剪片:只给 Claude 一个 YouTube 链接,Claude 自己「看」视频、判断剪辑点、自动选最高画质并完成剪辑,作者称速度也快,目前表现近乎完美,但功能还没完全玩透。对后期和做批量二创的团队来说,这是一条把「找素材—看片—粗剪」串起来的自动化做法,可以照仓库跑一遍验证剪辑点准不准。
把链接丢给 Claude,它自己看片、找剪辑点、挑最高画质再切——后期和做批量二创的可以拿这个 GitHub 仓库跑一遍,看它剪出来的节奏能不能直接用。
04
@aicreataro
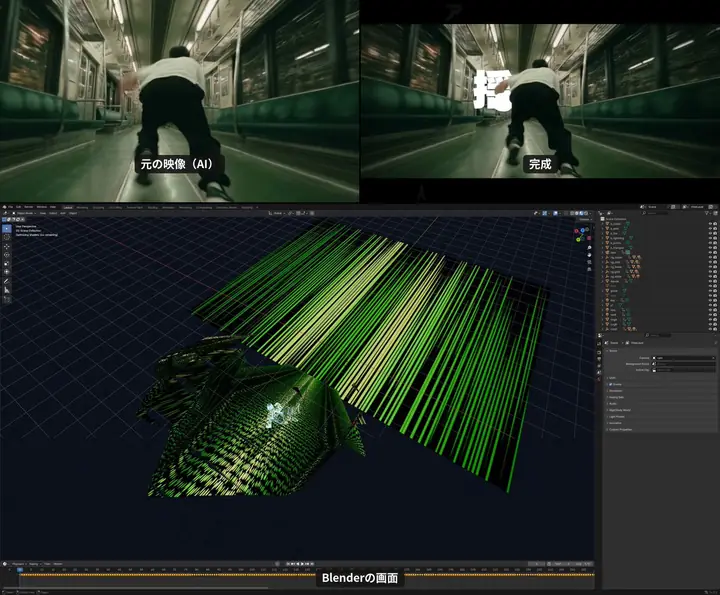
作者以一段 20 秒「电车内跳舞」的 AI 视频为素材,在 Blender 里从人物动作生成 3D 身体,再转成粒子、闪电、火焰、方块;背景把单张画面按深度切成多层板,镜头在其中穿行,落地瞬间身体炸开、世界切换。字幕先在 Blender 里定位,再用 Python 逐帧导出镜头运动,按同一透视贴到地板和墙上,人物抠像后文字可绕到身后;实拍部分靠跟踪求出地板与墙面朝向。作者称完成度到七成左右顺利,再往上提质量最难,必要时推翻已有方向重来。
把一张 AI 视频拆成多层板子、让镜头在中间穿行,字幕按透视贴到地板和墙上跟着一起动——做后期和视觉的可以照着这套思路试一遍。
点击打开原平台查看,能否访问取决于网络环境
05
@leaf_sanren
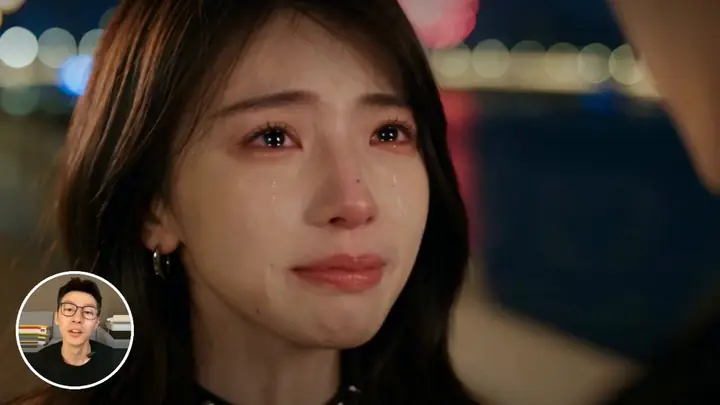
作者给出用 HeyGen AV4 模型做数字人视频的低成本做法:数字人脸只出现在开头和结尾,中间段落用画外音;觉得不够生动的片段把数字人缩到角落小窗而非铺满全屏。按此方式一条 1 分 30 秒的视频成本不到 2 美元,且已把生成后未被剪进成片的废片计入成本。
把数字人只放在开头结尾、其余走画外音、不够生动的段落缩成角落小窗,1 分半成片成本压到 2 美元以内。做口播号和短剧的可以照这套省预算。
点击打开原平台查看,能否访问取决于网络环境
06
@magnific
Magnific 官方介绍《当下的力量》的制作说明(该产品 8 月 1 日已发布):全片每个场景均由文本直接生成,未使用任何图像参考,人物表情(从尖叫到分娩中的母亲)也靠提示词完成;配乐使用 ElevenLabs Music v2 制作。这条讲的是纯文生视频路线下如何维持镜头与表情的可控性,工具组合为 Seedance 2.5 + ElevenLabs Music v2。
全片每个镜头都是纯文本生成、不用任何图像参考,连尖叫和分娩的表情都靠提示词顶住,配乐走 ElevenLabs Music v2。做 AI 短片想摆脱参考图的可以看它怎么控表情。
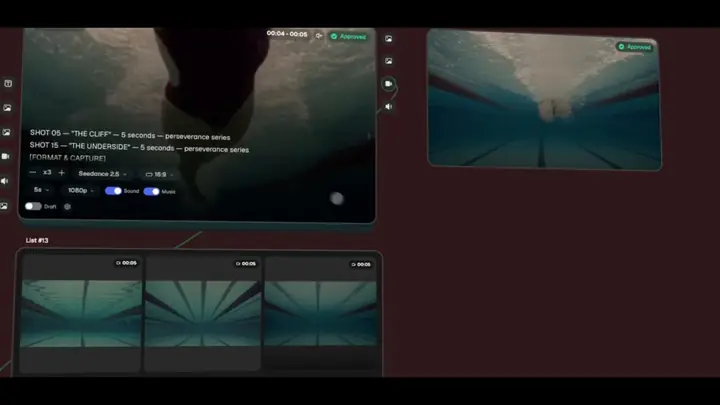
点击打开原平台查看,能否访问取决于网络环境
07
@Khazix0918
作者花 5 天把分散在桌面定时、Webhook+后台 CLI、Dots 里的 Agent 自动化任务整合成一个微缩景观风格的可视化管理界面:预设自动化以包裹形式路由到两个 Agent 执行,并与现实时间、天气打通,现实下雪小镇也下雪。分工上 Claude Opus 5.5 搭整体视觉与框架并指挥 GPT-6 Astra 建模渲染,Codex 在自有 CI 机上做全流程测试,共消耗约 30% Claude 周额度与两管 Codex 额度。
把散在桌面定时、Webhook、Dots 里的自动化任务收进一个微缩景观界面,包裹路由到两个 Agent 执行,还跟现实天气打通。自己搭自动化流程的可以看看这套调度怎么串。
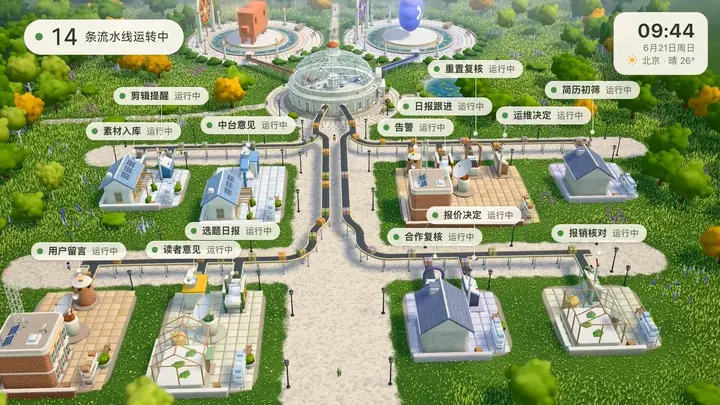
点击打开原平台查看,能否访问取决于网络环境
08
@threeaus
陆三金(@threeaus)重度使用 Kimi K3.1 的 3D 能力后给出几条实测:three.js 做小场景时各模型差异已不明显,只剩审美和细节;K3.1 操控 Blender 做建筑类场景顺手,但装饰偏素,测试古建、卡通、废土三类后认为废土风格建筑效果最好;LLM 操控 Blender 做简单线条尚可,做人物动画仍不行。他同时反驳「K3.1 路由了 Tripo」的说法,认为 LLM 画的 3D 很容易辨认,并提出「LLM 操控 Blender 生成场景 + 3D 生成模型做人物/拆分资产」的组合思路。
做 3D 场景和美术资产的可看:K3.1 操控 Blender 搓建筑类场景顺手,废土风格出得最好,人物动画还停在「牛来」水平。
点击打开原平台查看,能否访问取决于网络环境
09
@TanLuAI
探路AI 发布一条 AI 短片,画面走真实 MiniDV 纪实质感,角色设定为小镇里的「师妹」,配广东口音老板娘,正文附提示词供参考。属于个人创作者的生活流短片分享,工具与参数未在正文展开。
主打真实 MiniDV 纪实画面加广东口音老板娘,走的是生活流短剧那一路,提示词直接放出来了,做方言短剧和纪实感的可以拿去改。
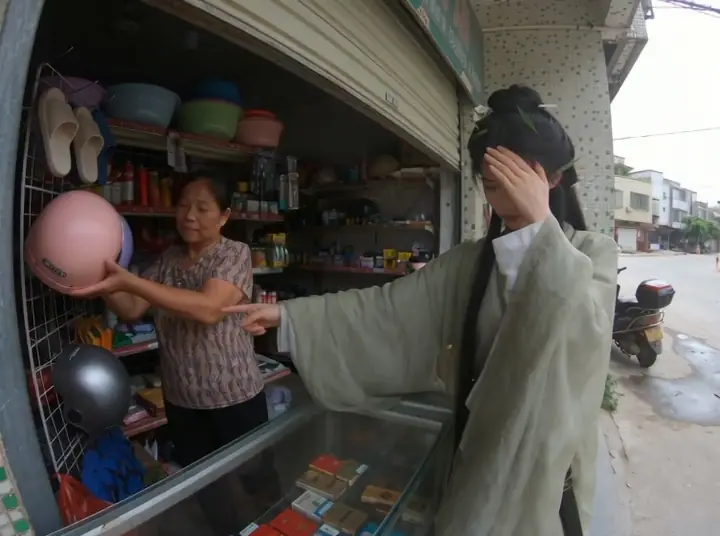
点击打开原平台查看,能否访问取决于网络环境
10
@CuiMao
B 站 UP 主 CuiMao 复盘自己恶搞 Anthropic 达里奥的长篇 AI 视频爆火后为何停更:当时因 Claude 封号生气,花大量时间研究 Seedance 让镜头更像电影、人物动作和包袱节奏,视频全网几百万流量。他认为自己没发明技术,只是恰好撞上热点、有情绪、手里有工具;真正被验证的是编剧直觉——笑点放哪、人物怎么反应、镜头何时切、伏笔何时翻。他提醒:模型能出画面,但决定不了什么值得拍;工具越强,越容易把结果带来的成就感误认成自身能力增长,未来竞争从「人无我有」转向「人有我优」。
靠恶搞 Anthropic 爆了几百万流量后主动停更,作者复盘了「网感能带来流量,但决定不了你真正想拍什么」。做 AI 内容做久了有点迷茫的编导,可以看看这段自我拷问。