
腾讯混元开源 Hy-Nomas 交互式视频世界模型
腾讯混元开源交互式视频世界模型 Hy-Nomas,支持用文本提示词和相机轨迹自由交互,具备带世界记忆的长时程生成能力,提供轻量 LoRA 适配机器人等专用领域,并针对消费级 GPU 推理做了优化,GitHub、Hugging Face 和在线 Demo 均已开放。
文本加相机轨迹就能自由操控画面走向,还带世界记忆做长时程生成,做分镜预演和虚拟场景的可以下下来跑一遍,看镜头调度能不能真按轨迹走。
点击打开原平台查看,能否访问取决于网络环境
腾讯混元开源交互式视频世界模型 Hy-Nomas,支持用文本提示词和相机轨迹自由交互,具备带世界记忆的长时程生成能力,提供轻量 LoRA 适配机器人等专用领域,并针对消费级 GPU 推理做了优化,GitHub、Hugging Face 和在线 Demo 均已开放。
文本加相机轨迹就能自由操控画面走向,还带世界记忆做长时程生成,做分镜预演和虚拟场景的可以下下来跑一遍,看镜头调度能不能真按轨迹走。
点击打开原平台查看,能否访问取决于网络环境
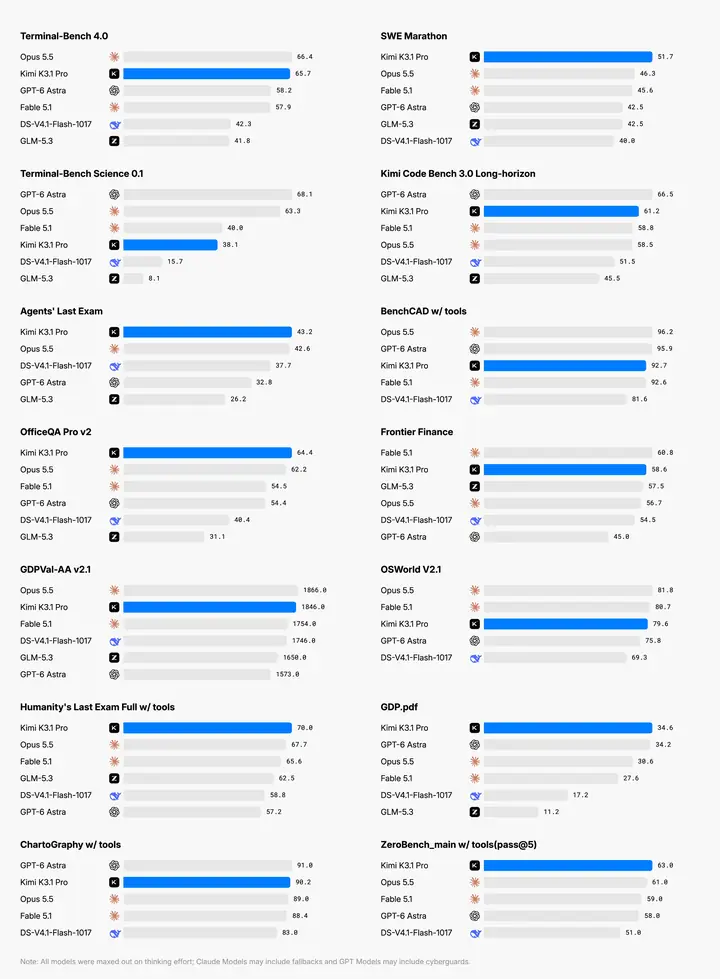
Kimi K3.1 同日在 11 个第三方平台上线可用:权重模型 / Moonshot AI / Kimi / Oran / Rohanpaul / Testingcatalog / API / MarkTechPost / The Decoder / 百万上下文 / Pro 网页端与移动端陆续。
Kimi K3.1 当天在这 11 个平台都能用上,按手上已开通的账号挑一个直接测,不用等单一渠道。
点击打开原文,能否访问取决于网络环境
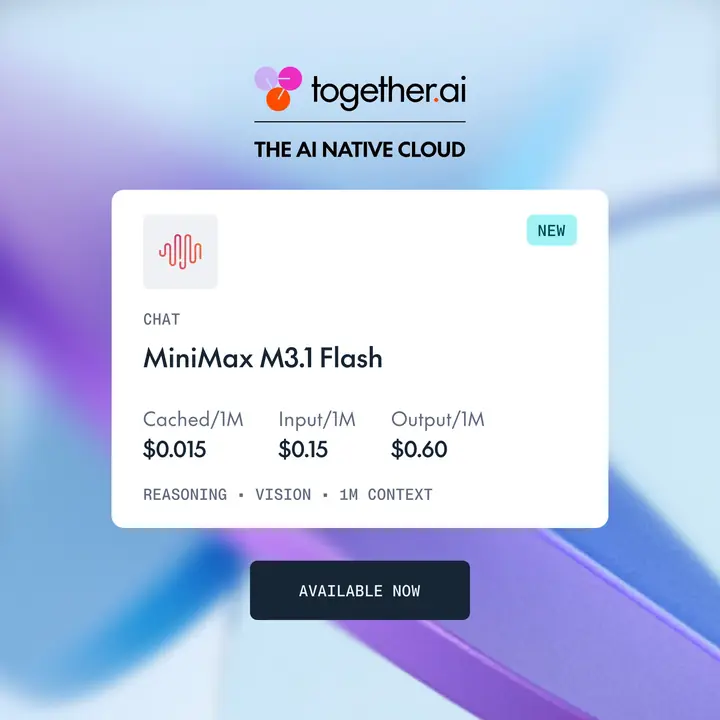
MiniMax 官方宣布 M3.1 Flash 开放权重,Together AI 作为首日合作伙伴提供全托管服务。据 Together AI 介绍,该模型代号 space bunny,面向智能体任务、编码、计算机使用和网络安全,支持 1M 上下文窗口与视觉能力,定价为缓存输入 $0.15/1M、输入 $0.15/1M、输出 $0.60/1M。
面向智能体、编码和计算机操作的语言模型,1M 上下文加视觉,输出 $0.60/1M。做创作自动化流程、要自己部署模型的技术整合者可以看,纯拍片的编导这条用不上。
点击打开原文,能否访问取决于网络环境
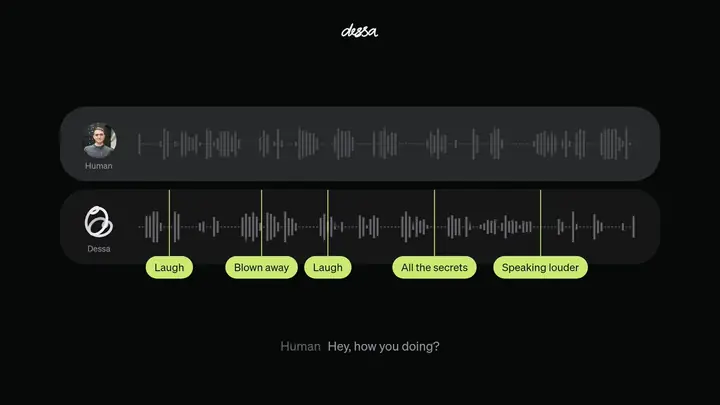
Jack Dorsey 宣布全双工语音模型 Dessa,仅用语音对话数据训练,未使用文本数据或任何预训练模型。目前只放出演示样本,据称在情感表达和自然感上明显强于其他模型。全双工意味着可边听边说、支持打断式对话,适合实时配音、虚拟角色对谈、短剧同期声等场景。
纯语音数据训练、不碰文本和预训练模型,全双工对话,目前只有演示样本。做 AI 配音、虚拟角色对话、短剧对白的可以蹲一波听感。
点击打开原平台查看,能否访问取决于网络环境
Suno 官方发布虚拟说唱歌手 DEATHPIXIE,人物设定来自一座名为 New Tokyo 的黑暗、犯罪猖獗的城市,官方同时介绍了将她「带入现实」的团队。这是 Suno 在音乐生成之外做虚拟艺人角色包装的一次尝试,把人物世界观和音乐人设绑在一起。做虚拟偶像、AI 音乐和角色 IP 的可以关注其设定与呈现方式。
Suno 官方造了个虚拟说唱歌手 DEATHPIXIE,设定在犯罪横行的 New Tokyo,还带团队出镜。做虚拟艺人、AI 音乐和角色 IP 的可以看看它怎么把人物设定和音乐绑在一起。
点击打开原平台查看,能否访问取决于网络环境
Krea AI 官方宣布推出 Krea for Grok bot,用户可直接在 Grok 内生成图像和视频,官方称调用的是「全球最好的模型」。官方未说明具体接入哪些模型、额度与付费方式,也未给出分辨率、时长等参数。对常用 Grok 做前期构思的创作者,等于多了一个不切站就能出图出片的入口。
Krea 把出图和出视频的能力塞进 Grok 对话框,不用切站就能生成。习惯在 Grok 里聊创意的视觉师可以先试一轮,看它调的是哪家模型、出片稳不稳。
点击打开原平台查看,能否访问取决于网络环境
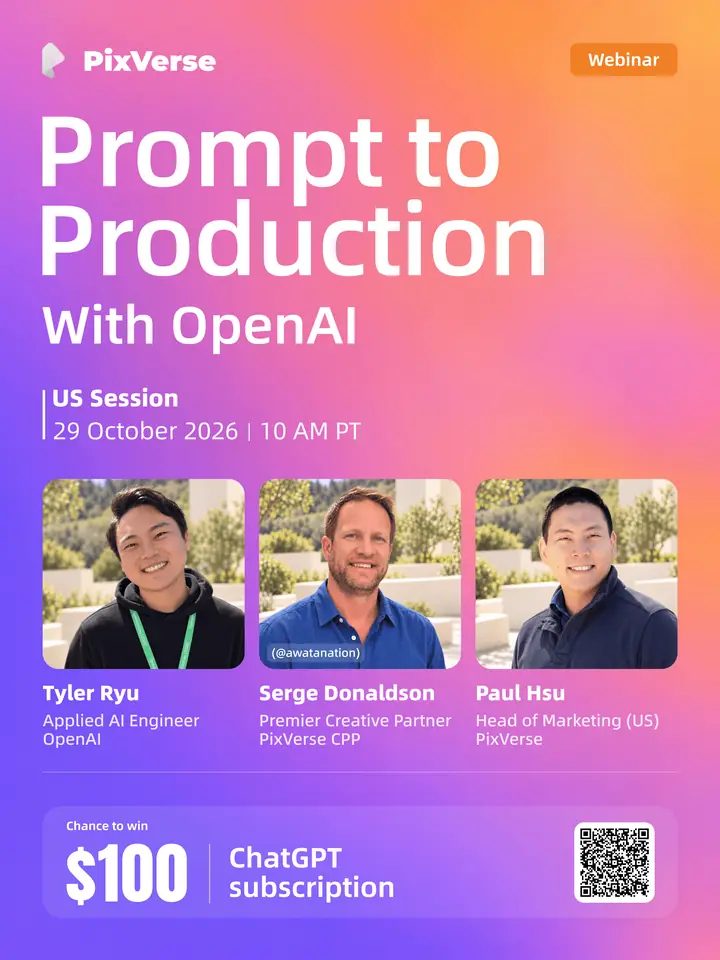
PixVerse 官方宣布与 OpenAI 联合直播,主题是从提示词到成片:演示一份创意简报如何通过 ChatGPT + PixVerse 插件生成一支完整视频。亚太场 10 月 28 日中午 12 点 GMT+8,美国场 10 月 29 日上午 10 点 PT,参会者可得免费 PixVerse 积分,并有机会抽 1 个月 ChatGPT Pro。
PixVerse 和 OpenAI 一起开直播,演示一份创意简报经 ChatGPT + PixVerse 插件直接出成片,做短剧和广告的可以蹲一下这套流程能不能省掉中间环节。
点击打开原文,能否访问取决于网络环境
MiniMax Design(Hailuo_AI)宣布 Design MCP 上线,可在 Codex 及其他智能体中直接调用 Design 进行创作,产出会自动同步到 Design Canvas,省去工具间来回切换。官方表示附有上手步骤,但正文未展开具体接入方式与支持范围。
设计能力接进 Codex 等智能体,做出来的东西自动同步回 Design Canvas,不用在工具间来回倒。自己搭流程的可以接上试,看能不能把出图环节塞进现有自动化里。
点击打开原文,能否访问取决于网络环境
Grok Bots 推出 Team Bots 版本,面向整个团队共享使用,目前仅对 Teams 与 Enterprise 客户开放。官方发布 8 分钟讲解视频,分 8 个章节:简单示例、能力说明、连接你的工具、如何创建、复杂示例、适用场景判断、底层原理、总结。
Grok Bots 加了团队共享版,官方配了 8 分钟分段讲解(怎么建、怎么接工具、什么时候该建)。做团队协作自动化的可以看下接工具的段落,纯拍片的用不上。
点击打开原平台查看,能否访问取决于网络环境
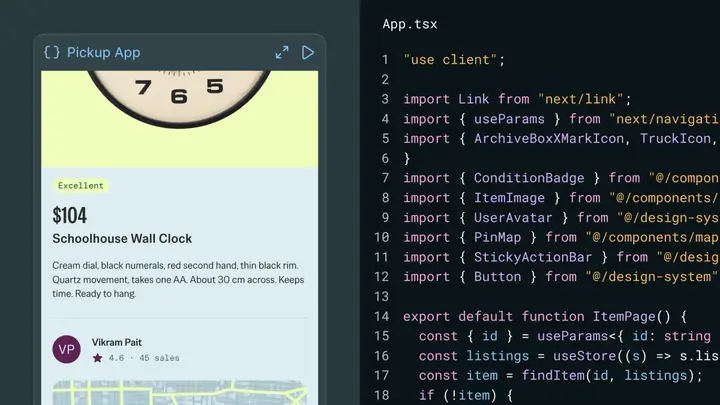
Figma 宣布 code layers 进入开放 beta,并公开 Superside、Dell、Cox Automotive、Rocket Money、Merkle、Checkout.com 六家团队的实验用法,包括用提示词给静态设计加交互动效、用开发者同款 React 组件搭可输入对话的原型。
Figma 把设计稿直接变成可交互原型,六家团队在试。做 AI 产品界面和交互 demo 的可以看看,纯拍片的用不上。
点击打开原文
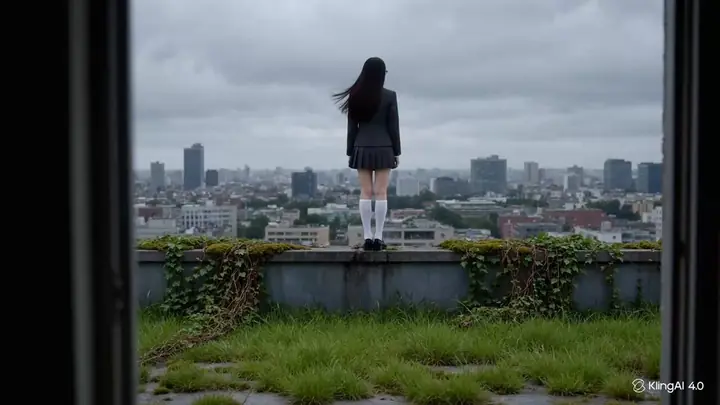
可灵AI公众号汇总各领域专业团队对 10 月 15 日全量上线的 Kling 4.0 的实战反馈:韩国导演金性洙用它重启停摆半年的 AI 短片《Worm Train》;Fountain 0 联合创始人 Ash Koosha 称制作流程中废弃素材量至少减少 50%;柳翠虎、陆川肯定其在表演、长文本指令遵循和多关键帧控制上的升级;耀客传媒 AI 导演佟光宇测试中生成的素材绝大多数可直接剪辑。
韩国导演金性洙拿它重启停摆半年的短片,Fountain 0 联合创始人称废片量至少减半,陆川、佟光宇点名表演和长文本指令。做 AI 短剧和长片的可以按这几条去实测。
点击打开原平台查看,能否访问取决于网络环境
作者 @AIWarper 给 OPUS 开放了 Seedance 2.5、Kling 4.0、GPT Sunburst、DaVinci Resolve 和 Suno(浏览器控制)的访问权限,让它为一个虚构的搞笑产品独立完成一支创始人发布视频,作者称整支视频由模型自己做完。这是一次把生成、剪辑、配乐交给同一个 Agent 调度的实测。
作者把 Seedance 2.5、Kling 4.0、GPT Sunburst、达芬奇、Suno 全交给 OPUS,让它自己串起一条从生成到剪辑配乐的流程。想搞自动化出片的团队可以看它怎么分工。
点击打开原平台查看,能否访问取决于网络环境
可灵官方发布 Kling 4.0 制作解析,拆解短片 KING CARD 的动态运镜与环境变换方法,该片在各社交平台累计 500 万次观看。解析以官方文章形式发布,聚焦镜头运动与场景转换的处理思路。
官方亲自拆 KING CARD 的动态运镜和环境变换,做分镜和视觉的可以照着研究镜头怎么走、场景怎么换。
点击打开原文,能否访问取决于网络环境
OpenAI 开发者体验团队的 Dominik Kundel 分享个人体验:拍完素材把 SD 卡插进笔记本后离开工位,由 dot 和 Codex 调用 DaVinci Resolve 自动完成剪辑,并通过 Slack 定期推送进度供审阅。这条内容属于个人使用体验分享,没有给出具体配置、脚本或参数。对后期和剪辑团队来说,它提供了一个可参考的方向:把粗剪交给 Agent 跑,人只负责审片。
OpenAI 开发者体验团队的 Dominik Kundel 演示了一条流程:插上 SD 卡走人,Codex 调 DaVinci Resolve 自动剪,进度通过 Slack 定期推给你审。做后期的可以顺着这个思路搭自己的自动粗剪。
Audible 技术团队公布可控 TTS 方案:用「whispering nervously」「shouting in anger」这类自然语言描述控制对白表达,并在整本书层面固定每个角色的声音档案,保证从头到尾音色一致。BookLLM 组件自动识别书中角色并标注对白,25 本英西语书籍上角色识别准确率分别为 97% 和 94%;MUSHRA 听感测试中对白区分度提升 3.7 分,十种声音里八种获得统计显著改善。
做有声书、广播剧和 AI 配音的可以看这套做法:用自然语言描述控制语气,角色声音在整本书里保持一致,角色识别准确率 97%。
点击打开原文
Bin Liu 转述:HyperFrames 团队的研究工程师 @WaterrrMiao 用 HyperFrames Studio 与 Opus 5.5 做了一支 10 分钟以上的视频,被形容为完整学会了 Kurzgesagt 的剪辑风格、看起来像原作者出品,这也是它走红的原因。这条本身是解释走红原因的转述,不是作品发布。
有人用 HyperFrames Studio 加 Opus 5.5 做出 10 分钟以上、被评价为「像 Kurzgesagt 原班出品」的视频,做科普动画和长片后期的可以顺着作者 @WaterrrMiao 蹲后续。
点击打开原平台查看,能否访问取决于网络环境
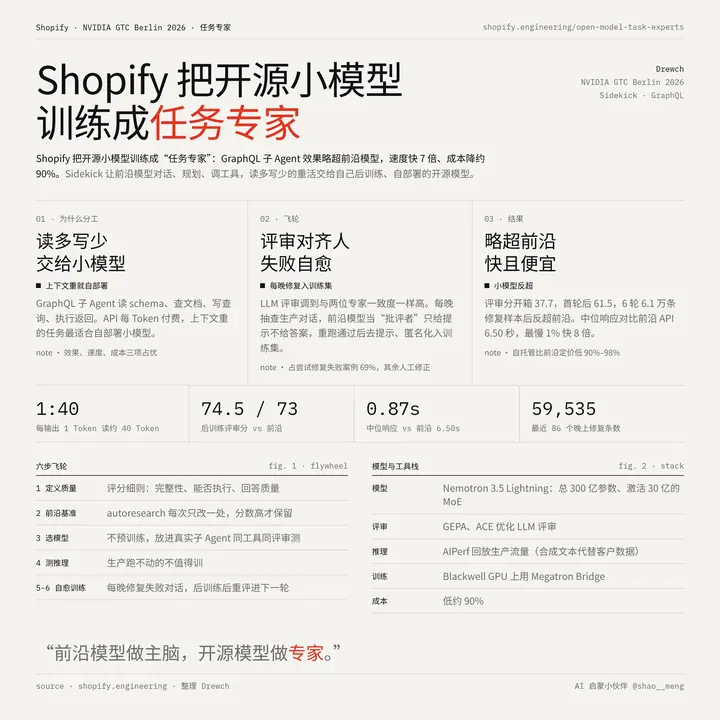
Shopify 工程团队在 NVIDIA GTC Berlin 2026 介绍电商助手 Sidekick 的分工:前沿模型负责对话、规划和调工具,读多写少的 GraphQL 子 Agent 交给自己后训练自托管的开源模型。选型为 Nemotron 3.5 Lightning(总参数 300 亿、每 Token 激活 30 亿的 MoE),不做预训练。每晚由 LLM 评审抽查生产对话,失败案例交前沿模型给提示、模拟商家重跑,通过后匿名化入训练集,86 晚修复 59535 条对话。6 轮训练后评审分从 37.7 升到 74.5,超过前沿模型的 73;中位响应 0.87 秒对 6.50 秒,成本低 90% 到 98%。
Shopify 把 300 亿参数 MoE 小模型后训练成 GraphQL 专家,评审分 74.5 反超前沿模型 73,中位响应 0.87 秒对 6.5 秒。自建推理流程的团队可以看它那套「失败案例自动变训练数据」的循环怎么跑。
点击打开原文,能否访问取决于网络环境
卡兹克(@Khazix0918)整理了 8 个基于 Claude Opus 5.5 的创意案例:120 页手写笔记转个人字体、16 岁高中生 2 天构建古希腊世界、16 天做出的小王子 3D 剧情游戏、成都城市讲解视频《一座城的年轮》、一句话生成火烧前的圆明园视频、指环王故事视频、逆向自家电视,以及 Nenly 用 Claude 和 Codex 等工具花 298 天做出 Steam 好评率 98% 的游戏《群侠传:幸存者》。
8 个案例里,一句话生成圆明园火烧前影像、成都城市讲解片、指环王故事视频这几条跟影像创作直接相关,编导和视觉可以挑着看别人怎么把一句话变成片子。
点击打开原文,能否访问取决于网络环境
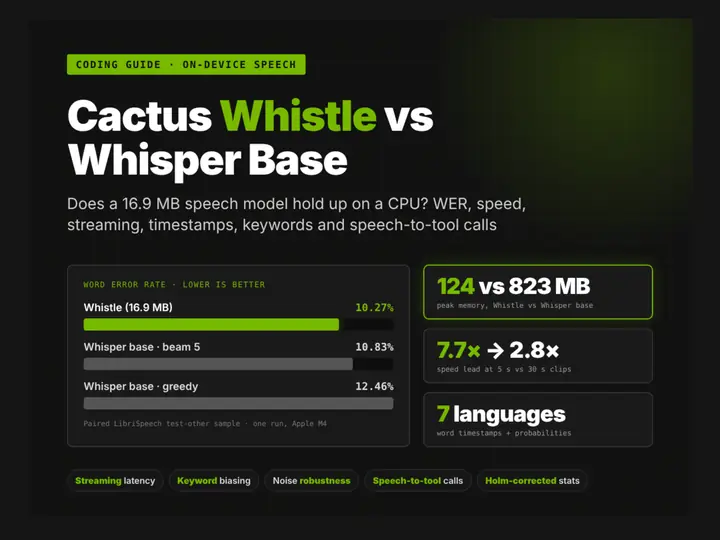
MarkTechPost 的实测教程:在 Apple M4 的 CPU 上跑 Cactus Compute 的 16.9 MB 语音转写模型 Whistle,与 Whisper tiny、base 对比 WER 和速度,用配对说话人聚类 bootstrap 加 Holm 校正做统计,并测试流式转写与工具调用。做字幕、配音对轴、批量转写的后期可以关注小模型在本地 CPU 上的实际表现。
16.9 MB 的模型在 M4 CPU 上跑转写,还带流式和工具调用,做字幕和配音对轴的可以看看它跟 Whisper base 的差距到底在哪。
点击打开原文
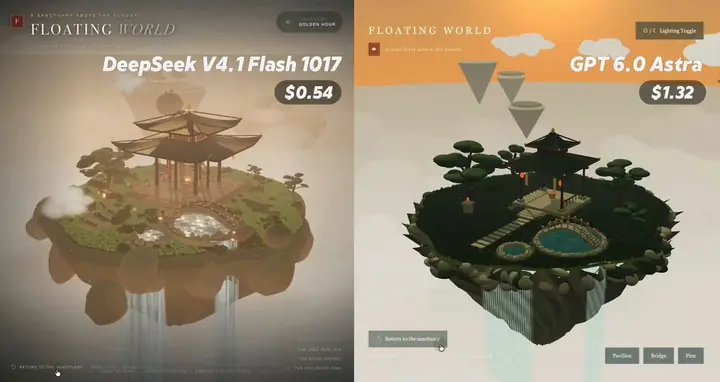
硅基流动(@SiliconFlowAI)官方发布并排对比:同一提示词分别交给 DeepSeek V4.1 Flash 1017 和 GPT-6 Astra,两者都用 Three.js 构建同一个交互式 3D 世界(DeepSeek V4.1 Flash 1017 该产品 10 月 18 日已发布)。作者称两者质量几乎相同甚至更好,成本比 Astra 低 50% 以上,提示词放在评论区。产出是网页 3D 场景代码,不是影像素材。
同一提示词让两个模型用 Three.js 搭交互式 3D 世界,作者称质量接近、成本低一半以上。做网页 3D 或互动装置的可以看并排效果,拍片流程用不上。
点击打开原平台查看,能否访问取决于网络环境
B站UP主「沙雕Sanscul」自编自导自剪的AI短片《后室里的乌鲁鲁3》,导演、编剧、剪辑、AI素材、美术设计、执行制作全部由一人完成。作者在简介中说明本期花费2.7万元,其中2.5万为AI积分、2000为人力成本,并提到这个制作质量与成本继续做下去可能要贷款。
一人包办导演编剧剪辑美术的AI短片续作,作者自曝花了2.7万(2.5万AI积分+2000人力),做AI短片想算成本的可以拉片看这钱花在哪。
点击打开原平台查看
B站UP主「造梦师希希」发布的AI短片,标题围绕「喝醉后把陌生人配对、星座决定配对对象」的轻喜剧设定,属于个人创作者的AI短片作品。
星座配对题材的AI短片,做轻喜剧向短内容的可以看看它怎么把互动梗拍成片子。
点击打开原平台查看
B站UP主「花火之原」发布的AI古装题材剧情视频,标题指向县长与街头女性角色的情节设定,成片,属个人创作者的长篇AI叙事作品。
B站UP主「花火之原」的AI古装剧情长片体量在个人AI作品里算长的,做AI短剧的可以拉片看长叙事怎么撑住。
点击打开原平台查看
