01
@hectorVFX
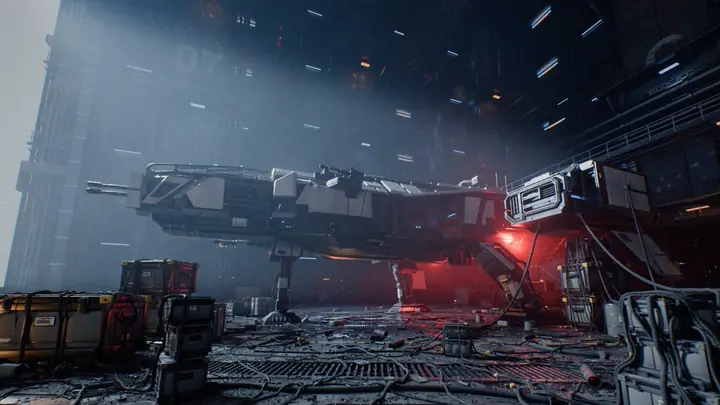
Hector VFX 用 Claude Opus 5.5 在 Houdini 里搭建整个场景,全程通过对着 iPhone 说话下指令完成,作者称没摸到能力上限。渲染在 5090 上耗时 50 小时,场景含体积雾等复杂元素;调色在 DaVinci 中完成,走 ACES 流程,同样通过 DaVinci 的 MCP 语音操作。作者认为这类工作方式会被大规模采用。
对着 iPhone 说话就把 Houdini 场景搭完,调色也靠 DaVinci 的 MCP 语音完成,做三维和视效的可以看看这条流程能省多少手动活。
点击打开原平台查看,能否访问取决于网络环境
02
@shao__meng
邵猛分析女装电商营销物料「SKU 多、相似性高、数量大、更换频率高」的特点,指出同款换色、同色换款这类需求不能靠每张重新生成解决,抽卡和幻觉无法 100% 避免。他主张把素材分层,分出变量与不变量,让服装、促销信息等图层尽量原子化、可复用,再做不同组合,既保一致性也压生成成本。他认为近期几个生图模型都在往高度可控走,可控性和可复用性才是生图应用赚钱的方向。
做电商视觉和商单的可以看这套思路:把服装、促销信息拆成可复用图层再组合,同款换色不用每次重抽。
点击打开原平台查看,能否访问取决于网络环境
03
@MaxForAI
博主 @MaxForAI 称深度测试了 DeepSeek V4.1-Flash-1017(该产品 9 月 11 日已发布),给出四点感受:怀疑模型蒸馏了大量 GPT 数据;写作文风和表达能力较 V4.1-Flash、V4-Flash 有提升,接近 DeepSeek-V3.1-Terminus;游戏构建、3D 建模方面较上一版提升明显;并称该模型掺进 GPT 里很难测出来。附一段朋友用该模型单次生成的视频,称仅花费 3 元 token。
第三方实测感受:写作文风比 V4.1-Flash 和 V4-Flash 有提升,游戏构建和 3D 建模进步明显,附一段 3 元 token 单次生成的视频。做文本和 3D 素材的可以自己跑一遍验证。
点击打开原平台查看,能否访问取决于网络环境
04
@OpenAIDevs
OpenAI Developers 官方介绍 GPT-Live-1 应用语音定制指南(该产品 9 月 13 日已发布),说明两种给应用配嗓音的方式:用提示词塑造音色,或从新增的国际预设嗓音中直接挑选。面向用 GPT-Live-1 搭建应用的开发者,属于官方使用说明文档。做 AI 配音、虚拟角色对白和实时语音交互的团队可据此调整音色方案。
OpenAI 官方给出 GPT-Live-1 的嗓音调法:提示词塑形 + 新增国际预设音色。做 AI 配音、虚拟角色对白的后期可以照着试,看能不能省掉一轮真人补录。
点击打开原平台查看,能否访问取决于网络环境
05
@ring_hyacinth
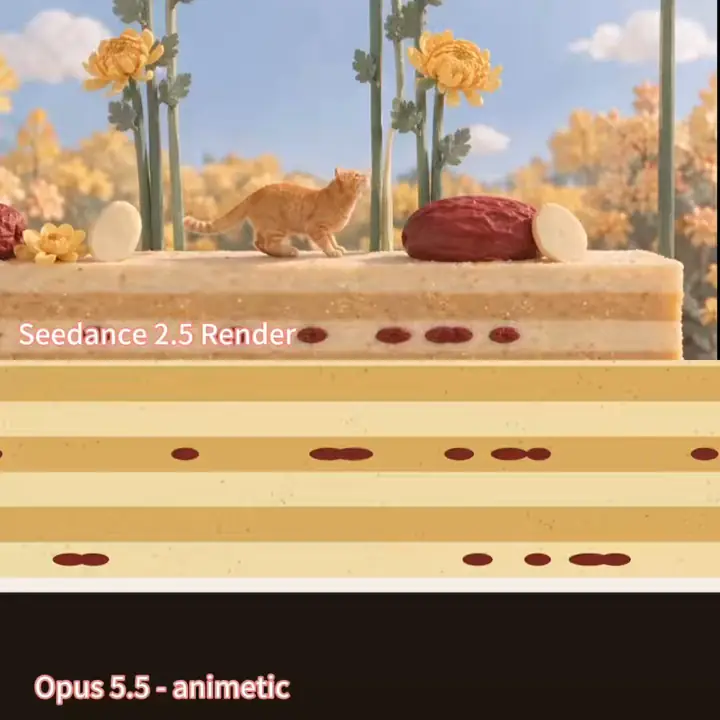
X 用户 @ring_hyacinth 分享自己的制作流程:先用 Opus 5.5 制作动态分镜,再交给 Seedance 2.5 生成成片动画,配文为重阳节应景内容。帖子只交代了这两步的工具顺序,没有给出提示词、参数或成片时长等信息。
一条「先分镜再出片」的两段式流程分享:Opus 5.5 出动态分镜、Seedance 2.5 转成片动画。做短片和短剧的可以顺着这个顺序试一遍,看分镜阶段能不能把镜头节奏先定死。
点击打开原平台查看,能否访问取决于网络环境
06
@chrisdadiva
作者 @chrisdadiva 发布教程视频,讲如何用 Google Flow 免费制作纪录片风格的 AI 视频,面向 YouTube 自动化场景,并附上一份 Google Docs 提示词文档供直接取用。教程的具体步骤、参数和成片效果需点开视频与文档查看。
用 Google Flow 免费做纪录片式 AI 视频的教程,作者把提示词整理成公开文档,做 YouTube 自动化或纪录片向内容的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
07
@shao__meng
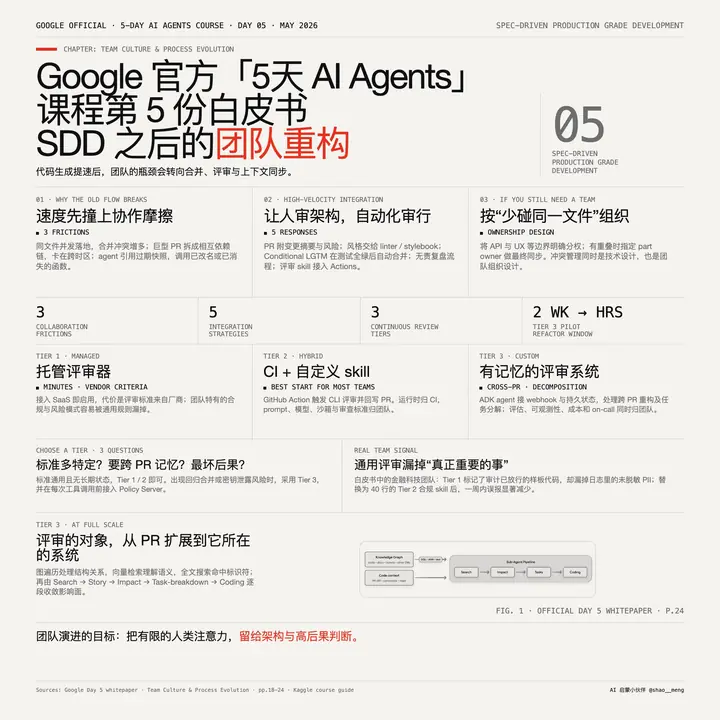
作者邵猛解读 Google「5天 AI Agents 课程」第 5 份白皮书《Spec-Driven Production Grade Development in the Age of Vibe Coding》中「Team Culture & Process Evolution」一章,附白皮书 Google Drive 链接。白皮书提出把 Agent 塞进旧研发流程会放大协作摩擦,列出三类新问题(合并冲突倍增、评审死锁、上下文碎片化)和五项应对策略(PR 附 AI 变更摘要、重构评审所有权、Conditional LGTM、无责文化、Agent 评审 Agent),并给出评审 Agent 三档选型(托管型/混合型/定制型)及金融科技团队从 Tier 1 换到 40 行 Tier 2 skill 的案例。
Google 官方白皮书里讲 Agent 塞进旧研发流程会撞上什么墙——合并冲突倍增、评审死锁、Agent 拿过期快照写废代码,还给了三档评审 Agent 选型。带团队做 AI 工作流的人可以看看这套组织设计思路。
点击打开原文,能否访问取决于网络环境
08
@Foyege24
AI 视频创作者 @Foyege24 分享自己做表情和情感的方法:先设身处地代入角色,想清楚听到这句话会有什么感受、会不会直视对方、会不会装作没事,让情绪先在自己身上过一遍,再转化成屏幕上的表情和动作。他认为技巧重要,但前提是理解并关心角色在经历什么,之后才能把想要的表演传达给 AI。
没有工具和参数,讲的是表演方法:先想清楚角色此刻会怎么反应,再把这个感受传达给 AI。做 AI 剧情片的编导可以看看这套思路。
09
@xiaoxiaodong
用户 @xiaoxiaodong 分享用 Opus 5.5 调用 Unsplash 开源图片做样张的体验:认为它理解任务后直接执行、不拖时间,还会主动指出问题并给方案,并提到用 /compact 压缩上下文、长对话保留记忆。属个人使用感受。
个人使用体验分享:让 Opus 5.5 调 Unsplash 开源图做样张,反馈是理解任务快、会顺手指出问题。做视觉提案的可以留意这个用法,但只是单人感受。
点击打开原文,能否访问取决于网络环境
10
@mad_dogdebt
韩国用户转述妻子及其同事的处境:设计行业从业者正认真考虑转行,公司内部形成「用 AI 很快就能搞定」的认知,谈价时频繁被要求「用 AI 做便宜点」;同时不再招新人,在职者从亲手制作转为审阅、修整 AI 产出,并判断五年内站不稳位置就会被淘汰。属个人见闻转述,无具体公司、数据或案例。
一条从业者饭桌闲谈:甲方拿「AI 做能便宜点」压价、公司停招新人、设计师从自己做变成审 AI 的活。做视觉外包和报价的可以看看同行在经历什么。
01
B站热门·AI 影视
B 站 UP 主发布的 AI 短片《杀死伪人》,以灰鼠、白鼠、小鼠、硕鼠与圣诞怪物为主角。角色立绘为 AI 生成后人工修改,部分动画由 Seedance 完成,部分 3D 建模远景由 GPT-6 Astra 完成,角色画风模型来自「再见可可亚」,声音合成由「花儿不哭」负责。
角色立绘 AI 生成后人工精修、动画交给 Seedance、远景 3D 用 GPT-6 Astra,三段工具分工写得明白。做角色向短片的美术和编导可以拉片看画风统一度。
点击打开原平台查看
02
@jurlycat
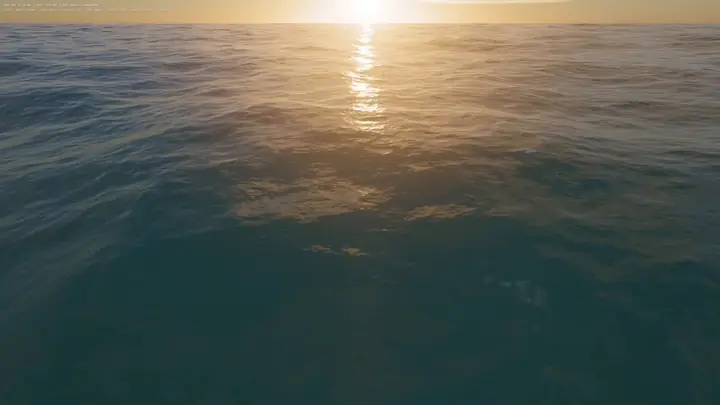
创作者 Jurly 分享一个 61 KB 的自包含 HTML 文件,在浏览器里用 WebGPU 实时渲染整片海洋:FFT 波浪、白浪、阳光闪烁、带云的物理日落天空和自由飞行镜头,不使用游戏引擎或渲染库。据其说法,该文件由 Claude Code + Opus 5.5 在约内构建,过程中 Claude 用无头 Chrome 渲染截图、再由独立子 agent 对截图做点评,创作者主要在云层效果上给反馈。文件已压缩、可直接下载,在支持 WebGPU 的 Chrome 里用 WASD 浏览。
61KB 单文件跑出 FFT 波浪、白浪、日落天空和自由飞行镜头,没引擎没渲染库。技术整合者可以下载拆一遍,看 Claude Code 加子 agent 自评截图这套做法能不能挪到自己的流程里。
点击打开原平台查看,能否访问取决于网络环境
03
B站「AI 短片/短剧/视频」搜索
B 站「AI 全民制作人」标签下的 AI 短片,主题是沉浸式体验古代底层吃食小贩的一日三餐,走市井生活题材路线。
古代市井题材的沉浸式 AI 短片,做历史向内容和美食叙事的编导可以拉片看场景还原与生活细节的处理。
点击打开原平台查看
04
B站「AI 短片/短剧/视频」搜索
B站「校花宇宙」系列 AI 短剧的一集,剧情设定为高考结束后校花面对直播记者采访,台词围绕「全班都戴了 AI 智能隐形眼镜」展开,属于校园题材的轻喜剧向单集内容。
B站「校花宇宙」系列 AI 短剧的一集,题材是高考后校花受访的校园梗,做 AI 短剧的可以拉片看这类单集梗剧的节奏和人物一致性处理。
点击打开原平台查看