01
公众号
快手可灵 10 月 15 日宣布 Kling 4.0 正式全量上线 klingai.com,4K 与 1080p 10-bit HDR 格式输出即将上线,创作页面同步全面升级,Kling 4.0 能力已接入 MCP/CLI,面向企业客户与开发者的 API 服务将于近期开放。
可灵 4.0 已在官网全量开放,4K 和 1080p 10-bit HDR 输出在路上,创作页也重做了一遍。做短剧和广告的这周可以拿旧项目跑一遍对比画质。
点击打开原平台查看,能否访问取决于网络环境
02
@fal
fal 公布 FLUX 视频系列四项模型的试用入口,均指向 fal.ai 上的 blackforestlabs 模型页:Flux Video Upscale(视频超分)、Flux 3 的 Video Edit(视频编辑)、Text to Video(文生视频)、Image to Video(图生视频),读者可直接访问试用。对做 AI 短剧和后期修复的团队来说,视频编辑与超分两项可直接接进现有出片流程,文生/图生视频则补上了 FLUX 生态的视频生成环节。
Black Forest Labs 的 FLUX 视频能力在 fal 上开放试用,文生视频、图生视频、视频编辑、超分四项都有独立页面,做 AI 短剧和后期修复的可以挨个跑一遍看废片率。
点击打开原文
03
@OpenRouter
Meta 发布开放权重模型 Muse Spark Open,已在 OpenRouter 上线,定位面向编码与智能体工作的美国最强开放权重模型。总参数 816B、激活 42B,支持 1M token 上下文,原生多模态,正文提到可输入图像、视频、音频和 PDF。OpenRouter 定价输入 $1.25/M、输出 $4.25/M。
816B 总参、42B 激活、1M 上下文、原生多模态,输入 $1.25/M 输出 $4.25/M,做 Agent 和批量文本处理的可以接 API 跑一周看成本。
点击打开原文,能否访问取决于网络环境
04
@fal
fal 宣布 OmniHuman V2 正式上线,可从单张图片加一段音频生成说话视频,口型与表情随语音同步,并支持可选提示词引导表演。对做数字人、口播、短剧对白和配音口型对齐的创作者来说,这是把静态形象变成会说话角色的现成能力,可直接在 fal 上调用测试。
单张图配一段音频就能出口型同步的说话视频,还能用提示词引导表演,做数字人、口播和短剧对白的可以接 API 跑几条看口型和表情稳不稳。
点击打开原平台查看,能否访问取决于网络环境
05
多平台
fal 同日在 3 个第三方平台上线可用:Image Klein / OpenRouter / Higgsfield。
fal 当天在这 3 个平台都能用上,按手上已开通的账号挑一个直接测,不用等单一渠道。
点击打开原平台查看,能否访问取决于网络环境
06
公众号
昆仑万维于 2026 年 10 月 15 日发布 Matrix-Game 4.0,称其为第一款运行在单张消费级显卡上的视频大模型游戏,并同步开源。对做互动影像、实时生成和 AI 游戏化内容的团队来说,单卡消费级硬件实时运行意味着本地部署门槛大幅降低,可关注其开源代码和实际帧率表现。
单张 RTX 5090 就能实时跑的视频大模型游戏,还开源了,做互动影像和实时生成的技术整合者可以拉下来跑一遍看延迟和画质。
07
@OpenAI
OpenAI 发布 GPT-Rosalind,定位科研场景,帮助研究人员跨科学文献和生物数据进行推理,由科学家提供专业判断来评估证据。符合条件的实验室可获最长 12 个月 OpenAI 工具赞助访问,GPT-Rosalind 需通过可信访问审批;通过 Rosalind Academic Plan 共享的研究数据默认不用于训练模型。这是面向生物科研的垂直产品,与影像生成、剪辑、配音等创作环节无直接关联。
面向生物科研的垂直模型,跟影视创作没关系,编导和视觉师可以直接跳过。
08
公众号
阶跃星辰正式开放 Step 5 Preview 模型权重,提供 BF16 与 FP8 两个版本,已上线 Hugging Face 和 ModelScope,同步发布技术博客。原文正文抓取失败(页面提示环境异常需验证),除权重开放与托管平台外,模型参数规模、能力方向、许可协议等细节未在可见文本中给出。对做本地部署、私有化推理和自建生成流程的技术团队来说,这是一次可直接下载试跑的权重开放。
阶跃星辰把 Step 5 Preview 权重放上 Hugging Face 和 ModelScope,BF16 与 FP8 两个版本都能下。做本地部署和私有化推理的技术团队可以拉下来跑一遍,看能不能接进自己的生成流程。
09
NVIDIA
NVIDIA 官方消息,Adobe 与 NVIDIA 扩大合作,将 NVIDIA RTX Spark 超级芯片引入 Photoshop、Premiere、Substance 3D 等智能体创作应用,AI 处理、编辑、调色与特效速度最高提升 2 倍。对后期和视觉创作者来说,这是常用剪辑与修图工具的一次底层提速,具体落地机型与时间表原文未给出。
Adobe 把 NVIDIA RTX Spark 超级芯片塞进 Photoshop、Premiere 和 Substance 3D,AI 处理、调色、特效最高快 2 倍。后期和视觉师可以盯一下自己机器什么时候能吃到这波提速。
点击打开原文
10
@perplexity_ai
Perplexity 开源 SPACE,即运行 Perplexity Computer 中每项任务的沙盒平台。SPACE 为每个 Agent 任务提供独立的 Firecracker microVM,并从 VM 外部控制凭证和出站流量,现已在 GitHub 以 Apache 2.0 许可发布。对自建 Agent 工作流的团队来说,这是一套可直接复用的任务隔离与权限管控方案。
Perplexity 把跑 Agent 任务的沙盒 SPACE 开源了,每个任务一个独立 microVM、凭证和出网流量都在 VM 外管,Apache 2.0。自己搭 Agent 流程的可以拉下来看看隔离怎么做的。
11
@fal
fal 平台上线 NVIDIA Nemotron 3.5 Super VL 多模态模型,开源权重,总参数 120B、每 token 激活 12B,能力覆盖图像、文档和视频理解,以及视觉推理、工具调用、文档智能和 AI 智能体场景。对做智能体流程的团队来说,这是多一个可调用的视频/文档理解后端选项,但它本身不产出画面或声音,跟出片环节关系不大。
120B 总参、每 token 只激活 12B 的开源权重多模态模型,主打图像/文档/视频理解和工具调用,做智能体流程的可以接 API 跑一遍看视频理解够不够用。
点击打开原平台查看,能否访问取决于网络环境
12
X
Cohere 官方账号介绍 Superwhisper Meetings:会议记录与摘要全部在本地笔记本上完成,不上传云端,转写由 Tiny Aya 和 Cohere Transcribe 提供支持,官方称这是首次此类合作。对做访谈、口述脚本、素材整理和会议纪要的创作者来说,本地处理意味着素材不出机器,适合对保密有要求的项目。
会议录音和摘要全程留在本机不外传,靠 Tiny Aya 和 Cohere Transcribe 转写,做访谈、口述脚本、素材整理的可以装一个试试。
点击打开原平台查看,能否访问取决于网络环境
01
@Google
Google 官方演示:在 Gemini App 里用 Nano Banana、Veo 和 Gemini 4 Argon 三个模型接力,把一份密集的学术 PDF 转成全彩动画故事书。Nano Banana 负责图像生成,Veo 负责动画,Argon 承担整体流程。这是官方给出的多模型串联做内容改编的样本,适合做知识科普、绘本和图文转视频的团队参考分工方式。
Google 官方演示:Nano Banana 出图、Veo 出动画、Argon 串流程,把一份学术 PDF 变成全彩动画故事书。做知识类内容和绘本改编的可以看这套多模型接力怎么分工。
点击打开原平台查看,能否访问取决于网络环境
02
@Khazix0918
卡兹克实测开源项目 Skill Anatomy(GitHub:wheresryan22/anatomy),它能把抽象原理转成可交互的机械模型动画,在此基础上还能让 AI 一轮直出带讲解配音的科普视频。适合做原理拆解、知识科普类内容的创作者参考其工作流。
开源 Skill Anatomy 能把抽象原理做成可交互机械动画,再让 AI 一轮直出带讲解配音的科普视频。做知识类、原理拆解类内容的编导和后期可以拉下来跑一遍,看这套流程能不能套进自己的选题。
03
公众号
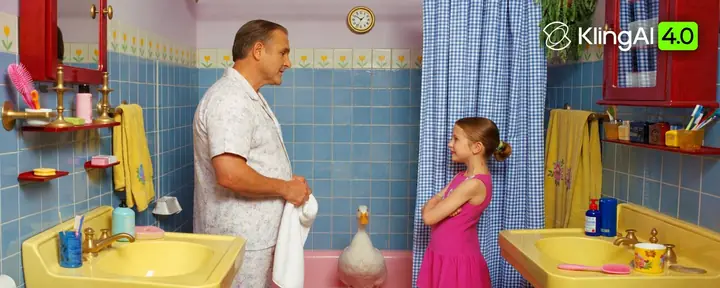
韩国视觉创作者서오키(@oasis.seo.ai)对 Kling 4.0 做了三组实测:人物表演与角色稳定性、三张图片连续转场、实拍与卡通反复切换。她的结论是 Kling 4.0 能自然衔接视线、表情和手势,多图连接时原图风格与氛围基本保留,实拍与卡通切换过程无明显割裂,减少了反复生成和后期修补的成本。
三组实测覆盖人物表演稳定性、三图连续转场、实拍与卡通来回切换,做角色一致性和转场衔接的视觉师可以照着这三项自己跑一遍。
点击打开原文,能否访问取决于网络环境
04
@shao__meng
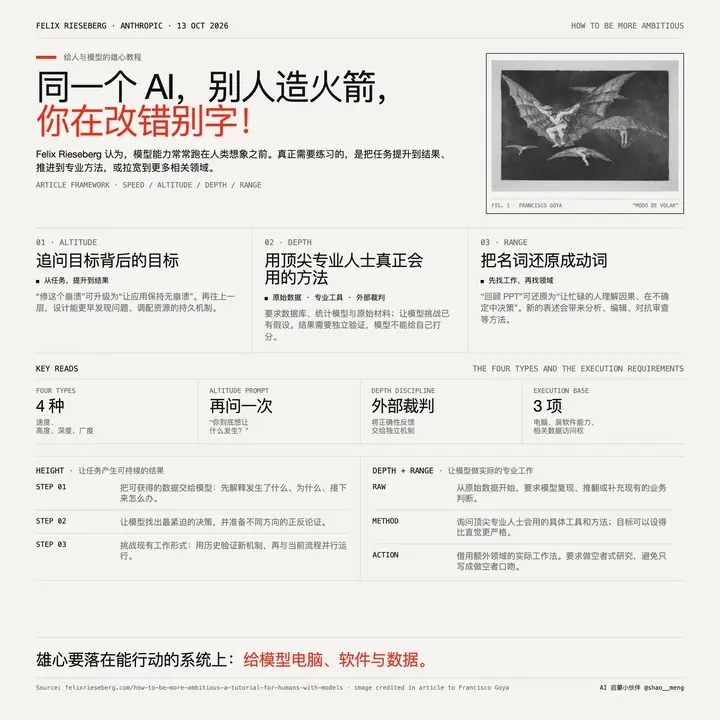
Claude 团队 Felix Rieseberg 发布一篇方法论教程,核心观点是 AI 能力已跑在人的想象力前面,瓶颈在人不敢要。他把「更有雄心」拆成三类:高度(追问目标背后的目标,比如从「修这个崩溃」升到「让应用保持无崩溃」)、深度(逼模型用真数据库、真统计模型等专业工具,并坚持用外部裁判验证,不让模型自己给自己打分)、广度(把名词还原成动词,暴露本来相关却没被请进来的领域)。前提是给模型电脑、装软件能力和数据访问权(如 MCP)。文中还附了一个 prompt 模板:先让模型回答顶尖专业人士会怎么做、最原始的材料是什么、怎么外部验证,再据此重写你的 prompt。
把「让 AI 干活」拆成高度、深度、广度三层,还给了让模型先自问「顶尖专家会怎么做」再重写 prompt 的模板。写剧本、做分镜、搭工作流的都能套着改一遍自己的提问方式。
点击打开原文,能否访问取决于网络环境
05
@shao__meng
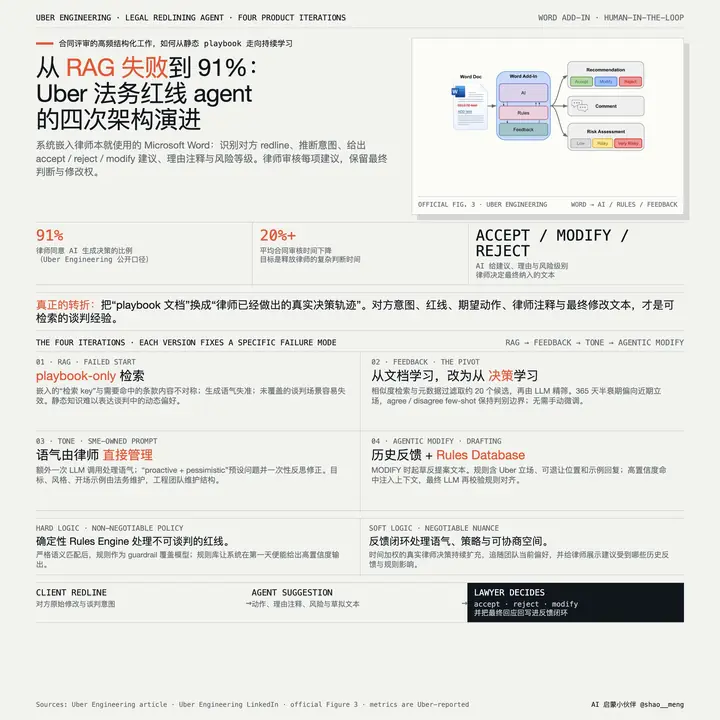
Uber 法务红线 Agent 经四次架构演进,AI 决策准确率达 91%,平均合同审核时间下降 20%+,法务部凭此获 2026 年 ALM Legalweek 年度最具创新力法务部奖。第一版朴素 RAG 因语义检索粒度错位、语气失控、无法泛化而失败;第二版改为从真实谈判决策轨迹学习,用相似度检索+元数据过滤取约 20 个候选再 LLM 二次精筛,配指数衰减加权(半衰期 365 天)和正负样本均衡 few-shot;第三版加独立 LLM 做语气调制,并把三段式 prompt 所有权交给律师。
从朴素 RAG 翻车到反馈闭环、语气分层,四版架构每一步的失败原因都写清楚了。做 AI 工作流和 Agent 的可以拆它的检索+二次精筛和指数衰减加权思路。
点击打开原文,能否访问取决于网络环境
06
@AYi_AInotes
CMU 计算机系教授 Keenan Crane 让大模型写了一段 27KB 的 GLSL 代码,用一个数学公式直接定义出一条完整的龙。这条龙不是三角形网格、不是 NeRF、不是 3DGS,也不是视频模型,而是一段程序:空间里任意一点代入公式就能判断自己在龙的内部还是外部,显卡沿光线逐步计算浮现出表面。用的是闭式隐式曲面,公式可直接求值,文件里没有权重只有数学。作者指出工业工作流目前仍主要吃网格,绑定、动画、物理、扫描重建还没法都塞进一个公式。
做 3D 资产的视觉师可以看看这个思路:不让 AI 拖控制点,而是让它写公式定义形状,27KB 文本文件贴多近都不糊,改一个参数整个形状跟着变。
点击打开原平台查看,能否访问取决于网络环境
07
公众号
公众号「卡尔的AI沃茨」提出「大AI理论」,用三阶段对话榨模型能力:第一步推理拉满并选计划模式,用语音、图片、视频不过滤倒出想法整理成计划;第二步切中档推理快速干活,前提是需求描述足够详细,作者引 Terminal Bench 3.0 说明详细需求加中档推理质量高于模糊需求加高档推理;第三步推理调回高档让 AI 审查中档成果,称能揪出约 20% 的问题,审查耗时约为从头生成的三分之一。
把「拉满推理出计划、中档快速干活、高档回头审查」串成一套对话流程,作者称审查能揪出约两成问题、耗时只有从头生成的三分之一,天天跟模型磨剧本和分镜的可以照着跑一遍。
08
@PixelAigc
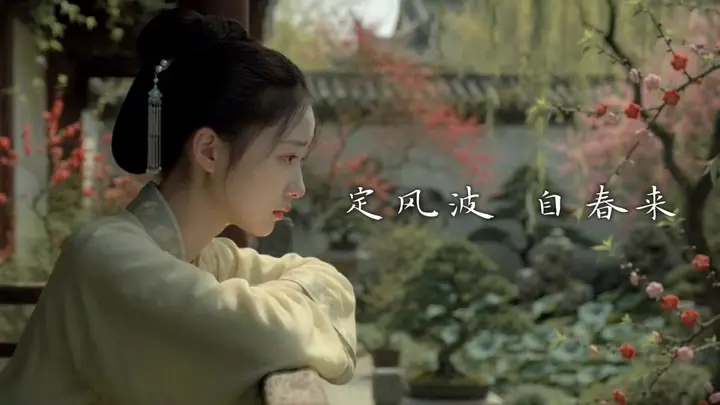
作者用 muse 免费一键生成 60 秒宋词意境系列视频,以柳永《定风波·自春来》为题,提示词为「以此风格继续做定风波自春来诗意视频60秒」,成片人物一致性和风格一致性稳定,宋式美学执行到位、色调偏高级,后期在剪映里加文字和背景音乐。做国风诗词系列短片的可参考这套「定风格+续写时长」的提示词写法。
用 muse 跑柳永《定风波》宋词系列,人物和风格一致性稳、宋式色调到位,剪映补字幕配乐。做国风短片和诗词系列的可以照这个提示词结构试一遍。
点击打开原平台查看,能否访问取决于网络环境
09
@shao__meng
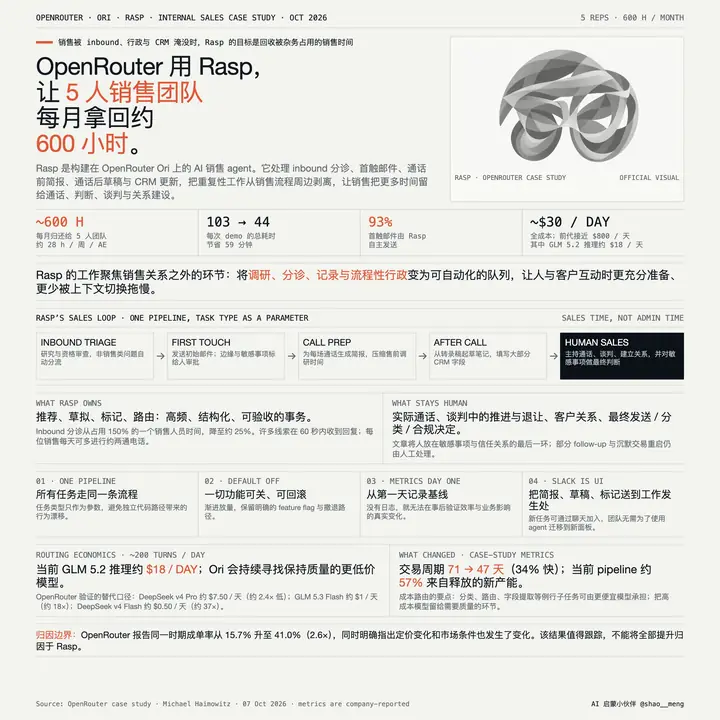
OpenRouter 为 5 人销售团队自建 AI 智能体 Rasp,自动调研分流 inbound 线索、自主发首触邮件(93% 全自动)、写通话前简报和通话后笔记、填 CRM 字段,敏感事项转人工。月省约 600 小时,单次 demo 从 103 分钟降到 44 分钟,交易周期缩短 34%。推理用 GLM 5.2 约 18 美元/天,路由层可自动切到便宜 2.4 至 37 倍的替代模型。四条经验:单一流程处理所有任务、功能默认关闭渐进放量、第一天就埋指标、把界面放进 Slack。
5 人销售团队靠一个智能体每月省 600 小时,93% 首触邮件全自动,demo 准备从 30 分钟压到 5 分钟。做制片和团队管理的可以看它的四条工程原则——单一流程、默认关闭、先埋指标、Slack 当界面。
点击打开原文,能否访问取决于网络环境