01
@GoogleDeepMind
Google DeepMind 官方宣布 Gemini 4 Argon 现已全球可用,官方描述其定位是「从始至终解决最难的问题」,前沿能力集中在编码、企业工作流和网络防御三个方向。也未给出参数、价格或上下文长度等细节。对 AIGC 技术整合者来说,可关注它在自动化脚本、Agent 调度和批量处理上的表现;对以影像生成为主的编导、视觉和后期岗位,这条暂无直接可用的创作能力。
Google 新旗舰 Gemini 4 Argon 全球开放,官方主打编码、企业工作流和网络防御三块能力,没提视频图像生成。做 Agent 自动化和批量脚本的技术整合者可以接 API 测一周,纯拍片的编导这条先放一放。
点击打开原平台查看,能否访问取决于网络环境
02
OpenAI Blog
Higgsfield 宣布接入三款 OpenAI 模型:GPT-6 Astra 把 AI 视频生成时长从 1 分钟提升到 10 分钟以上,GPT-Image-2.5 负责更精确的画面细节,GPT-Live 提供语音驱动的影片制作路径。三条能力分别对应长片叙事、视觉精度和配音/口播方向。
AI 视频从 1 分钟拉到 10 分钟以上,还配了 GPT-Image-2.5 的画面精度和 GPT-Live 的配音路径,做 AI 短剧和长叙事的这周可以上手跑一遍看长片稳不稳。
03
@FishAudio
Fish Audio 官方介绍 TTS 模型 Drama 3(该产品 10 月 8 日已发布),称其为目前情感表达和可控性最强的语音模型,且开源权重。支持对单个词的发音、语气进行控制,并可在句子中途切换音色。官方同时披露 5200 万美元种子轮融资、1500 万以上用户,并给出试用链接,48 小时内评论「DRAMA」可获一个月免费,企业用户首月免费。
Fish Audio 放出开源权重的 TTS 模型 Drama 3,主打情感表达和逐词控制,配音和短剧团队可以接进来试一周,看情绪戏能不能少返工。
点击打开原平台查看,能否访问取决于网络环境
04
@MiniMax_AI
MiniMax 宣布 FastH3-Omni 登陆 Reactor,可从单个提示词生成带同步音频的视频,10 月 20 日前在 Reactor API 开放预览。该开源版本由 FastVideo 与 nuvalab 对 MiniMax 实时 H3 做后训练得到,支持首尾帧条件控制、音频输入与强对话能力、最多 3 张参考图像。
单提示词直接出带同步音频的视频,还支持首尾帧控制和最多 3 张参考图,做短剧和配音的可以接 API 跑一周,看口型对得上多少。
点击打开原平台查看,能否访问取决于网络环境
05
@haoailab
UCSD Hao AI Lab 的 FastVideo 团队发布 FastH3-Omni 实时模型,与 Nuva Lab、Reactor 合作完成后训练。模型今日起可通过 Reactor 的 API 访问使用,10 月 20 日将完全开源并放出训练代码,同时支持 DGX spark 和 RTX GPU。
实时视频生成模型,今天就能通过 Reactor 的 API 调用,10 月 20 日开源权重和训练代码。做实时数字人、直播互动、AI 短剧的可以先去接 API 跑一遍看延迟。
点击打开原平台查看,能否访问取决于网络环境
06
AIHOT 全部动态
LTX 发布 LTX Trainer,把 LoRA 训练收进 LTX Explore 的单一引导流程:选 Character LoRA 或 Style LoRA、命名、设一个触发词即可,不用写配置文件。训练前自动 QC 检查上传素材,默认排除运动模糊、遮挡等劣质片段;素材最低五分钟、无上限,训练后台运行并邮件通知,完成后可在平台内测试 30 天或导出下载。
角色 LoRA 和风格 LoRA 都能在 LTX Explore 里点几下训完,素材自动筛掉运动模糊和遮挡片段,做角色一致性和固定画风的可以拿自己的素材跑一轮看效果。
07
@Google
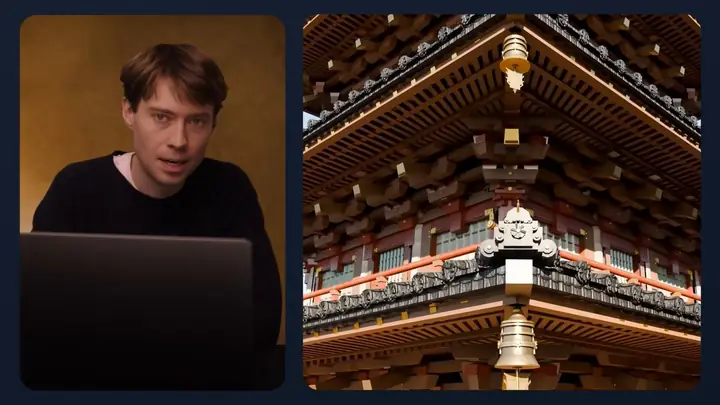
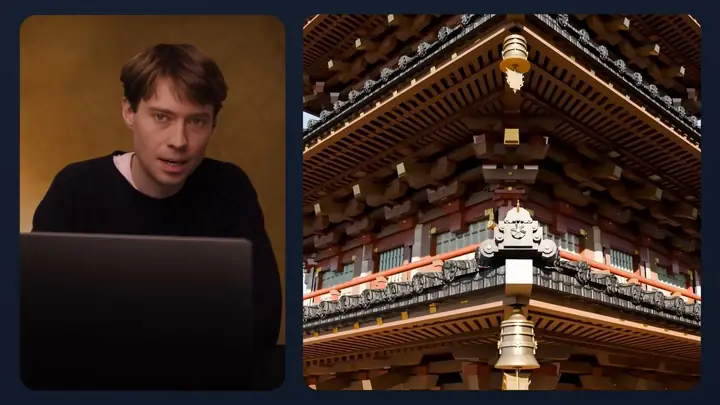
Google 官方发布 Argon,称其在空间推理、数学精度和视觉编程三方面有重大改进。演示中在 @Antigravity 里跑多智能体循环,自主在 Blender 中从零雕刻建筑、植被和光照,搭出整座宝塔建筑群。对做 3D 场景、视觉开发和自动化建模的创作者来说,这条展示的是 AI 直接操作 Blender 完成复杂空间搭建的能力,可关注其工作流接入方式。
Google 官方称 Argon 在空间推理和视觉编程上有明显提升,配合 Antigravity 的多智能体循环能自主在 Blender 里从零搭出整座宝塔建筑群。做 3D 场景和视觉开发的可以关注这条流程。
点击打开原平台查看,能否访问取决于网络环境
08
@arena
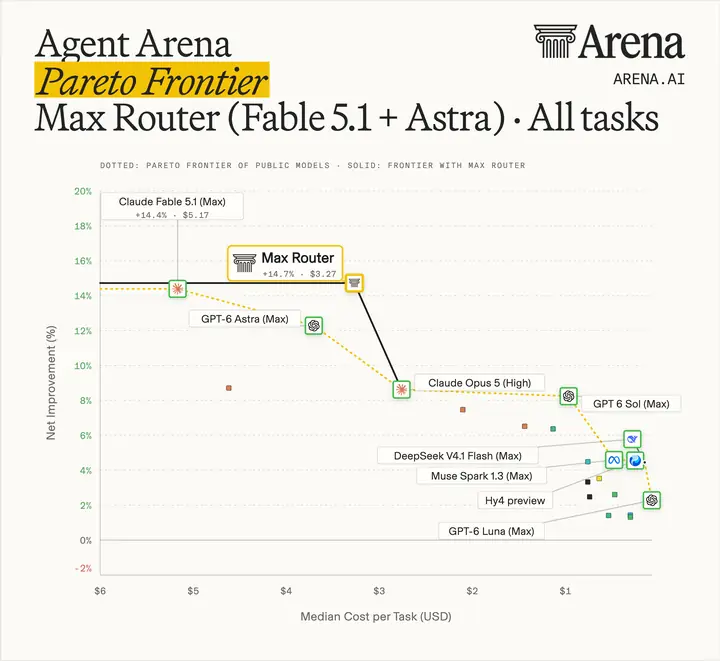
Arena 推出智能体版 Max 模型路由器,基于 Agent Arena 的 250 万次真实智能体会话训练,可为每个任务动态选择最优模型。官方称 Max 在 Agent Arena 中取得 +14.7% 的净提升分数,单任务中位成本 3.27 美元,以低 37% 的成本匹配 Claude Fable 5.1 (Max) 的性能,目前限时可试用。
按任务自动挑最合适的模型,单任务中位成本 3.27 美元,比 Claude Fable 5.1 便宜 37% 还打平性能。自己搭 Agent 流程的可以接上跑一周,看账单和出活质量怎么变。
点击打开原文,能否访问取决于网络环境
09
NVIDIA Blog
NVIDIA 官宣 RTX Spark 平台软件生态就绪,笔记本将于 10 月 16 日上市,最高 128GB 统一内存、1 petaflop AI 算力,整合 RTX 与 CUDA 全栈技术。同步更新 GitHub Copilot、Hermes、OpenClaw、Perplexity、Pi、WorkBuddy 等 Agent 应用,新增 OpenShell 与 Microsoft Execution Containers 安全机制,支持本地与云端混合 AI 调度;专为本地 Agent 打造的 Nemotron 3.5 Bolt 74B 模型 10 月 15 日发布,NVIDIA PAIR 转正式版并支持 llama.cpp。
128GB 统一内存加 1 petaflop 本地算力,跑本地大模型和 Agent 的创作者可以盯一下,10 月 16 日上市前先看软件生态适配清单。
点击打开原文
10
@elevenlabs
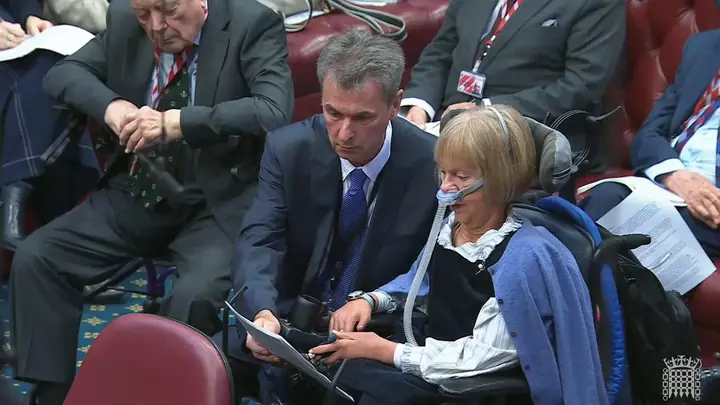
ElevenLabs 宣布,患有脊髓性肌萎缩症的 Baroness Campbell of Surbiton 今日在英国上议院用其 AI 重建嗓音发表演讲,为英国议会首次。该 AI 嗓音复刻了她原声的音调、节奏和音高。ElevenLabs 称其技术已帮助超过 11,000 名因伤病失声者恢复嗓音,并承诺帮助全球 100 万失声人群。
AI 复刻嗓音第一次进英国议会,音调、节奏、音高都还原本人。做配音、虚拟角色和纪录片旁白的可以看看这条技术落地的边界在哪。
点击打开原平台查看,能否访问取决于网络环境
11
Hacker News (Top)
Character.ai 官方宣布启动自愿 Chapter 11 破产程序,以推进法院监督下的公司出售。官方称过去一年在法务、监管和运营压力下已采取多项措施维持业务,董事会评估后认为出售是最优路径。平台目前仍正常运行,若无人接盘则将被关停。
做 AI 角色对话和虚拟人设的团队留意:官方称若无买家接手,平台将关停,依赖它做角色 IP 的项目该准备迁移方案了。
点击打开原文
12
@Stefan_3D_AI
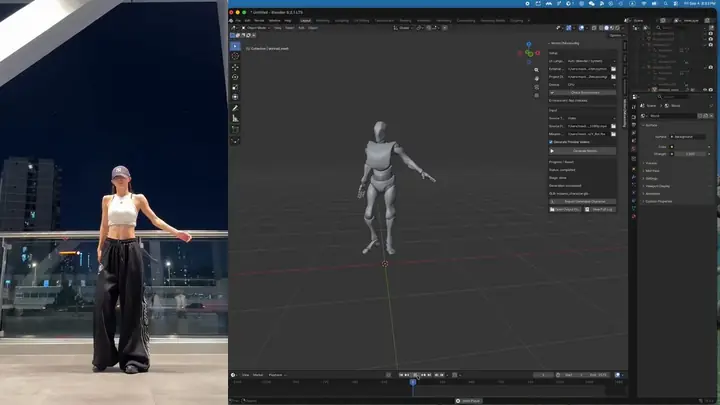
Stefan 3D AI 分享开源工具 Motion2MixamoRig,把视频中人物的动作复制到 Mixamo 装配的角色上,输出适用于 Blender 或 Unity 的蒙皮 GLB 文件。支持视频或单张照片作为输入,新增 Blender 4.2+ 扩展面板,可在 CPU、CUDA 或 Apple Silicon 上本地运行,同一段动作几十秒内可复用到其他角色,代码 Apache-2.0 开源,GitHub 地址已公开。
免费开源、Apache-2.0,一段视频或一张照片就能把真人动作套到 Mixamo 骨架上,直接导出 Blender/Unity 用的蒙皮 GLB,本地 CPU 也能跑。做 3D 动画和虚拟角色的可以拉下来试,同一段动作几十秒换到别的角色身上。
点击打开原平台查看,能否访问取决于网络环境
13
@OpenRouter
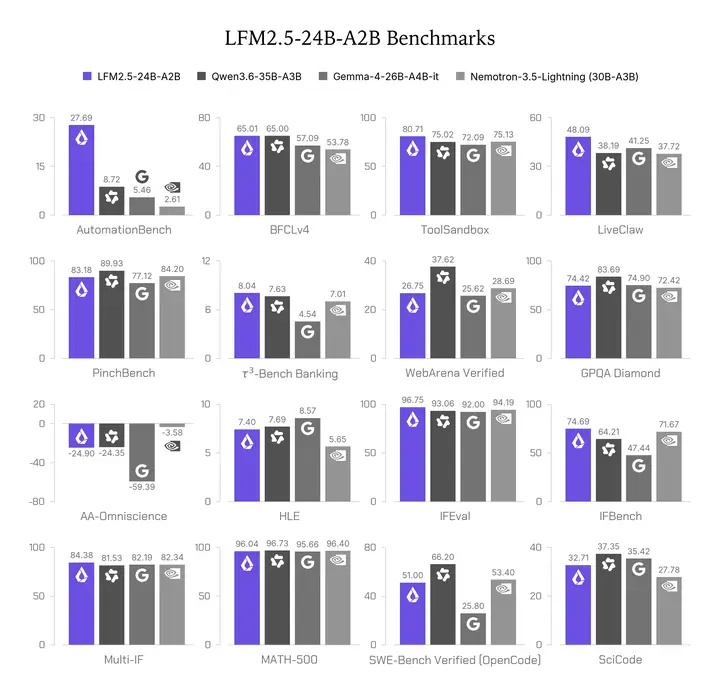
Liquid AI 发布 LFM2.5-24B-A2B,为 LFM2.5 系列最大成员,已在 OpenRouter 上线。24B 总参数、每 token 2B 激活的 MoE 推理模型,上下文扩至 131K tokens,词表 128K,33T 预训练 tokens,面向笔记本和 PC 本地运行 Agent 与工具调用多步任务,在 agentic 和 tool-use 任务上可与总参数和激活参数多约 50% 的 Qwen3.6-35B-A3B 竞争,开源 base 和 post-trained 权重已发布于 Hugging Face。
24B 总参数、每 token 只激活 2B 的 MoE 推理模型,主打笔记本本地跑 Agent 和工具调用,权重已开源。做本地自动化流程的技术整合者可以拉下来测多步任务稳不稳。
点击打开原文,能否访问取决于网络环境
01
@xiaohu
微软研究院开源 Code Video Model,用代码方式生成视频:先写一段类似网页 3D 引擎的代码,在虚拟空间里摆好舞台、桌椅、角色和摄像机机位,算好运动轨迹与物理碰撞,跑出低精度动态小样,改一行代码即可调整构图。细节阶段采用 Early-step Conditioning 调度机制,只在扩散采样最前几步参考代码视频定构图和动作骨架,后续撤掉代码参考、按参考图还原真实质感,避免成片带塑料感。
把电影工业的 Previs 搬进 AI 视频:先写代码摆好机位走位,再撤掉代码让模型补真实质感。做分镜和镜头调度的编导可以盯一下这套思路。
点击打开原平台查看,能否访问取决于网络环境
02
@oran_ge
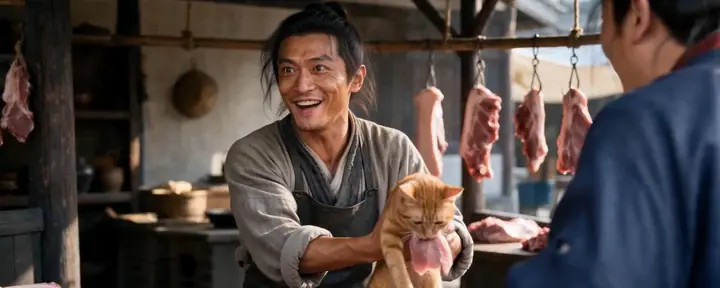
博主以视频创作小白身份,用 Miora 织影 Agent 把南宋《夷坚志》轶闻《乾红猫》做成 1 分 18 秒古装轻喜剧短片。Agent 负责把故事拆成框架、大纲、剧本、角色卡和分镜,全程生成 50 段视频,花费约 4000 积分(折合约 40 美元),视频部分使用 Seedance Fast。
从故事框架到分镜全交给 Agent,50 段视频约 4000 积分(约 40 美元)出一部古装轻喜剧,做短剧的可以照着跑一遍看成本能不能压住。
点击打开原文,能否访问取决于网络环境
03
@GeokenAI
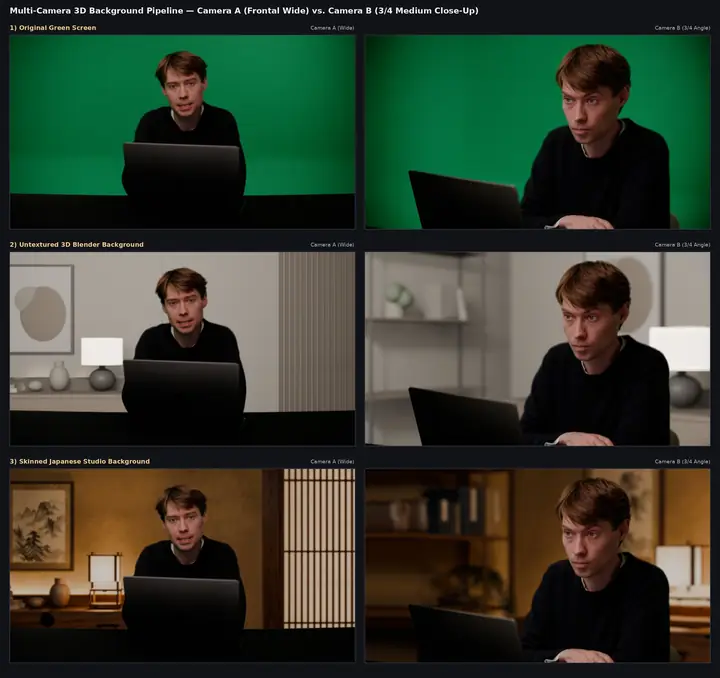
创作者 George Kenwright 展示了一套绿幕换背景流程:把两张绿幕静态图交给 Gemini 4 Argon,让它 1) 在 Blender 中搭建房间,2) 还原原片相机角度,3) 用 Nano Banana 给 Blender 背景「蒙皮」以匹配前景光照与质感,4) 把背景抠回原始视频。作者称两个机位角度都得到了准确的背景匹配。
绿幕换背景的老难题,这条给出了可复现的四步做法:Argon 在 Blender 里搭房间、还原机位,Nano Banana 给背景蒙皮,再抠回原片。做虚拟制片和后期合成的可以照着跑一遍。
点击打开原文,能否访问取决于网络环境
04
Tripo
Tripo 官方转发创作者 @Saccc_c 的作品:用 Tripo 生成 3D 资产、Blender 搭建场景、Opus 5.5(@ClaudeDevs)负责交互逻辑,16 天完成《小王子》3D 互动世界改编,官方表示期待后续开源发布。对做 3D 互动内容和 AI 资产生成的创作者来说,这是一条把生成模型、建模软件和 AI 编程串成一条流程的实操样本。
16 天用 Tripo 生成资产、Blender 搭场景、Claude 写交互,做 3D 互动内容的可以看这条工作流怎么串起来。
点击打开原平台查看,能否访问取决于网络环境
05
Baseten 工程博客
Baseten 工程博客解析 Gradium TTS 的实时语音合成实现:采用 Delayed Streams Modeling 架构,配合 kernel fusion 和 CUDA Graphs 等 GPU 优化,不等整句生成完就开始出声。Coval 基准测得 TTFA 中位数 155 ms、四分位距仅 2 ms(另一处数据为 214 ms),已作为专用部署上线 Baseten Model Library,官方提供 TTS Latency Race demo 和代码仓库。做 AI 配音、虚拟角色对话和实时字幕的可以关注它的延迟表现。
做 AI 配音和虚拟角色对话的可以看这篇:Gradium TTS 首音延迟中位数 155ms、四分位距仅 2ms,延迟预算稳得住,接进对话流程里能明显减少抢话和卡顿。
点击打开原文
06
X
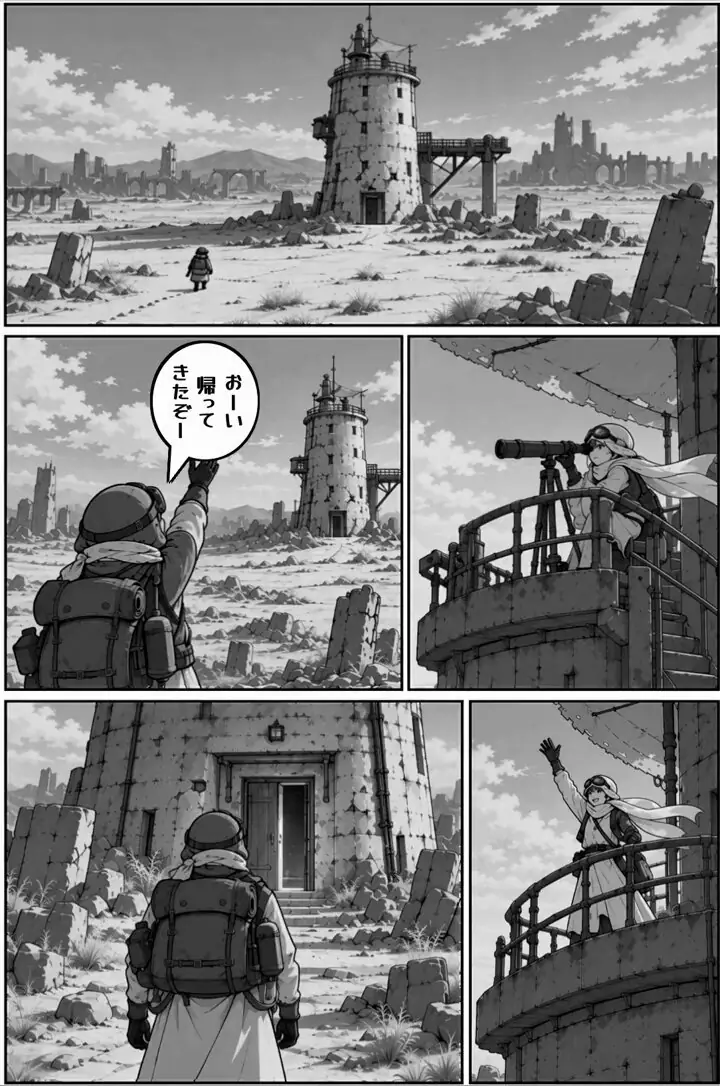
MiniMax 官方账号引用 @monoradio102 的示例,展示用 MiniMax-H3 搭配 ORB360 LoRA 把黑白漫画角色做成可动视频,镜头角度能自由运动,传入角色参照图即可固定面部。原作者感叹开源让 AI 创作变得有趣,想回父母家翻旧书架上的漫画。
漫画 IP 动起来的一条现成路子:传角色参照图锁脸,镜头角度还能自由转。做漫画改编和风格化短片的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
07
@tuboshu321
作者给 Gemini 4 Argon High 和 Opus 5.5 xhigh 出了同一道题:用同样的工具搜集 Argon 信息,各做一支自我介绍片。Argon High 出活快、只花 5x 周额度的 6%,但镜头之间缺乏连贯,美术偏 90 年代复古感;Opus 5.5 xhigh 消耗 20x 周额度的 3%,先理解核心意图、再拆解分镜脚本、按需调用工具做素材,成片完成度更高。
同一个任务、同一套工具,两个模型交出来的片子画风差得离谱——Argon 快且省额度但镜头之间没连贯性,Opus 5.5 会先拆分镜再调素材。做 AI 短片和分镜的可以拿这个对比当选型参考。
点击打开原平台查看,能否访问取决于网络环境
08
Suno
Suno 官方博客介绍 v6 幕后故事(该产品 9 月 10 日已发布):艾美奖获奖导演兼编舞 Nina McNeely 与舞者 Braylon Browner、音乐人 Banoffee 合作,两人均以 Suno v6 为基础创作原创歌曲,并完成两次拍摄。内容聚焦音乐人如何把 v6 生成的歌曲接入实际拍摄与编舞流程。做 MV、短片配乐、声音设计的可以关注 v6 在原创歌曲创作与实拍结合上的具体用法。
艾美奖获奖导演兼编舞 Nina McNeely 用 Suno v6 做原创歌曲并完成两次拍摄,做 MV、短片配乐和声音设计的可以看看音乐人怎么把 v6 塞进实际拍摄流程。
点击打开原文
09
@Diesol
创作者 @Diesol 发布首条测试动态,称正在把 Kling 4.0 与 Seedance 2.5 两个视频模型混合使用,配文仅一句「First tests」加一个眼睛表情,未附成片或参数说明。对做 AI 视频的创作者来说,这条的价值在于提示两个模型可以组合进同一条工作流,具体分工方式和出片效果要等作者后续放出。
两个模型混着用的首测,做视频的可以蹲后续成片看两套模型怎么分工,目前只有一句预告。
点击打开原平台查看,能否访问取决于网络环境
10
@vista8
向阳乔木(@vista8)分享自己做的音视频学习工具,功能包括字幕转写、翻译、AI 对话,以及从 X、B 站、抖音、TikTok、小宇宙下载音视频,安装 Prompt 放在评论区。对做后期和素材整理的创作者来说,这类把转写、翻译、下载串在一起的小工具能省掉来回切软件的时间,具体实现方式需看评论区 Prompt。
字幕转写、翻译、AI 对话加多平台音视频下载打包在一个工具里,做后期和素材整理的可以照评论区 Prompt 自己搭一套试试。
点击打开原平台查看,能否访问取决于网络环境