01
@reach_vb
@reach_vb 转述称 GPT-6.1 Sol Ultrafast 开始推出(该产品 9 月 30 日已发布),token 生成速度最高比 Sol Standard 快 8 倍,API 定价为每 100 万输入 token $12、每 100 万输出 token $60,已在 API、Codex 和 ChatGPT Work 中上线。对需要批量跑剧本、字幕、分镜文案的团队来说,速度提升直接压缩等待时间,可先按现有用量估算成本再决定是否切换。
GPT-6.1 Sol Ultrafast 主打速度,token 生成最高比 Sol Standard 快 8 倍,输入 $12 / 输出 $60 每百万 token,已进 API、Codex 和 ChatGPT Work。做批量脚本、字幕、分镜文案的可以接 API 跑一轮比价。
点击打开原平台查看,能否访问取决于网络环境
02
公众号
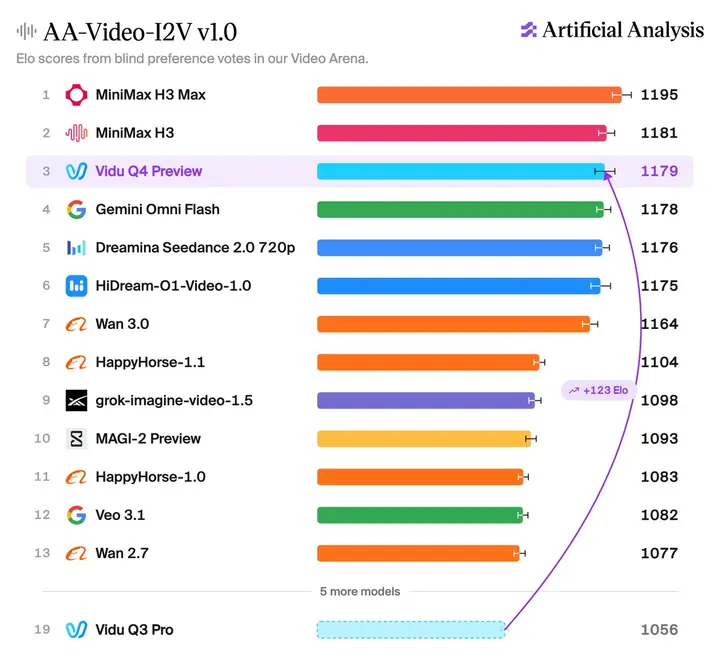
生数科技官方介绍视频生成旗舰模型 Vidu Q4 的预览版 Vidu Q4 Preview(该产品 10 月 8 日已发布),主打人物演技、镜头语言与特效表现力。新版本最多支持 3 段参考音频和 15 张参考图,支持 2K、4K 输出与 10bit 色深,首发优惠价 0.09 元/秒起,官方称同样预算约 5 倍出片,并从 Day 1 起面向全球创作者开放。
Vidu Q4 预览版主打人物演技和镜头语言,最多吃 3 段参考音频、15 张参考图,2K/4K 加 10bit 色深,0.09 元/秒起。做短剧和数字人对话的可以拿同一段剧本跑一遍,看口型和情绪稳不稳。
点击打开原平台查看,能否访问取决于网络环境
03
@sundarpichai
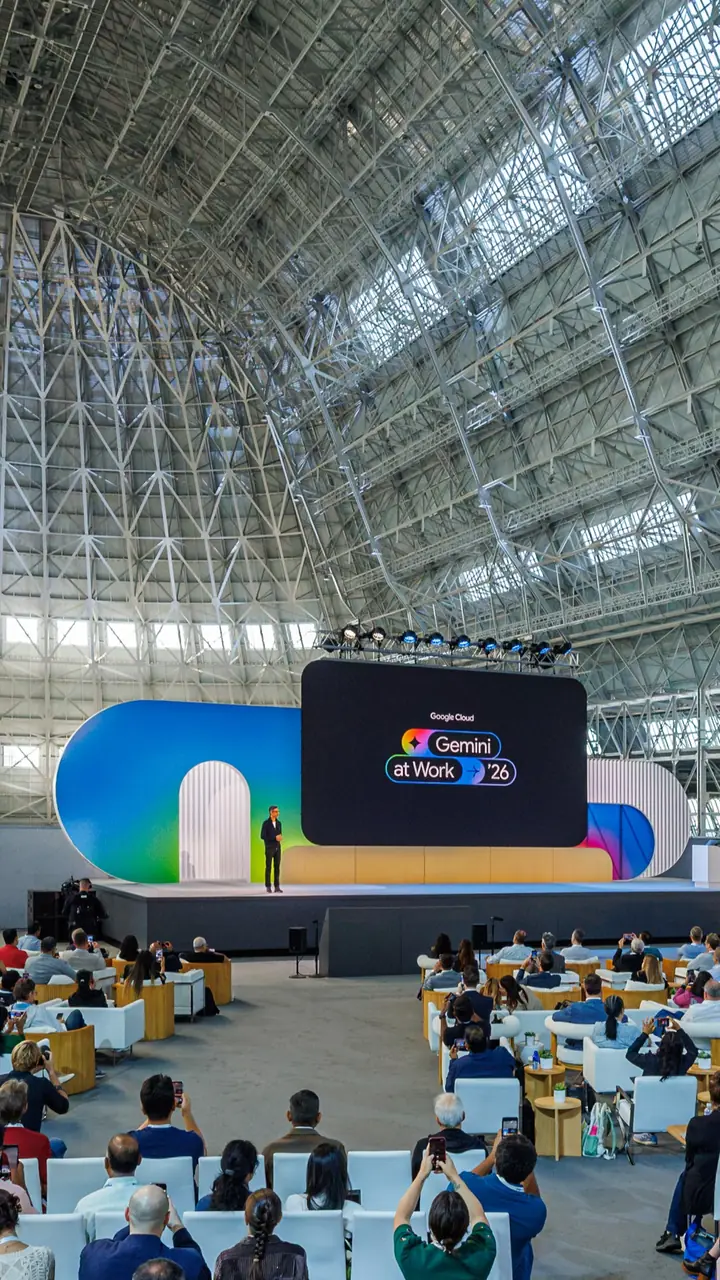
Sundar Pichai 在 NASA Hangar One 面向 700 多名 Google Cloud 客户发布 Gemini agent,一个统一通用工作智能体:单一提示框内完成问答、知识工作、图像与媒体生成、代码编写与运行。核心架构包括统一智能体、网页端跨设备访问并可集成第三方应用、云端持久执行(跨端共享记忆与个性化图谱)、多智能体调度(可创建子智能体处理多步任务、也可作为有独立身份的角色智能体)、上下文感知与多模型调度。
Google 把问答、知识工作、图像媒体生成、写代码跑代码塞进一个提示框,还能自己拆子智能体干多步任务。做团队协作和自动化流程的可以研究它的多智能体调度怎么接。
点击打开原文,能否访问取决于网络环境
04
@anvisha
Anvisha 发布 Voyager,定位为面向视频、图形和游戏的开放式创作平台,自称「创意工作的 Codex」。它可从 Opus、Astra、DeepSeek 等模型获取创意结果,自带免费图形、音乐和视频剪辑工具,也能驱动 Blender、Resolve、After Effects、Ableton 等 100+ 软件。发布帖称该 thread 内所有内容均由 Voyager 制作。
自称「创意工作的 Codex」,能直接驱动 Blender、Resolve、AE、Ableton 等 100+ 工具,还自带免费图形/音乐/剪辑功能。做后期和视觉的可以上手跑一遍,看它调度现有软件这套流程顺不顺。
点击打开原平台查看,能否访问取决于网络环境
05
@HeyGen
HeyGen 宣布与地产界知名人士 Ryan Serhant 合作,用其官方数字分身推出一档每日更新的视频栏目,内容覆盖销售、商业和品牌建设,本人无需出镜拍摄。完整报道见 Variety。对做个人 IP 日更、口播栏目和数字人代播的团队来说,这是一条把数字分身从单条 demo 推向「日更栏目化运营」的落地样本。
HeyGen 用官方数字分身替 Ryan Serhant 日更视频栏目,做 IP 日更和口播内容的团队可以看看这套「本人不出镜也能天天更新」的玩法。
点击打开原平台查看,能否访问取决于网络环境
06
@dreamina_ai
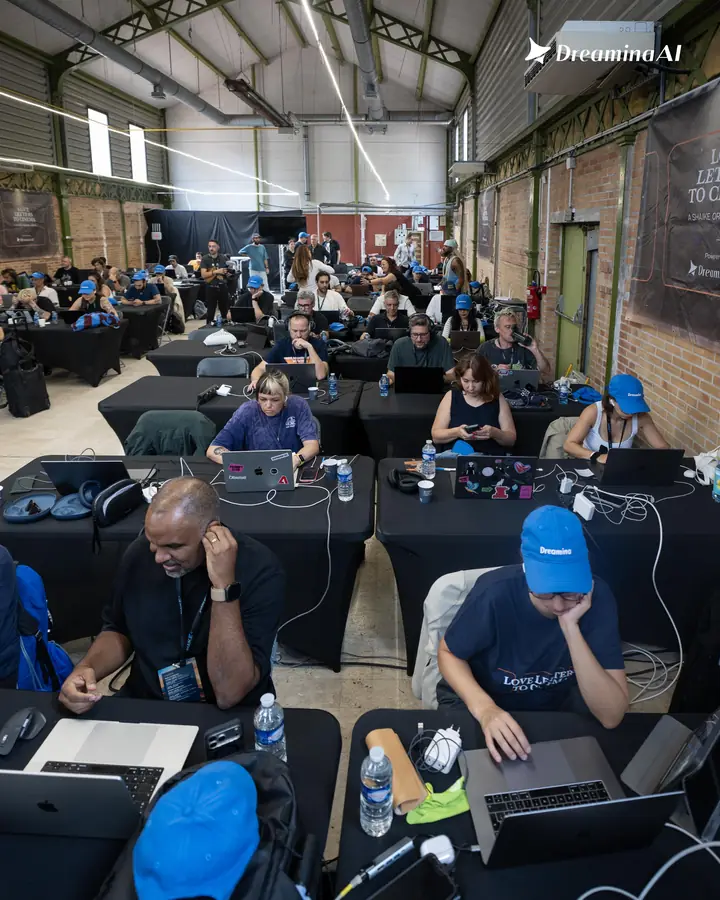
Dreamina 在电影诞生地法国拉西约塔举办活动,聚集来自 30 多个国家的 100 位 AI 创作者与电影人,围绕同一主题「Love Letter to Cinema」各自创作。活动上官方介绍了 Dreamina 新的 Canvas 体验和 Seedance 2.5 预览模式,称提供更灵活的创作方式。现场产出的 100 部短片将陆续发布。
Dreamina 在电影诞生地拉来 30 多国 100 位 AI 创作者同题拍片,顺带放出 Canvas 新界面和 Seedance 2.5 预览。做 AI 短片的可以盯这批百部短片上线,看不同团队怎么处理同一主题。
点击打开原文,能否访问取决于网络环境
07
@dreamina_ai
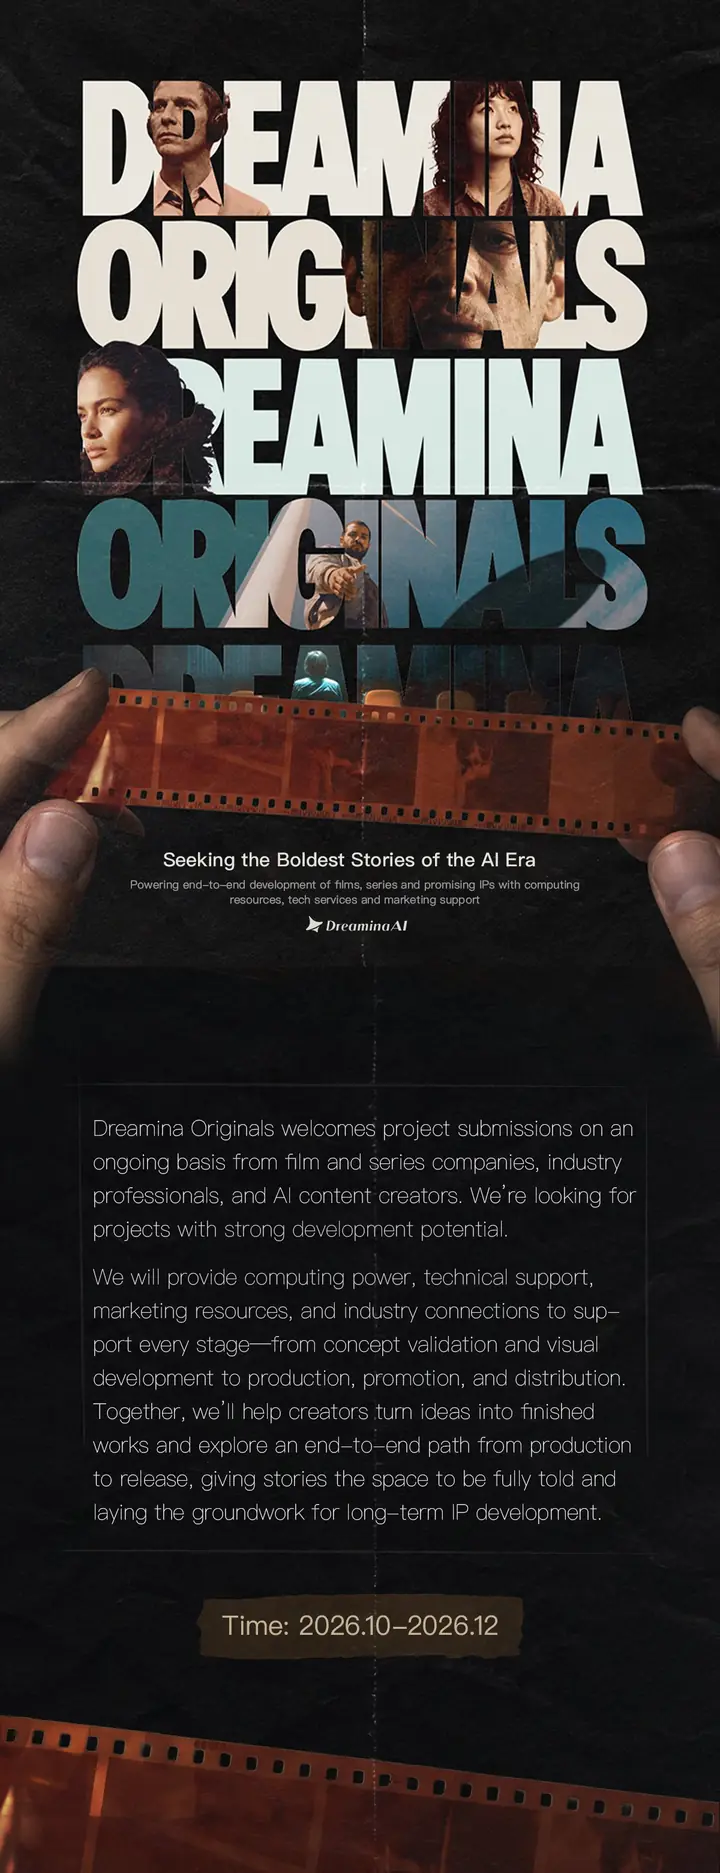
Dreamina AI 正式推出 Dreamina Originals,定位为面向 AI 影视与剧集内容的专业厂牌,官方称将提供算力、技术、AI 创作工具以及头部发行资源,覆盖从制作到发行的全流程,并邀请创作者共同打造 AI 时代的影视内容与 IP。对做 AI 短剧和长片的团队来说,这是一条平台侧的资源扶持信号,具体合作门槛和申请方式尚未在原文中给出。
即梦官方下场做 AI 影视厂牌,给算力、工具和发行资源,做 AI 短剧和长片的团队可以盯一下它的合作入口和扶持条件。
点击打开原文,能否访问取决于网络环境
08
@OpenRouter
阶跃星辰(@StepFun_ai)新旗舰 Step 5 Preview 已在 OpenRouter 上线。稀疏 MoE 架构,27B 激活 / 600B 总参数,1M 上下文,支持文本、图像、视频三种输入,官方定位为面向 Agent 任务的旗舰模型,在编程和专业领域知识(尤其金融)上表现较强。对创作者而言,视频输入 + 1M 上下文意味着可以整段素材或长剧本丢进去做理解与检索,但这条本身是模型上架消息,没有生成能力或创作工作流相关的说明。
阶跃新旗舰走 Agent 路线,600B 总参数只激活 27B,1M 上下文能吃长剧本和整季素材,支持文本/图像/视频输入。做技术整合的可以接 API 测一下长文档和视频理解,纯拍片的先观望。
点击打开原文,能否访问取决于网络环境
09
OpenAI Blog
OpenAI 官方通报,已处置两起借助 AI 开展的影响行动:操作方用虚假媒体身份(假记者)和一家假智库散布地缘政治信息。这是平台侧对 AI 生成内容被用于舆论操纵的封禁说明,涉及账号与内容处置。对 AI 影视/AIGC 创作者而言,这条不涉及创作工具或工作流,属于平台合规与风控动态,做 AI 内容分发和账号运营的可留意平台对 AI 生成内容的判定口径。
OpenAI 官方通报封禁两起用 AI 假扮记者和智库的舆论操作,做 AI 内容合规和平台风控的可以点开看它怎么界定和处置。
10
@CanavanCathal
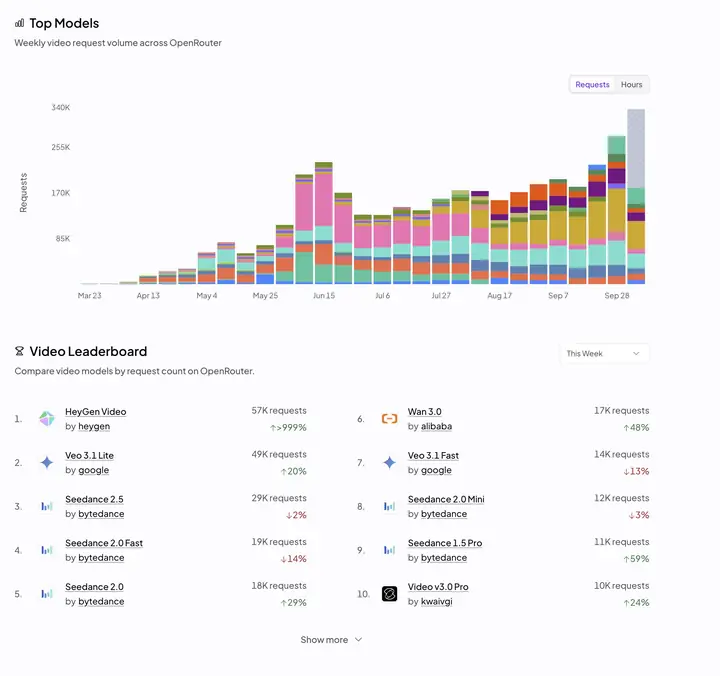
HeyGen 员工 Cathal Canavan 发推称,HeyGen Video 本周在 OpenRouter 上是排名第一的视频模型,为庆祝在接下来 48 小时内发放兑换码,每个兑换码可生成 100 个免费视频,回复推文即可领取,产品入口为 heygenvideo.com。对做数字人、口播类内容的团队来说,这是一次零成本试跑额度,可用来测人物一致性和批量出片表现。
HeyGen Video 本周在 OpenRouter 视频模型调用量排第一,官方放 48 小时兑换码、每个能白跑 100 条视频。做数字人和口播短剧的可以回帖领一个,先测一轮出片稳定性。
点击打开原平台查看,能否访问取决于网络环境
11
@zhongerxin
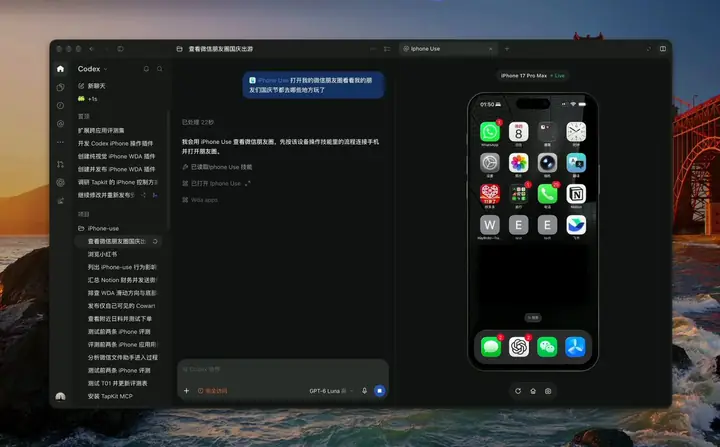
开发者钟二信(@zhongerxin)发布自研插件 iPhone Use,让 Codex 直接操作用户自己的手机,目前已能稳定完成刷微信朋友圈、总结微信群聊、淘宝下单、点美团外卖、发小红书帖子等常用 App 操作,项目链接随推文附出。属于手机端自动化操作方向,与影像生成、剪辑、配音等创作环节无直接关系。
个人开发者做的 Codex 手机操作插件,能刷朋友圈、总结群聊、下单点外卖、发小红书。跟拍片剪片关系不大,做自动化发布流程的可以瞄一眼。
点击打开原平台查看,能否访问取决于网络环境
01
@op7418
歸藏(@op7418)分享用 Grok bot 每天早上定时产出一条 AI 早报视频,内容收集、写代码、视频渲染全部在 Grok 云端虚拟机上完成,不占用本地电脑,并公开了可直接复制的提示词。适合做资讯日更、想搭定时自动出片流程的创作者参考。
内容收集、写代码、视频渲染全跑在 Grok 云端虚拟机上,本地电脑不参与,还公开了可复制的提示词。做日更资讯号或想搭自动化出片流程的,可以拿这套跑一遍。
点击打开原平台查看,能否访问取决于网络环境
02
Tripo
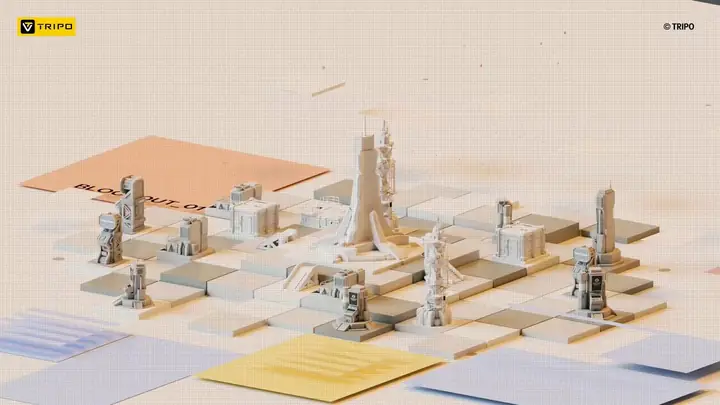
Tripo 官方演示用 P2.0 搭建关卡 blockout 素材包的三步流程:先用 P2.0 生成完整环境,导入 Blender 后执行 Separate → By Loose Parts 拆分,作者称得到原生四边面拓扑、可用于生产的资产,把数小时的工作压缩到几分钟。适合做场景预演、关卡白模和美术资产拆件的团队实测。
三步流程:P2.0 生成完整环境 → 导入 Blender → Separate by Loose Parts 拆件,官方称输出原生四边面拓扑、可直接投产。做场景美术和预演的可以照着跑一遍,看拆出来的件能不能直接进 Blender 用。
点击打开原平台查看,能否访问取决于网络环境
03
@TopviewAIhq
Topview 官方发布《Dark Fables》中 Nymeris 段落的制作拆解,说明该片段结合了现场实拍特技演员、Topview Film Studio 与 Seedance 2.5 完成,主打「真实动作 + AI 放大」的混合制作方式。对做奇幻、动作题材的创作者来说,这是一份实拍与 AI 生成如何拼接的参考样本,可关注真人特技素材与 AI 画面的衔接和质感统一。
实拍特技打底、Seedance 2.5 补奇幻战场,这条把「真人动作 + AI 生成」的混合流程讲了一遍,做奇幻题材和动作戏的编导可以拉片看衔接处理。
04
@xiaohuiyuan
晓辉博士(@xiaohuiyuan)花两三天和 AI 一起打磨出一套长访谈剪辑工作流,把积压的几期访谈剪完:加字幕、校对、挑金句、加包装、做封面都由 AI 执行,人负责提要求。他提到最花时间的是把自己的审美和标准讲清楚——哪些句子值得突出、字幕怎么呈现、封面什么样才满意,这些判断沉淀下来后可复用到后续每一期。视频里展示了实际效果并讲了工作流怎么磨出来。
从字幕校对到挑金句、加包装、做封面全交给 AI,人只负责提要求和把关。做访谈、播客、长视频后期的可以看看这套流程怎么磨出来的。
点击打开原平台查看,能否访问取决于网络环境
05
OpenAI Blog
OpenAI 官博发布客户故事:Pollo AI 使用 GPT-5.6、GPT-6 Astra 和 GPT-Image-2.5,把创意想法转成细节丰富的图像和电影感视频广告。原文只给出这一层描述,做广告片、品牌视觉和电商物料的团队可以关注它把创意到成图的这一段怎么走。
OpenAI 官博的客户故事,讲 Pollo AI 怎么把一句创意变成成图和电影感广告片。做广告片和品牌物料的可以看看它的出片流程。
点击打开原文
06
@openart_ai
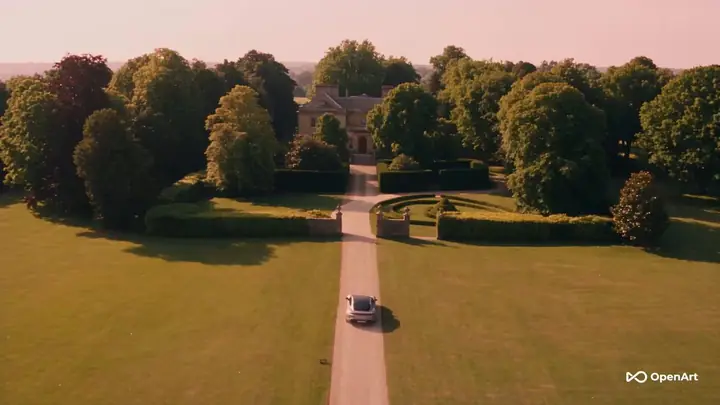
OpenArt 官方发布一份用 OpenArt Director 制作 AI 微短剧的分步指南,覆盖从剧本、角色、场景、分镜到最终成片的完整流程,并以一部真实微短剧作为示例贯穿讲解。指南以 Google Drive 文档形式提供,做 AI 短剧的可以对照自己的制作环节逐段拆解。
从剧本、角色、场景、分镜到成片,OpenArt Director 用一部真实微短剧走完全流程,做 AI 短剧的可以照着这份指南跑一遍。
点击打开原平台查看,能否访问取决于网络环境
07
@aicreataro
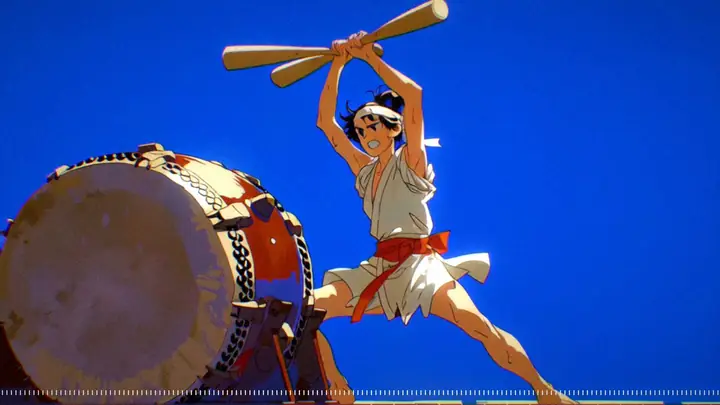
日本创作者 @aicreataro 分享一段实验影像的做法:用 Opus 5.5 写 Python 驱动 Blender,把声音和动作可视化——音量越大画面越立体、越往前景飞,动作越快的地方越会化成粒子浮起,击打瞬间时间冻结、只有镜头环绕,冻结期间整个空间的颜色和照明切换。素材方面人物用 MiniMax H3、主视觉用 Midjourney、音乐用 MiniMax Music 3.0。作者自述的结论是:纯生成做不出的画面,和代码组合起来能做出来,但用力过猛会翻车。
把音量、动作速度直接映射成画面立体度、粒子浮起和镜头环绕,做后期和视觉的可以拆这套音画联动思路,看能不能套进 MV 或片头。
点击打开原平台查看,能否访问取决于网络环境
08
@nicekate8888
用户 @nicekate8888 分享:Grok Bot 默认模型换成 Opus 5.5 后有两个变化——定时任务生成的报告质量更高,且能直接生成《愚公移山》题材动画,配音使用 Gemini 3.8 Flash TTS。属于个人使用体验分享,成片效果和具体生成流程需看原帖视频。
个人实测分享:Grok Bot 默认模型换成 Opus 5.5 后,定时报告质量提升,还能直接出动画,配音用的是 Gemini 3.8 Flash TTS。想试 Agent 出片的可以照着跑一遍。

点击打开原平台查看,能否访问取决于网络环境