01
OpenAI
OpenAI 在 2026 年 10 月更新中官方介绍 GPT-6 Sol 与 GPT-6 Luna 两款模型(该产品 9 月 23 日已发布),同步公开部署安全与系统卡。两者在生物与化学领域被评定为 High capability,GPT-6 Sol 的 Critical capability 评测结果未越过指示性阈值。目前公开信息集中在安全评估层面,未涉及生成能力、上下文长度、价格或 API 开放时间等参数。
OpenAI 一次放出 Sol 和 Luna 两个 GPT-6 型号(该产品 9 月 23 日已发布),此次随附部署安全与系统卡,生物化学领域被评 High capability。做 Agent 和自动化流程的可以盯一下后续 API 开放节奏。
点击打开原文
02
@ViduAI_official
Vidu AI 官方发布下一代旗舰 AI 视频模型 Vidu Q4 Preview,现已上线,官方描述其具备富有表现力的表演、电影般的摄影语言和高冲击力视觉特效,定价低至 0.014 美元/秒。官方同步放出新用户邀请码 VIDUQ4PV1,关注、转发并回复该帖可在 72 小时内通过私信领取 200 Credits。
Vidu 下一代旗舰视频模型上线,官方主打电影感镜头语言和高冲击力特效,价格压到每秒 0.014 美元。做短剧和批量出片的可以拿新用户邀请码先跑几条,看运镜和特效稳不稳。
点击打开原平台查看,能否访问取决于网络环境
03
@satyanadella
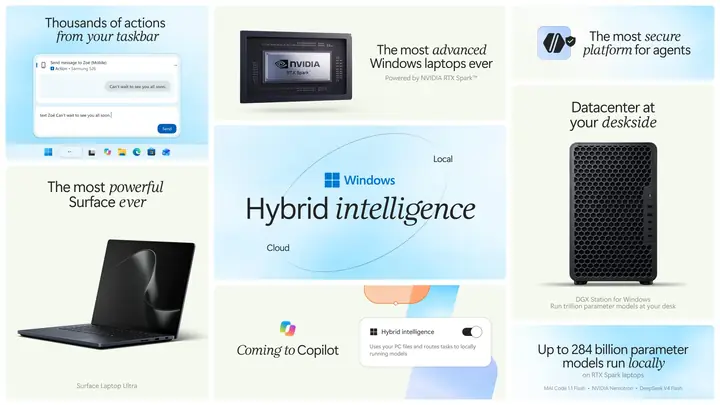
微软在 Windows 上发布一批更新:MAI-Code-1.1 Flash 是 137B 参数、256K 上下文的编程模型,已针对本地 PC 运行优化;GitHub Copilot 可把任务交给本地模型处理以降低成本;Hybrid Intelligence 让 Copilot 直接在 PC 上执行操作、敏感工作留在本机;Code in Copilot 支持在桌面端构建软件、不消耗云端 token;Windows 与 Agent 365 打通,提供 MXC 本地沙箱供 Agent 执行;新设备 Surface Laptop Ultra 搭载 NVIDIA RTX Spark。
微软把 137B 编程模型塞进本地 PC,Copilot 可把活交给本地模型跑、不烧云端 token。做自动化流程的可以留意本地跑 Agent 这条路,纯拍片的这周先路过。
点击打开原文,能否访问取决于网络环境
04
@FishAudio
Fish Audio 发布语音模型 Drama 3 预览版,API 调用名 drama-3-preview。官方称其不只是念台词,而是能按自然语言指令直接调度表演——语气、情绪、节奏、角色都可指定,并支持在一句台词中途切换情绪,无需重录。对配音、AI 短剧和虚拟角色对话团队来说,情绪中途切换这一点直接对应多情绪台词的返工痛点,可接 API 实测出片稳定性。
配音和短剧团队可以试的点:用大白话直接指挥语气、情绪、节奏和角色,还能在一句话中间换情绪不用重录,API 里挂 drama-3-preview 就能跑。
点击打开原平台查看,能否访问取决于网络环境
05
@claudeai
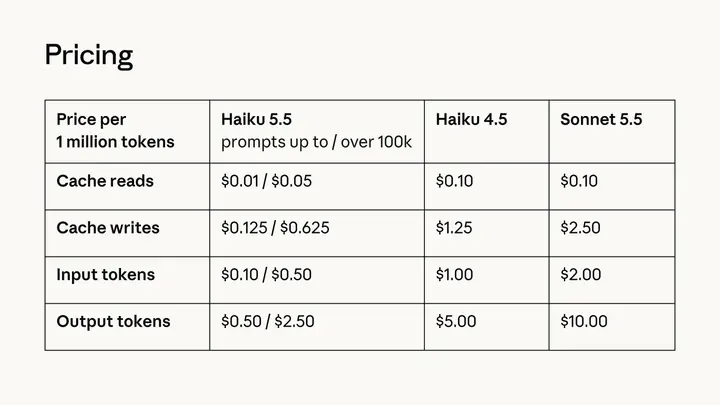
Anthropic 发布 Claude Haiku 5.5,主打 10 万 token 以下任务的低价:输入每百万 token $0.10、输出 $0.50、缓存读取 $0.01;超过 100k 后输入 $0.50、输出 $2.50。对比 Haiku 4.5 的输入 $1.00、输出 $5.00,短任务成本降幅明显。官方称 10 万 token 以下任务约占上一代 Haiku 请求量的九成。
10 万 token 以下输入每百万 $0.10、输出 $0.50,比 Haiku 4.5 便宜十倍,官方说这类请求占上一代九成。批量跑剧本拆解、字幕翻译、素材打标的团队可以换模型算一遍成本。
点击打开原文,能否访问取决于网络环境
06
@krea_ai
Krea 发布 Photoshop 插件,把 Krea 平台上的模型全部接入 PS,官方点名 Nano Banana、Krea 2、GPT IMG 2.5 等。用户在 Photoshop 内即可调用这些模型出图,无需切换到 Krea 网页端。对做视觉开发和后期修图的创作者来说,出图与修图可以在同一个软件里完成,减少素材来回导出的环节。
Krea 把自家全部模型塞进 Photoshop 面板,Nano Banana、Krea 2、GPT IMG 2.5 都能在 PS 里直接调,做视觉和修图的可以装上试一周,省掉来回导图的功夫。
点击打开原平台查看,能否访问取决于网络环境
07
@GoogleAI
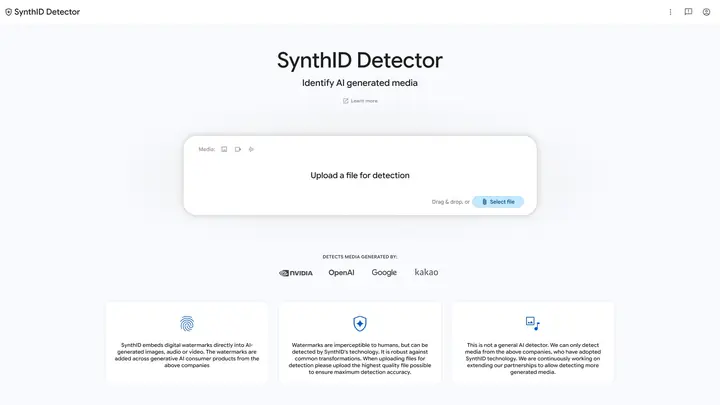
Google 把 SynthID 水印检测能力做成公开门户,任何人可上传图片、视频、音频文件查验是否带 SynthID 水印,覆盖 Google 自家及 OpenAI、英伟达、Kakao 等合作方生成的内容,苹果即将加入。官方称累计已为 1800 亿张图片和视频、超 24 万年时长的音频打上水印,日均处理 100 万次验证请求。该门户与 Search、Gemini App、Chrome 中已有的验证功能并列。
SynthID 检测门户对外开放,任何人上传图片/视频/音频就能查是不是 AI 生成,还接了 OpenAI、英伟达、Kakao 的水印,苹果在路上。做 AI 短剧和商单交付的,可以拿它当交付前的自查工具跑一遍。
点击打开原文,能否访问取决于网络环境
08
@GoogleDeepMind
Google DeepMind 推出 SynthID Detector,可快速识别视频、音频和图像中的 SynthID 水印,即使经过添加滤镜等编辑仍可检测。用户也可使用 Chrome、Google 搜索和 Gemini 应用中已有的 AI 内容识别功能。对做 AI 影像交付的团队来说,这意味着平台侧对 AI 生成内容的溯源能力在加强,交付前需要确认所用模型是否带 SynthID 水印。
做 AI 影像交付的可以留意:SynthID 水印加了滤镜也能查出来,平台侧的内容溯源会越来越严,接商单前先摸清自己用的模型带不带水印。
点击打开原平台查看,能否访问取决于网络环境
09
@gammaapp
Gamma 发布 5.0,官方称是史上最大更新,引擎从底层重做。新增面向视觉叙事的 Agent,可做头脑风暴、调研和编辑;设计上支持描述风格、提供视觉参考或由 Gamma 自动生成风格;编辑支持自由排版、自动排版和对话式修改三种方式。支持高保真导入导出 PowerPoint、PDF 及公司品牌素材并自动匹配,可直连 Slack、Notion、Salesforce 内容生成,也能从 Claude 和 ChatGPT 里创建 gamma。
Gamma 把引擎整个重做,加了会做视觉叙事的 Agent,能描述风格、喂参考图、导入 PPT/PDF 和品牌规范自动对齐。做提案和视觉稿的可以试一轮,看品牌一致性省不省事。
点击打开原平台查看,能否访问取决于网络环境
10
@ybouane
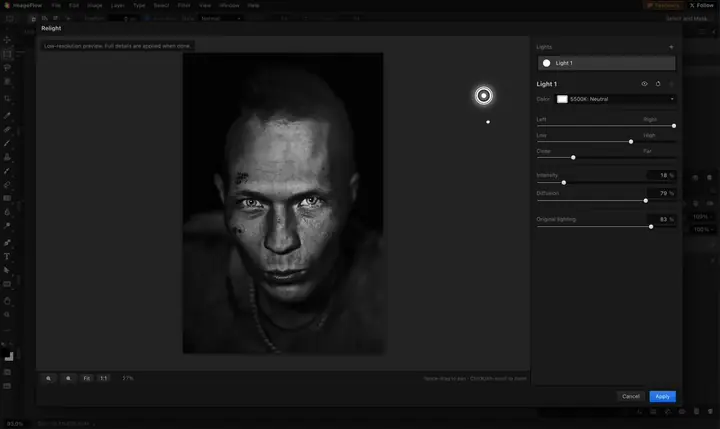
开发者 Yassine Bouanane 发布 ImageFlow 中的 Relight 功能正式版,可直接在浏览器中免费运行,照片不上传服务器、本地完成 AI 打光处理。他对比 Adobe 约一周前发布的 Relight 测试版:后者需订阅加每次渲染 30 个 AI 积分,且要把照片上传到服务器。
Adobe 的 Relight 还在测试收费,这边浏览器里免费跑、照片不上传服务器,做视觉和修图的可以拿自己的素材对比一下效果。
点击打开原平台查看,能否访问取决于网络环境
11
Google AI Blog
Google AI Blog 官方发布 Playground,定位是创建和游玩自定义游戏的平台,原文仅给出「Overview of Playground」一句概述,未展开具体功能、技术方案或使用方式。对做互动叙事、游戏化短内容的创作者来说,这条目前只有产品名和定位,实际能不能用于内容生产要等官方放出更多说明。
Google 官方发布 Playground,主打创建和游玩自定义游戏,但原文只有一句概述,具体能力、是否用 AI 生成、怎么接入都没说,做游戏化内容或互动叙事的可以先收藏等细节。
点击打开原文
01
@nicebabycat
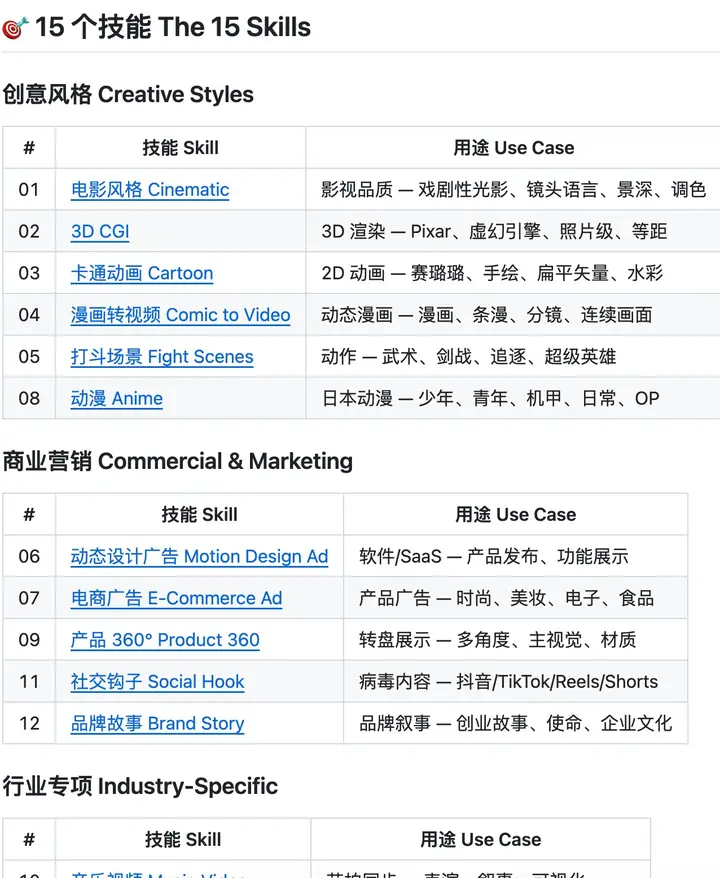
作者开源了一套 Seedance 2.0 提示词技能包,共 15 个,按电影感、3D、动漫、漫画转视频、打斗、电商广告、产品 360°、美食、房地产等风格分类。每个技能包含 10-12 种前 2 秒钩子开场、15 秒以内逐拍时间线、15 种以上运镜的英文写法、灯光/环境音/拟音/配乐写法,以及 @image1 @video1 素材引用用法。用法是把对应 SKILL.md 复制到 Claude 技能目录,一句话描述需求后生成 25 行以上提示词贴进 Seedance,每个技能带中文版。
15 个按风格分好的 Seedance 2.0 提示词技能包,每个都写死了前 2 秒钩子、逐拍时间线和运镜英文写法,做短剧和电商广告的可以直接抄进 Claude 用。
点击打开原文,能否访问取决于网络环境
02
@liyue_ai
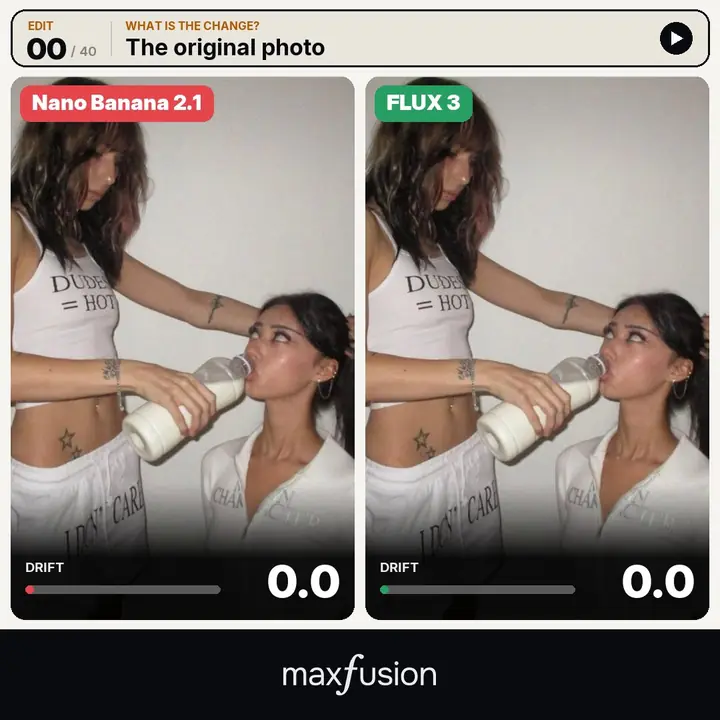
有测试者对 Nano Banana 2.1 与 Flux 3 做了漂移基准对比:两模型从同一张图出发连续编辑 40 次,每次基于上一次结果(如「把背心改成红色」并要求其余不变),并在每张图中选三处 40 次都没被编辑过的背景区域(墙面、天花板、地板)作为对照,量化新图与原图的差异均值(0-255,0 为完全一致,数值越高漂移越重)。结果显示 Nano Banana 2.1 仅第一次略胜 Flux 3,后续几乎完败。做多轮修图和角色一致性的视觉师可参考这套测法。
40 次连续编辑后看背景有没有被偷偷改掉,这种测法比单张出图更接近短剧改镜头的真实场景。做角色一致性和多轮修图的视觉师可以拉这份对照数据,判断哪个模型扛得住反复改。
点击打开原平台查看,能否访问取决于网络环境
03
@jackzhang123vip
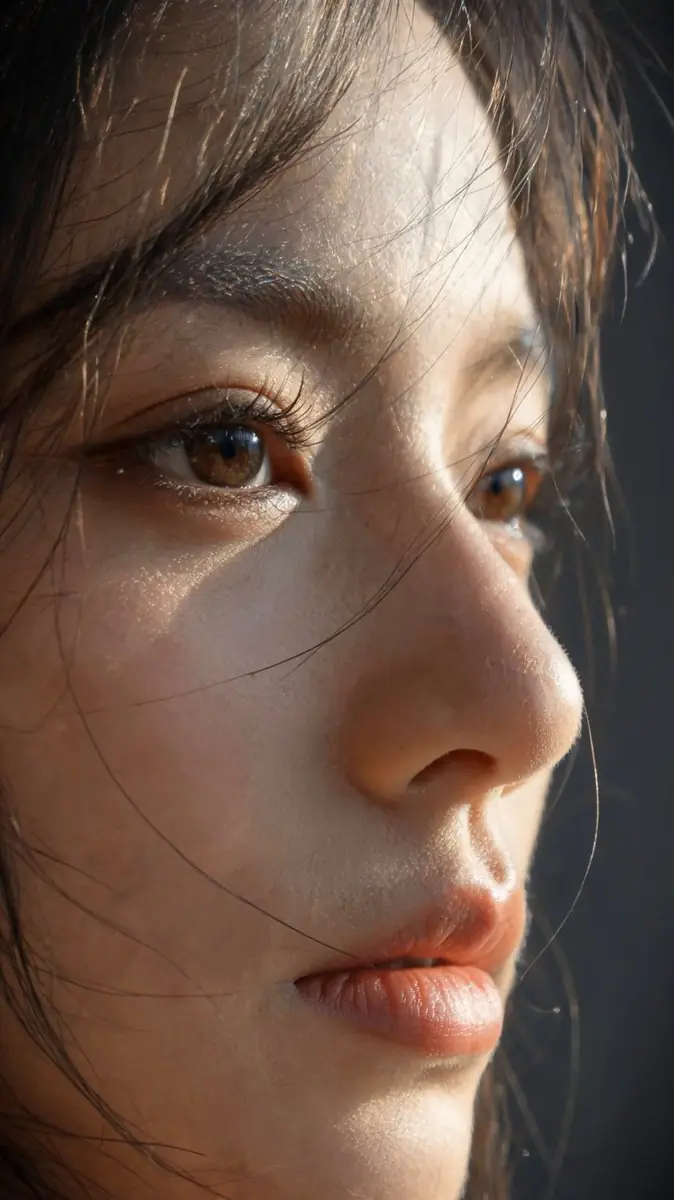
推文给出一段可直接复制的 15 秒 9:16 竖屏 4K 超写实微距人像提示词:24-28 岁东亚女性 3/4 侧脸,强调 RAW 未修饰皮肤(毛孔、绒毛、雀斑、色素差异、油脂高光、唇纹),侧前方强暖光穿透虹膜形成琥珀色,背景近纯黑,85-105mm 微距镜头、机位距离 15-25cm、2%-4% 呼吸漂移,并附 0-3/3-6/6-9/9-12/12-15 秒的眼神与眼皮动作时间线。
一条可直接复制的 15 秒竖屏微距人像提示词,把绒毛、毛孔、油脂高光和 0-15 秒眼神动作拆成时间线,做数字人和特写镜头的视觉师可以存下来改参数。
点击打开原平台查看,能否访问取决于网络环境
04
@liyue_ai
作者李岳(@liyue_ai)用 Grok Bot 为自己的开源项目 female-portrait-director 制作了一支宣传 Motion Video,全程只发了一段提示词:附上 GitHub 项目链接,要求「做一个比较炫酷的 Motion Video,发挥创意把视频做好一点」。成片一刀未剪,作者称音效、布局、场景切换都符合预期,中间不同写真风格展示的特效是亮点。据作者转述,马斯克当天下午提到 Grok Bot 使用最强的后端模型。
作者只丢了一句提示词加一个 GitHub 项目链接,Grok Bot 就出了带音效、场景切换和写真风格特效的成片。做工具宣传片和 Motion Video 的可以看看这个提示词写法。
点击打开原平台查看,能否访问取决于网络环境
05
@OpenAIDevs
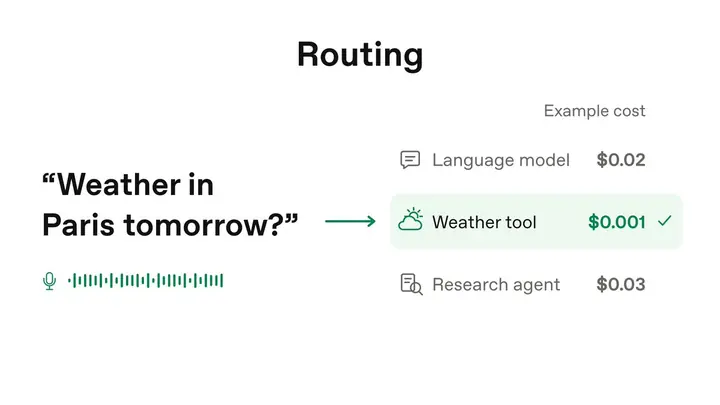
OpenAI Developers 官方列出 Decisions API 的六类开发者用例:把请求路由到正确的模型、工具或智能体;把规模化输入转成标签、排名和分数;分析图像、比较视觉内容或识别关键视频帧;从截图中选择按钮、导航表单或确定操作;标记有风险的工具调用;对大型数据集分类以发现趋势。其中「识别关键视频帧」和「比较视觉内容」与素材筛选、批量打标场景直接相关。
OpenAI 官方把 Decisions API 的六类用法摊开讲:模型路由、批量打标打分、识别关键视频帧、截图里选按钮、标记风险工具调用。做自动化剪辑和批量素材处理的可以对着这几条看哪条能接进自己的流程。
点击打开原平台查看,能否访问取决于网络环境
06
@aicreataro
作者让 Opus 5.5 写 HTML/Three.js 完成文字排版与运动,旁白用 Gemini TTS,风声和敲门声用 ffmpeg 合成,全程未使用视频生成 AI,产出短片《冻结的手记》。作者反馈 Gemini TTS 旁白演技自然、听感舒适,文字动画相比视频生成不会崩字、修改快、数据体积小。
不用视频生成模型,靠 Opus 5.5 写 HTML/Three.js 做文字排版与运动,配 Gemini TTS 旁白和 ffmpeg 音效合成成片。做后期和动态字幕的可以看这条换条思路。
点击打开原平台查看,能否访问取决于网络环境
07
@arena
Arena 对 Mistral Large 4 做了实测(该产品 10 月 7 日已发布),该模型总参数 1T、激活 49B,开放权重预计月底放出。评测把它与 GPT-6.1 Sol、Astra、Claude Fable、Claude Opus 5.5、Claude Sonnet 5.5、Kimi K3、GLM 5.3 Flash、DeepSeek Flash、Muse Spark 等专有及开源模型做了真实场景对比,后续还会补充分数与更新。属于文本模型能力评测,不涉及图像、视频、音频的生成或编辑。
当天有 4 家独立信源在报同一件事,属于行业动向本身。对具体创作流程没有直接用处,但这个量级的消息值得知道。