01
@binghe
博主实测 Seed Audio 1.0 配音模型:对比传统 TTS,情绪维度更广、精度更细,可匹配动态情绪;无需音色克隆,上传 15 秒左右 MP3 参考音频即可复刻音色;支持指定输出时长、语速和停顿,方便后期对轨;覆盖 20 种语言,能演绎边吃饭边讲话这类人物状态,提示词还可对音效和配乐做设计。作者建议多角色时提供角色介绍(最多 3 个参考音频)、背景说明、性格讲话方式与含时间轴、状态、台词的台词分配,但不建议在配音里加音效以免影响对轨和音质。适用广告、短视频、有声小说、漫剧、ASMR、带货等场景。
15 秒参考音频就能复刻音色,还能指定时长、语速和停顿方便对轨,做配音和有声内容的可以拿一段台词跑一遍,看情绪和停顿能不能接上画面。
点击打开原文,能否访问取决于网络环境
02
@ponyodong
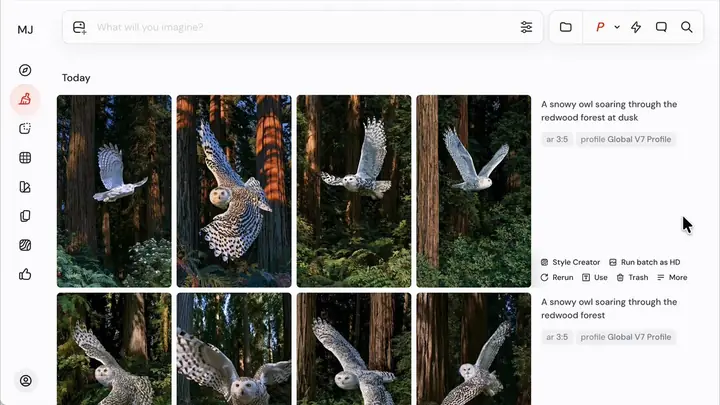
作者实测 Midjourney 最新 Edit Model 的角色一致性,称不用繁琐调参即可固定角色并微调细节。核心步骤:Imagine 栏上传参考图后点小锁固定,最多支持 4 张多角度图;用自然语言直接下指令改表情或切换正背面视角;把多个角色合成到同一张参考图再喂给模型以避免属性混淆;配合 Editor 的局部重绘与扩图调整服装细节和镜头视角。作者称画风和脸型保持稳定,适合长剧本角色建模。
官方演示被拆成四步:锁参考图、大白话改表情视角、多角色合成一张图、配合局部重绘扩图。做短剧和 IP 连载的可以照着跑一遍,看脸型稳不稳。
点击打开原平台查看,能否访问取决于网络环境
03
@maxescu
作者公开了一支 MV 的完整制作分工:歌曲、视频、剪辑、动效、调色全部由 AI 完成,人只负责创意、素材筛选和美术方向。工具链包括 Claude Opus 5.5 Max、Higgsfield MCP、ElevenMusic v2.5、Seedance 2.5、Nano Banana Pro、GPT Image 2.5,后期用到 Demucs 分轨、Whisper large-v3 转写、torchaudio 强制对齐、MediaPipe 面部关键点、BiRefNet 抠像和 FFmpeg,总成本约 240 美元。作者自述已知问题为少量跳帧,口型同步完成度约 99%。
从词曲、剪辑、动效到调色全交给 AI,人只负责创意和美术方向,总成本约 240 美元。做 MV 和短剧后期的可以照着这份工具清单拆一遍自己的流程。
点击打开原平台查看,能否访问取决于网络环境
04
B站「AI 短片/短剧/视频」搜索
B 站 UP 主从成本、速度、质量三个维度对比 AI 视频的云端与本地部署两条路线,本地实测在华硕 ExpertCenter Pro ET900A X9 工作站上完成,搭载 RTX PRO 5000 双卡、144GB 显存 + 128GB 内存,并行出片一小时可生成近百条 720P 视频。视频给出模型天梯图与成本对比(同一条视频云端约 100 元、本地约 0.8 元)。做 AI 短剧和批量出片的团队可据此评估自建算力与云端调用的取舍。
同一条 AI 视频云端 100 块、本地 8 毛,这期把两条路线的成本、速度、质量摆在一起算账,做短剧和批量出片的团队可以拿它当采购决策参考。
点击打开原平台查看
05
@TanLuAI
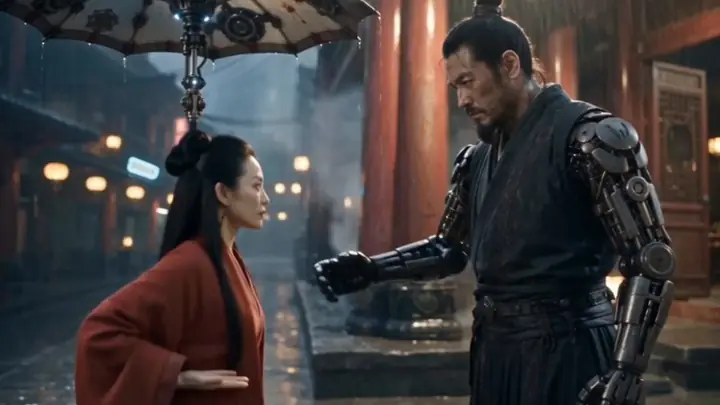
作者用 Seedance 2.5 生成「灵魂出窍掌」初始视频,再用 GPT 抽帧、逐帧替换角色造型(现代老师、古代皇帝、原始野人等多元宇宙变体)、按时间线合成导出,最后人工把变体段与原始视频在轨道上拼接。关键参数:每三帧换一张图,帧数越少变体越多但额度消耗越大;共生成约 29 张替换图,抽帧加生图加剪辑整体消耗 Plus 会员 5 小时额度的 50% 以内,Seedance 部分走每日免费额度。作者还给出抽帧指令、细节纠错指令(如统一去掉多余发型)等可复用 prompt。
一条能直接抄的后期玩法:Seedance 出主体视频,GPT 抽帧换体再拼回时间线,29 张替换图只吃掉 Plus 会员一半额度。做特效向短片和短剧打斗段的后期可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
06
@cocomonkey_ai
创作者 @cocomonkey_ai 分享用 Opus 5.5 加 muse 制作 2 分钟短片《人类三十万年压缩成一天》的工作流:不再让 Claude 控 Codex 再控 muse 套壳,改为 Claude 直接控制 muse 脚本、剪辑全由 Claude 审核,Codex 可并行做审核加速;muse 内部可先自查一遍提升准确度。全程无需人工干预,比套壳更省时间省 token,作者本机并行跑了三个视频任务。
把 muse 当工作流而不是对话框,Claude 直接控脚本和剪辑、自己审片,一句话丢进去睡觉,醒来收成片。做短剧批量生产的可以照这套改自己的流程。
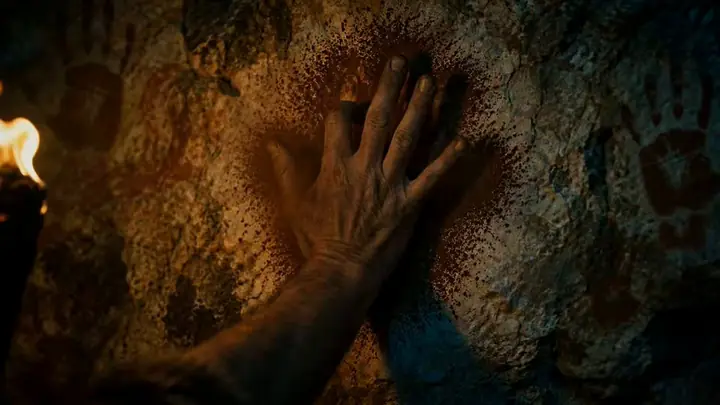
点击打开原平台查看,能否访问取决于网络环境
07
@Tomw852
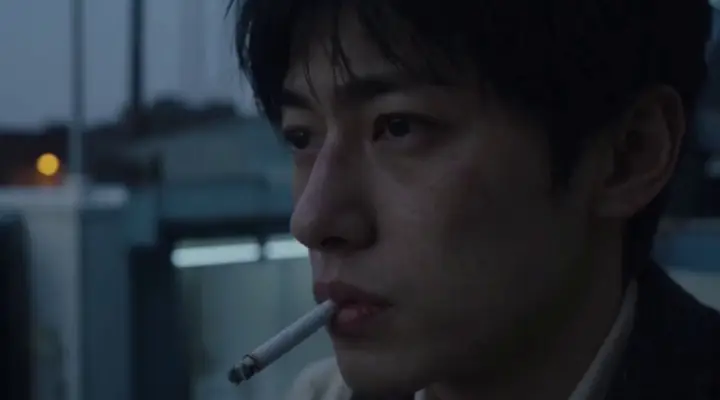
作者 @Tomw852 用 MiniMax H3 在 RTX 5070(12GB 显存)上通过 ComfyUI 本地生成了一支 15 秒电影感短片《一支烟的时光》,并公开了所用模型、LoRA 和提示词。对想压低算力成本的创作者来说,这条验证了消费级显卡本地跑视频生成模型的可行性,配置和提示词可直接复用。
12GB 显存消费级显卡本地跑 MiniMax H3 出片,作者附了模型、LoRA 和提示词,想省云端算力的可以照这套配置试一遍。
点击打开原平台查看,能否访问取决于网络环境
08
@magnific
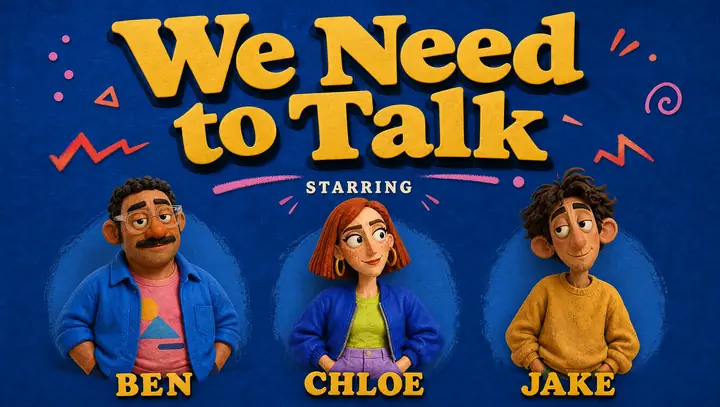
Magnific 团队分享用 Ideogram 4.5 生成片尾字幕卡的做法:以角色图作为参考图,让模型按 1990 年代情景喜剧的片尾演职员表风格出图,输出为 16:9 全屏构图。公开的 prompt 里明确区分了参考图用途——参考图 1 只用于字体和氛围,不参与角色生成。适合需要批量产出片尾卡、角色介绍页的系列化内容。
片尾字幕卡这种收尾物料以前得美术单独排,这里用角色图当参考、拿一张老剧字幕当排版风格参考就出了。做短剧和系列片的可以把这个 prompt 结构存下来,套自己的角色试。
点击打开原文,能否访问取决于网络环境
09
@TanLuAI
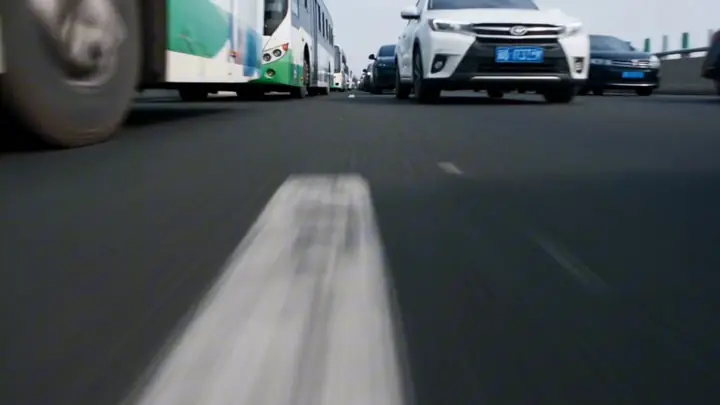
博主「探路AI」公开一段 30 秒、16:9 横屏、60fps 超写实真人动作视频的完整提示词:一镜到底长镜头,开场贴高速公路路面追拍拥堵车流,两秒内抬镜揭示戴粉色猪猪头盔的青衣女子空中直立飞行,随后并行拍面部特写、两指手势让头盔消失、加速飞往黄山景区,掠过游客、穿过桥洞、贴悬崖飞行。提示词分「人物与御剑飞行动作」「头盔」「0—2秒贴路追拍」等段落,明确要求锁定参考图的脸、五官比例、额间花纹、半束长发与浅灰绿交领长袍,全程同一张脸同一套衣服,右手始终握实体长剑、不踩剑不趴飞,衣袍发带被气流向后吹起且有重量和延迟摆动,头盔只消失一次、不爆炸不碎裂。开头还附了一句强制指令:不要拆解参数,直接按完整提示词生成,别再确认,直接生成。
一条可直接抄的 30 秒一镜到底提示词,把贴路追拍、面部慢动作、加速甩镜和仙侠御剑两段参考动作缝进同一个长镜头,做 AI 短片和仙侠题材的可以拿去跑一遍看镜头衔接稳不稳。
点击打开原平台查看,能否访问取决于网络环境
10
@TanLuAI
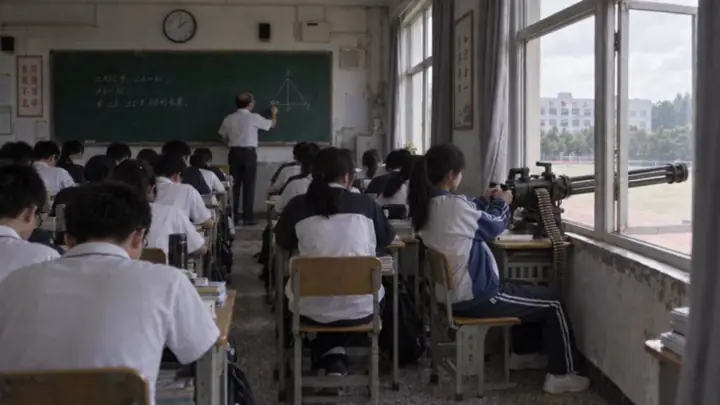
探路AI(@TanLuAI)分享「上课别玩手机系列-加特林版」的生成提示词:15 秒、16:9 横屏、真人实拍质感、一镜到底,作者建议换成其他版本复用。他提到这类玩法在国内短视频平台已经很多,自己更偏好写实风格的反差版本。做短视频和短剧的可以拿这套提示词模板换题材批量套用。
15 秒横屏一镜到底的写实反差玩法,作者把提示词直接放出来了,做短视频和短剧的可以拿这套模板换题材批量套。
点击打开原平台查看,能否访问取决于网络环境