01
@eternityspring
针对 MiniMax H3 单次最多生成 15 秒、短剧分段拼接易突兀的问题,作者推荐 ComfyUI-H3-Motion-Context 方案,项目内含可直接用的工作流示例。做法是把上一段最后 22 帧(0.92 秒)原样钉在下一段开头,采样时不动这些帧,让模型看到真实运动而非从静态图猜;画面和声音直接从上一段 latent 切出,避免反复解码编码掉画质;生成后用 Trim 节点剪掉开头 22 帧再首尾拼接,无需转场。提示词上下一段开头要先复述上一段的结束状态,同角色同景别同动作保持一两秒再推进新剧情。
做 AI 短剧的可以照这个思路跑一遍:把上一段最后 22 帧钉在下一段开头,接缝处姿势表情都对得上,不用做转场。
点击打开原平台查看,能否访问取决于网络环境
02
@Promptwhat
韩国创作者分享的工作流:用 Seedance 2.5 一次生成 30 秒说话视频,再把视频和动作参考交给 Claude Code 完成剪辑与特效——人身后经过的大字、随单词弹出的卡片、自动打字的输入框全部由代码生成,无需 After Effects。整体耗时约一小时,大部分时间花在等待生成和渲染。模板搭好后,后续只需更换主题即可复用,作者称已能实现较高质量的视频自动化,并已取消 CapCut 付费订阅。
把说话视频和动作参考丢给 Claude Code,大字、弹卡、打字机输入框全用代码画出来,不用碰 AE。做口播和短剧后期的可以照着这套跑一遍,模板搭好后换主题就能复用。
点击打开原平台查看,能否访问取决于网络环境
03
@buraktuyan
创作者 Burak Tuyan 为 Eleven v4 制作了一支 44 秒规格广告,做法是先写一份「AI 语音不能做的一切」脚本,再让 Eleven v4 朗读出来,用反向命题检验语音模型的语气、情绪和表现力边界。做配音、有声书、AI 短剧对白的后期和声音团队可以听成片判断这套语音能不能直接进棚。
作者写了一份「AI 语音做不到的事」清单让 Eleven v4 念出来,用反向命题测语音模型的情绪和语气边界,做配音和有声内容的可以听一遍判断能不能进棚。
点击打开原平台查看,能否访问取决于网络环境
04
@dotey
宝玉(@dotey)公开了一条用 Opus 5.5 做吃瓜视频的完整 Prompt,覆盖素材搜集(X、YouTube、新闻,可借 yt-dlp 下载)、9:16 竖版 4–6 分钟中英双版本、Gemini 3.8 Flash TTS 配音、BGM 随旁白自动压低、右上角水印、首帧封面、推文原文卡片叠加、字幕整句不截断,以及交付前用 STT 回听旁白、抽帧检查、查重复镜头。Prompt 还支持去敏版(旁白、字幕、截图、画面均不出现相关人名)。
一条完整可抄的 Prompt:从找素材、配画面到 TTS 配音、抽帧自检全交给 Opus 5.5,做资讯类短视频和短剧的可以照着改话题跑一遍。
点击打开原平台查看,能否访问取决于网络环境
05
@PJaccetturo
创作者 PJ Ace(@PJaccetturo)称一套 Blender 工作流改变了他们的电影制作方式,团队此前无人用过 Blender,整个流程由 Claude 跑通,并预告将免费公开完整的 3D 与 Dreamina 工作流。推文本身只有这段结论和放料预告,具体步骤、参数和成片效果需看后续线程。
团队没人用过 Blender,靠 Claude 跑通全流程做出片子,作者说要把 3D 加 Dreamina 的完整工作流免费放出来。做 AI 影像和 3D 结合的可以蹲这条线程。
点击打开原平台查看,能否访问取决于网络环境
06
@karpathy
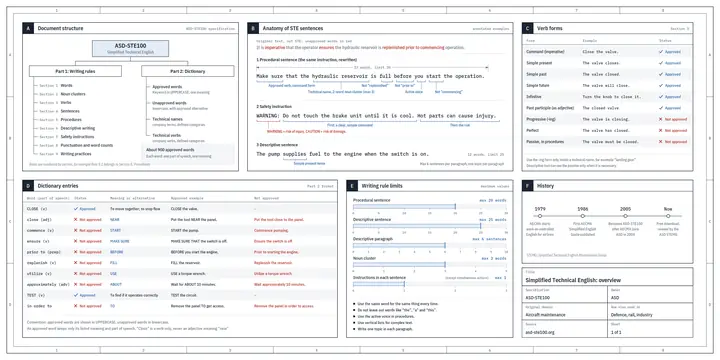
Karpathy 提出理解语言模型输出的递进方法:一是让模型用 ASD-STE100(原为航空维修文档开发的受控语言规范)重写内容,约束强、可读性高,也可要求「80% 接近该规范」;二是让模型画图代替文字;三是要求输出 HTML 得到可交互网页;四是他最看好的方向——按任意主题生成定制讲解视频,示例 prompt 为「Create a 3b1b style video explainer on X. Use my ElevenLabs API key for audio narration」,配音可接 ElevenLabs API 或用本地算力的免费替代。
Karpathy 给了条具体路径:让模型用 ASD-STE100 受控语言重写、出图、出 HTML 网页、最后直接生成 3b1b 风格讲解视频。做 AI 讲解片和知识类内容的可以照这个顺序试一遍。
点击打开原文,能否访问取决于网络环境
07
@magnific
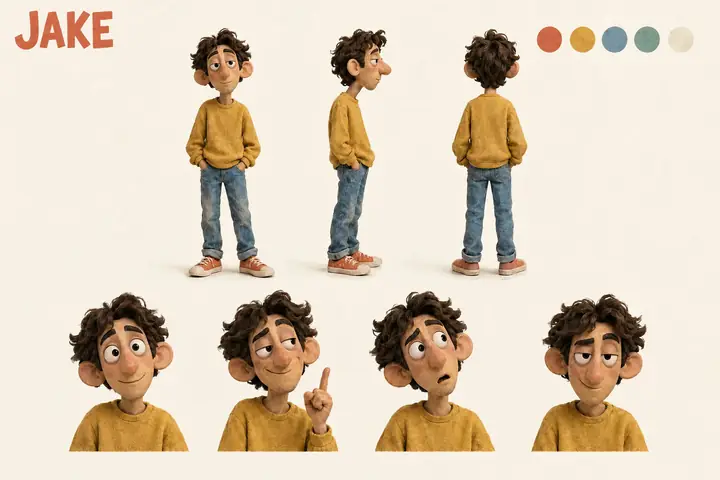
Magnific 官方账号展示用 Ideogram 4.5 生成三个角色 Chloe、Ben、Jake 的 character sheets,覆盖服装、表情和不同角度的视图,prompt 放在推文的 ALT 文本里。核心卖点是同一角色可以反复调用、保持统一外观。做 AI 短剧和系列内容的视觉师可以拿这套设定表流程测试角色一致性,看跨镜头复用稳不稳。
角色设定表是 AI 短剧和系列片最头疼的一环,这条给了用 Ideogram 4.5 定义服装、表情、多角度视图的具体做法,做角色一致性的视觉师可以照着跑一遍。
点击打开原文,能否访问取决于网络环境
08
Luma AI Blog
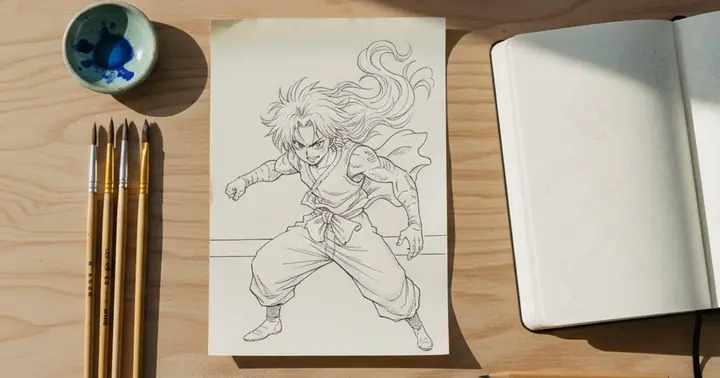
Luma AI 博客发布 2026 年 AI 动漫视频生成工具盘点,覆盖 11 款工具,核心结论是动漫 AI 工作流应从静帧起步再动画,而非直接文生视频。文中点名 Seedance 2.5 单次生成支持最多 9 张参考图以维持视觉一致性,WAN 2.7 在赛璐璐上色还原度上表现突出且开源,Kling AI V3 擅长动作序列的流畅运动与打斗调度,Krea 等平台提供含多模型访问的免费额度。角色一致性被列为当前首要难题。
把 11 款动漫视频工具按「先出静帧再动画」的工作流排了一遍,点名 Seedance 2.5 支持 9 张参考图保角色一致性、WAN 2.7 赛璐璐质感、Kling V3 打斗运镜。做动漫短剧和番剧向内容的可以当选型清单过一遍。
点击打开原文
09
@mrjonfinger
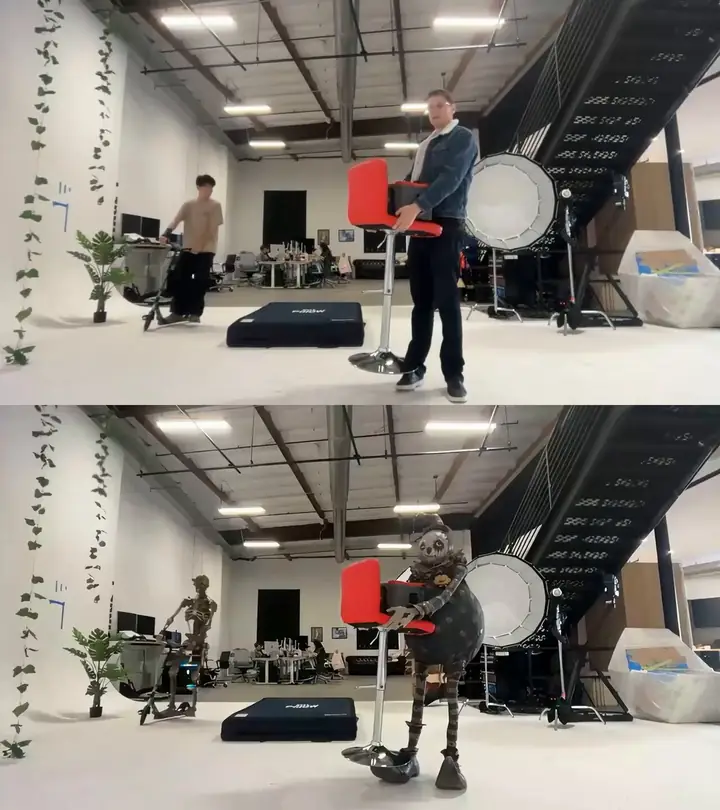
创作者 Jon Finger(@mrjonfinger)称自己搭了一套系统,电脑或手机可自动捕获画面并用选定角色做 v2v(视频转视频),全程无需手动写提示词或反复重roll,并称运行可靠性让他意外。推文未说明所用模型、工具或具体搭建方式,仅表达「多玩少提示」的创作取向。
个人创作者自建的 v2v 自动化流程,电脑手机都能自动抓取画面套用选定角色,不用反复写提示词重roll。做角色一致性和批量换脸的可以问问他怎么搭的。
点击打开原平台查看,能否访问取决于网络环境
10
@ciguleva
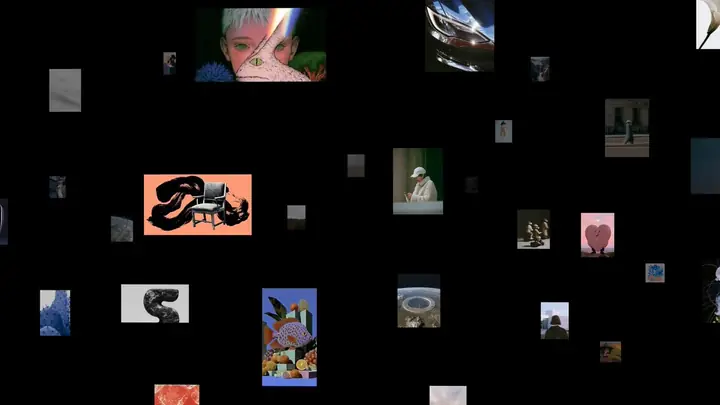
作者公开了一条音乐可视化短片的完整工具清单:图像用 Midjourney,音乐用 Suno 并通过 librosa 做节拍同步;第一部分「图像在太空中飞翔」用 three.js + WebGL,经 Playwright 在无头 Chromium 里以 4K 渲染;第二部分「节拍切割窗口和马赛克」用 NumPy + Pillow 写的自定义 Python 合成器;最后用 ffmpeg 编码。
一条把 MJ 出图、Suno 配乐、librosa 卡点、three.js 4K 渲染串起来的完整技术清单,做音乐可视化 MV 和后期合成的可以照着搭一遍。
点击打开原平台查看,能否访问取决于网络环境