01
@bfl_ai
Black Forest Labs 介绍 FLUX 3 Image(该产品 7 月 24 日已发布),主打像素级控制:多轮编辑只改指定区域、其余像素不动,可用 bounding box 精确排布画面元素,最高生成 4K 保留细节,最多支持 10 张参考图合成一张图。面向大规模图像生成的公司提供商业权重,开源权重版本将在未来几周内推出。
像素级多轮编辑不串味、bounding box 摆位、最多 10 张参考图合成,做视觉开发和 KV 的这周就该上手试,看角色一致性和改图精度到底稳不稳。
点击打开原平台查看,能否访问取决于网络环境
02
@tavus
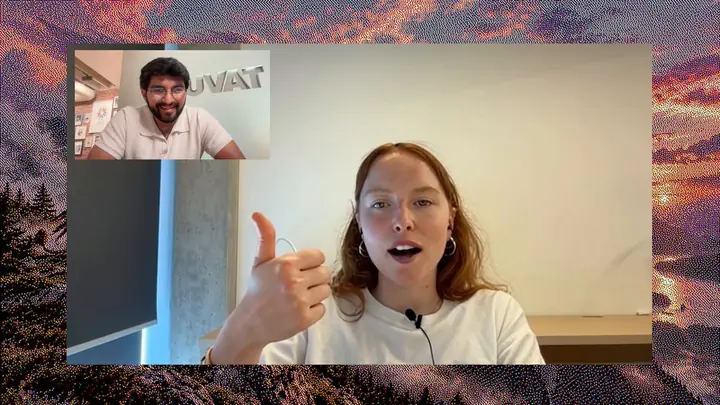
Tavus 发布 Griffin,称其为首个通过视频图灵测试的模型:48% 与其实时对话的人认为它是真人,此前系统通过率低于 3%,并在 NVIDIA 全双工 AI 视频基准测试中排名第一。官方将其定义为「人类交互模型」(HIM)。
48% 的实时对话者以为对面是真人,此前系统通过率不到 3%,还拿了 NVIDIA 全双工视频基准第一。做数字人、虚拟角色对话和 AI 主持的可以盯一下这个「人类交互模型」的实时表现。
点击打开原平台查看,能否访问取决于网络环境
03
@fal
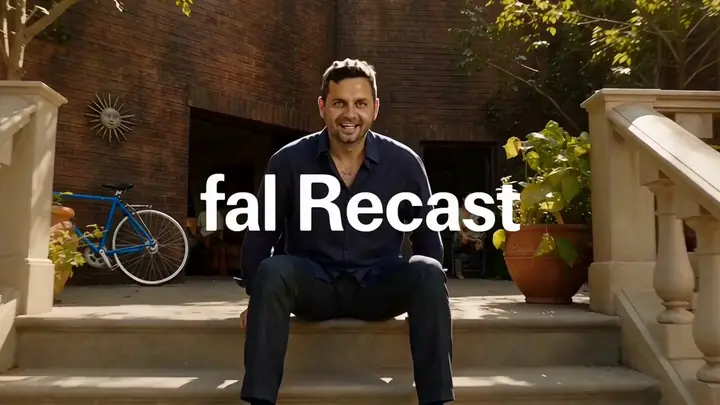
fal 发布 fal Recast,上传现有视频加新角色参考照片,即可替换画面中的人物,同时保留原始动作、摄影机运动、剪辑和音频。官方称由 H3 Max 驱动,该模型在整体质量、提示词理解和美学上对标主流视频模型。可用于生成角色变体、针对不同受众调整同一支广告,无需重新拍摄。
上传原片加一张新角色参考图,动作、运镜、剪辑、音频全保留,只换人。做短剧和广告的可以拿旧素材试一遍,看换脸后的一致性稳不稳。
点击打开原平台查看,能否访问取决于网络环境
04
Luma AI Blog
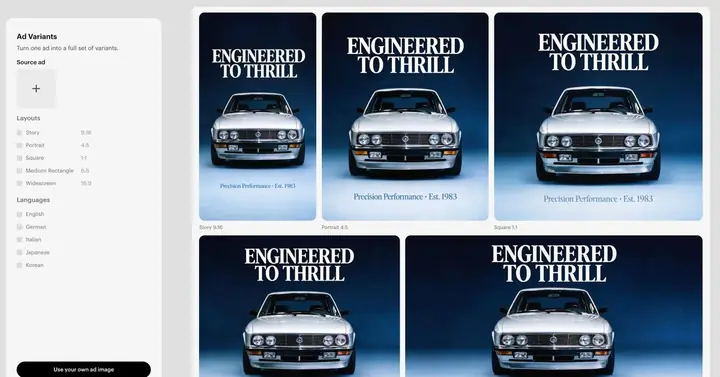
Luma 上线 Variants 功能,任何 Luma 用户上传一张已过审的静态广告,选定版式与语言后,系统自动生成全部版本,Logo、标题和 CTA 保持原样,版式与文案按各投放位和地区自动适配。对做品牌 KV 和投放素材的团队来说,一张主视觉就能铺出多尺寸多语言版本,省掉逐版重排的人工。
上传一张过审的静态广告,选好尺寸和语言,Variants 自动把版式和文案适配到各个投放位,Logo、标题、CTA 保持不变。做品牌物料和投放素材的团队可以拿现有 KV 跑一遍,看多语言多版式的出图质量。
点击打开原文
05
@MicrosoftAI
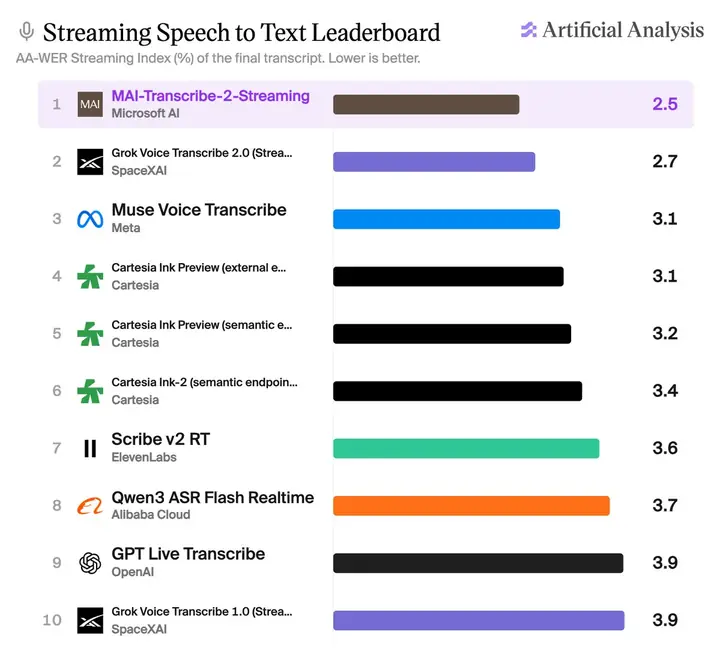
微软 AI 发布三款新模型:MAI-Transcribe-2-Streaming 主打准确的流式转录,MAI-Voice-2.1 与 MAI-Voice-2.1-Flash 主打自然语音表达和更短的对话轮次等待时间,官方定位是构建持续对话的语音代理。做配音、虚拟角色对话、实时字幕和语音交互类内容的团队可关注其流式转录与低延迟表现。
微软一口气放出流式转录加两档语音模型,主打对话轮次等待更短,做 AI 配音、虚拟角色对话和实时字幕的可以接 API 测一轮延迟。
点击打开原平台查看,能否访问取决于网络环境
06
@mustafasuleyman
Mustafa Suleyman 宣布推出实时转录模型,称其为全球最准确的实时转录模型,比 ElevenLabs 快 55%、便宜 60%,并邀请开发者在其平台上构建代理。Satya Nadella 转发了该推文。对做配音、实时字幕、虚拟角色对话的后期和短剧团队来说,速度和成本是这条最直接的两个数字,可接 API 实测延迟与准确率。
实时转录比 ElevenLabs 快 55%、便宜 60%,做 AI 配音、实时字幕、虚拟角色对话的可以接 API 跑一周,看延迟和准确率能不能顶住现场收音。
点击打开原平台查看,能否访问取决于网络环境
07
@willyhopps
Will Hoppin 发布一款胶片仿真工具,称基于真实胶片建模了 126 种胶片 stock,支持 ARRI、Sony、Canon、RED 等机型,可直接在浏览器、osmo_studio、DaVinci Resolve 和 Premiere 中运行,免费发布。做后期调色和视觉的可以拿它对比现有胶片 LUT,看物理精确度是否够用。
126 种基于真实胶片建模的仿真工具免费放出,能直接在达芬奇、Premiere 和浏览器里跑,做后期调色的可以装起来试,看胶片质感还原到什么程度。
点击打开原平台查看,能否访问取决于网络环境
08
@runwayml_labs
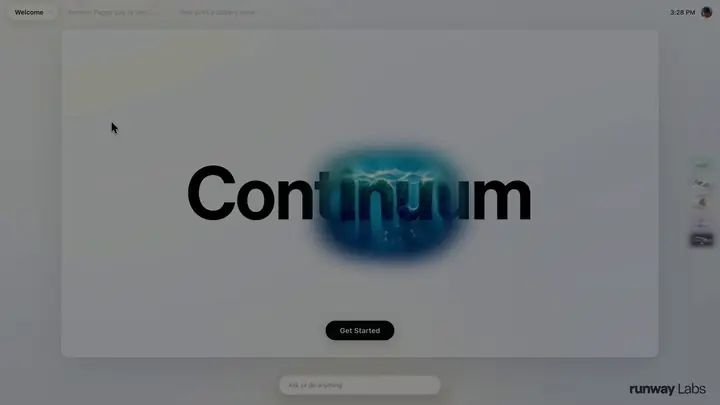
Runway Labs 发布 Project Continuum,官方定位为「围绕实时视频界面构建的新型操作系统研究应用」,随附一段简短的演示走查(demo walkthrough)。原文仅给出这一句产品定位和演示链接,对做实时影像交互、虚拟界面和视觉实验的创作者来说,这是一个值得先看演示、判断视频界面能否替代传统 UI 的方向性信号。
Runway 实验室把操作系统做成了实时视频界面,官方只放了一句介绍加一段演示走查,做交互影像和实时视觉的可以点开看它到底怎么跑。
点击打开原平台查看,能否访问取决于网络环境
09
@MeshyAI
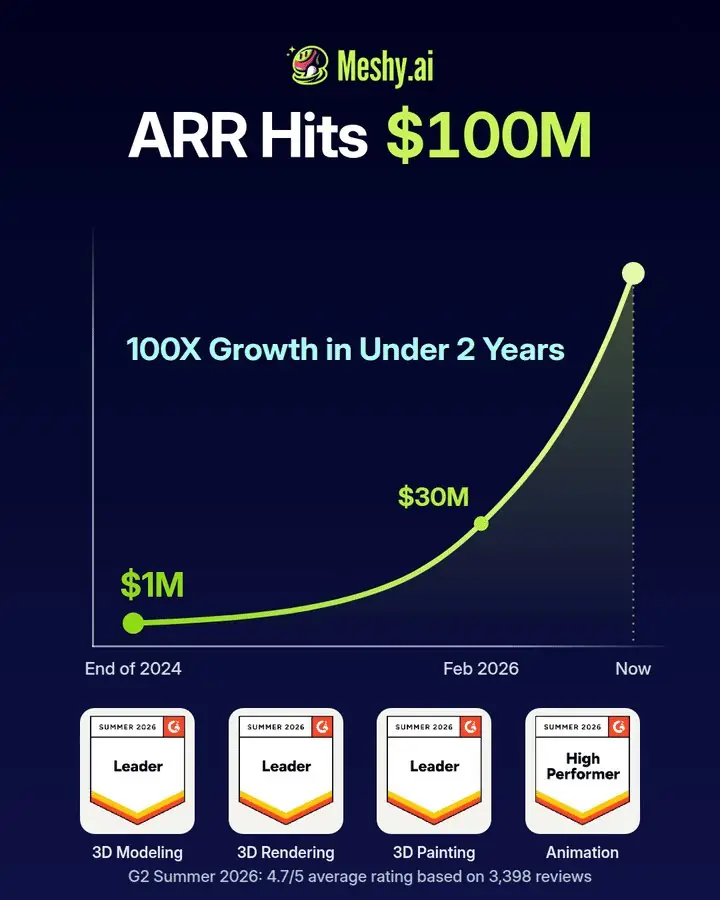
Meshy 官方宣布 ARR 突破 1 亿美元,从 2024 年底的 100 万美元增长至今,不到两年增长 100 倍。官方将成绩归功于创作者、开发者和工作室社区的使用以及全球团队执行。这是 3D 生成赛道目前公开的最高营收数字之一,反映 AI 3D 资产工具在游戏、影视美术环节的商业化速度。
3D 生成工具 Meshy 从 2024 年底 100 万美元 ARR 做到 1 亿,两年 100 倍。做 3D 资产、游戏美术和虚拟场景的可以留意这家还在不在你的工具清单里。
点击打开原平台查看,能否访问取决于网络环境
01
@maxescu
创作者 Alex Patrascu 给 Claude Opus 5.5 一条提示词和 Higgsfield 的预算,8 小时 21 分钟后产出一部 8 分钟纪录片。过程中它研究 28 个来源、选定人物面部与声音、拍摄 96 个镜头,并完成剪辑、配乐、混音和事实核查。推文附成片与工作流说明。
一条提示词加预算,8 小时跑完调研、选角、96 个镜头拍摄到剪辑配乐全流程,做 AI 长片和短剧的可以拆解这套自动化工作流。
点击打开原平台查看,能否访问取决于网络环境
02
@Saccc_c
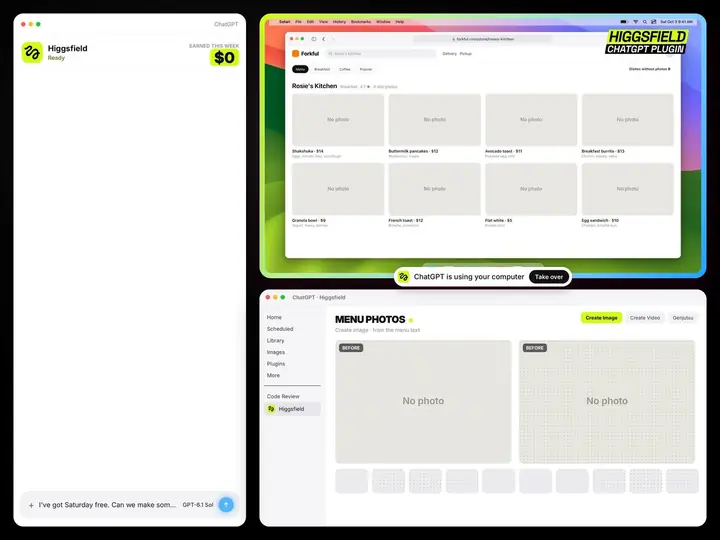
作者演示 Codex 通过最新扩展接入 Computer Use,由 GPT-6.1 Sol 驱动,可操作完整 Higgsfield 界面,把创意、生图、视频生成、修改串成一套流程,并支持读取本地素材后继续编辑迭代。案例中 Codex 自动搜索到三家咖啡店菜单缺菜品图,操作 Higgsfield 生成展示图和宣传短视频,再发邮件推销,赚了 450 美元。
Codex 的 Computer Use 扩展直接操作 Higgsfield 界面,从创意、生图到视频抽卡一条龙,还能读本地素材接着改。做批量出图和短视频的可以照这个思路搭一套,省掉反复切页面的功夫。
点击打开原平台查看,能否访问取决于网络环境
03
Runway Blog
法国蘑菇与植物基适应原饮料品牌 Bonjour 靠付费社交投放增长,15 人创意小组负责 Meta 上所有脚本、分镜和成片。此前想试新视觉风格必须外包动画师,受排期和报价限制,且不知道成片是否有效。接入 Runway 后,每个新概念都做成多种动画风格,用真实投放预算逐一测试,从脚本到结论的周期为 4-5 天。创意负责人 Clément Schuffenecker 称,旧流程让团队无法承担频繁试错。
法国功能饮料品牌 Bonjour 的 15 人创意小组,用 Runway 把一份脚本同时做成多种动画风格投 Meta 测试,从脚本到结论压到 4-5 天,以前得外包给自由职业者。做投放素材和短剧批量出片的制片可以看这套测试流程。
04
@magnific
Magnific 分享一个修视频穿帮的做法:视频模型把某场戏里角色的 T 恤画错了,团队把那一帧抽出来,用 Ideogram 4.5 编辑修正,再拿这张改好的图当参考重新生成该片段。推文附了完整 prompt,指定只改画面最左侧戴眼镜、穿敞口蓝色外衬衫的男子 Ben,并带了一个参考图链接。
视频模型把角色 T 恤画错,抽帧用 Ideogram 4.5 改好再拿参考图重生成片段,附了完整 prompt。做 AI 短剧的可以把这个「抽帧-改图-回炉」的补丁流程存下来,专治角色服装穿帮。
点击打开原平台查看,能否访问取决于网络环境
05
@kyutai_labs
Kyutai 发布技术博客,介绍其 1 亿参数设备端 TTS 模型 PocketTTS 的训练方法:采用 Deng 等人提出的 drifting 一步生成目标训练,官方称词错率低于 1%,同时具备高质量合成与语音克隆能力,并称这是首个以该方式训练而成的语音模型和自回归模型。对做 AI 配音、短剧对白和虚拟角色语音的团队来说,设备端小体量 + 低词错率 + 语音克隆的组合值得关注,尤其适合需要本地推理、控制成本的场景。
1 亿参数、WER 低于 1%、带语音克隆,还能跑在设备端——做 AI 配音和短剧对白的可以盯一下后续有没有开源权重和推理代码。
点击打开原平台查看,能否访问取决于网络环境
06
@PixelAigc
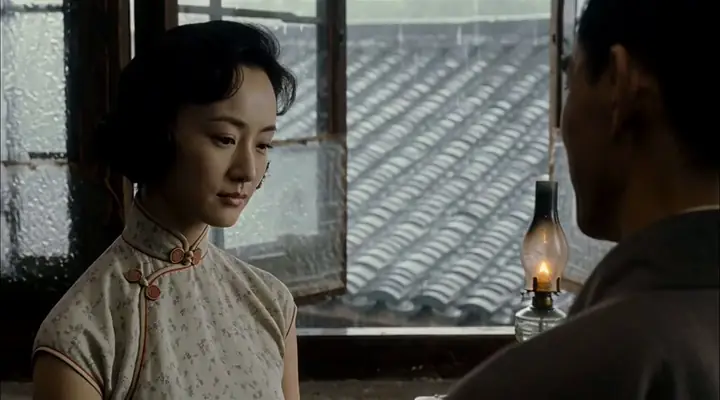
作者用 H3 生成张爱玲 1946 年初春在温州小客栈与胡兰成不欢而散的一幕,画面设定为低照度阴雨光、镜头近乎静止,情绪靠克制的唇线、躲闪的眼神与一步之距承载,并公开了视频提示词。做年代戏和情绪戏的编导可以看它怎么把「克制」翻译成可执行的画面描述。
低照度阴雨光、近乎静止的镜头、靠唇线和眼神撑情绪——这条把「怎么用提示词写一场克制戏」拆得挺细,编导和视觉师可以照着 prompt 结构套一遍。
点击打开原平台查看,能否访问取决于网络环境
07
@icreatelife
创作者 Kris Kashtanova 分享六条 AI 视频制作经验:用 Claude(提到 Opus 5.5)代写提示词,称多数专业人士已不再手写;生成视频前先为每个资产做角色表并打磨,以保持一致性;按模型强项分工,如 Seedream 5.0 Pro 擅长皮肤质感、视频用 Seedance 2.5(只有 2.0 也可用);测试和迭代阶段先出 480p 省积分;很多时候批量生成比反复改提示词更划算;会 Blender 的可用它控制镜头运动和一致性,不会的可以让 Claude 帮忙。
六条来自一线创作者的经验:用 Claude 写提示词、先做角色表保一致性、按模型强项分工、480p 试错省积分。做 AI 短剧和批量出片的可以对着自查一遍流程。
08
@sebatheepan
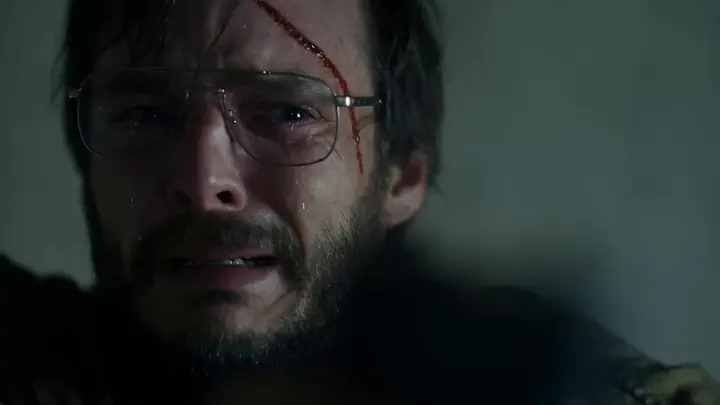
创作者 @sebatheepan 用 Seedance 2.5 从纯文本提示复刻了一段叙事场景,内容是一个无法扣动扳机的人物瞬间,发帖人强调情绪重量、节奏和转入记忆的过渡处理,并称模型把每一帧都呈现到位。属于个人实测分享,附成片片段供对比。
发帖人从纯文本提示直接生成一段带情绪转折和记忆闪回的叙事片段,重点在节奏和转场处理。做 AI 短片和短剧的可以拉片看它怎么用提示词控情绪落点。
点击打开原平台查看,能否访问取决于网络环境
09
@TanLuAI
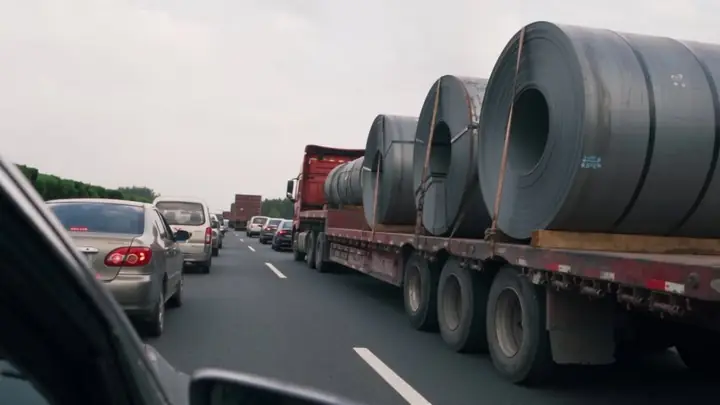
探路AI 发布御剑飞行短剧新剧情片段,延续「师妹撞限高杆」梗,新增戴粉色猪猪头盔、抢师兄的剑、高速公路堵车、手机像素风拍摄、钢卷货车等设定,时长 15 秒。作者公开了改提示词的方法:先给参考提示词,再让 Codex 按「改剧情、改时长、换环境」的指令重写,并附完整提示词供他人套用。
作者把原帖提示词丢给 Codex 改剧情,15 秒新片段加了猪猪头盔、高速堵车、钢卷货车这些梗,做 AI 短剧的可以拿这套「先给参考提示词再让模型改」的写法试自己的脑洞。
点击打开原平台查看,能否访问取决于网络环境
10
@MayorKingAI
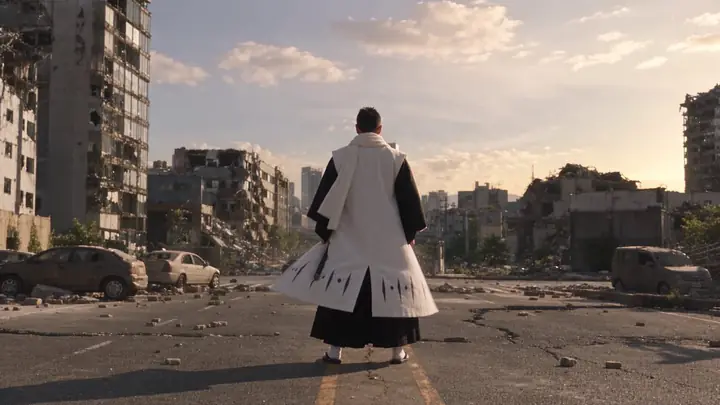
创作者 @MayorKingAI 用 GPT Image 2.5 生成角色形象、Seedance 2.5 在 Dreamina 里做动态,把自己复刻成《死神》朽木白哉释放卍解的画面,推文附完整 prompt。属于动漫 IP 二创 + 真人形象转角色的玩法演示,可参考其角色设定到动态生成的两步流程。
把本人照片做成《死神》朽木白哉放卍解,GPT Image 2.5 出角色设定、Seedance 2.5 做动态,prompt 全公开。做动漫向二创和角色一致性的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
01
新片场 AIGC 分类
新片场 AIGC 分类的 AI 微电影《父辈》,题材为抗日老兵爷爷的个人记忆,走超写实路线,属年代/人物传记向短片。做年代戏和写实人物题材的创作者可参考其老人形象与历史场景的视觉处理。
抗战题材的超写实 AI 微电影,做年代戏和人物传记向短片的编导可以拉片看它怎么处理老人面部质感和历史场景还原。
02
新片场 AIGC 分类
新片场 AIGC 分类收录的中国美术学院 AI 短片《冷藏》,学院派创作背景,短片体量。正文页因浏览器校验未能抓取到具体内容,题材、视觉风格与制作工具暂无公开信息。
国美出品的 AI 短片,学院派视觉和叙事处理值得编导、视觉师拉片看,尤其适合研究 AI 影像里的美术风格统一。
03
B站「AI 短片/短剧/视频」搜索
B 站作者「风吟短剧」发布的 AI 短剧系列,共 6 季,标题强调画面考究、区别于流水线式 AI 短剧。输入信息仅含标题、作者与播放数据,具体题材、单集篇幅和制作工具未在文本中给出。
B 站作者「风吟短剧」的 AI 短剧系列,全 6 季成片,标题主打「每一帧都很考究」,做 AI 短剧的可以拉片看它的画面质感和系列化产能。
点击打开原平台查看
04
B站「AI 短片/短剧/视频」搜索
B站「AI 全民制作人」系列 AI 短剧《困兽之战》第 10 集,设定为外星文明把地球改造成巨型活体斗兽场,窃取人类典籍与网络数据解析神话传说和生物知识,批量制造血肉外观、内核为尖端科技的异兽造物投放大地,异兽彼此厮杀,人类在其中求生。题材偏科幻怪兽向,看点在世界观设定与神话生物视觉化。
B站 AI 系列剧的第 10 集,世界观是外星文明把地球改成活体斗兽场、批量造神话异兽互斗。做 AI 短剧的可以拉片看它怎么把神话生物设定和连续剧集节奏撑到第十集。
点击打开原平台查看