01
@OpenAIDevs
OpenAI 开发者账号宣布 GPT-6.1 Sol 更新(该产品 9 月 23 日已发布),升级了代理式编码和计算机使用能力,性能接近 Astra,缓存输入按标准输入定价的 95% 折扣计费,官方定位是复杂重构、深度代码库调查和跨应用长期运行的 Agent 场景。对做自动化创作流程的团队来说,这类长时运行的 Agent 能力可用于批量素材处理、跨工具调度等环节,但本条未涉及图像/视频/音频生成能力。
OpenAI 的 GPT-6.1 Sol 更新(该产品 9 月 23 日已发布),主打代理式编码和计算机操作,缓存输入按标准价 95% 折扣计费,做自动化工作流和 Agent 的可以接 API 测一轮。
点击打开原平台查看,能否访问取决于网络环境
02
OpenAI Blog
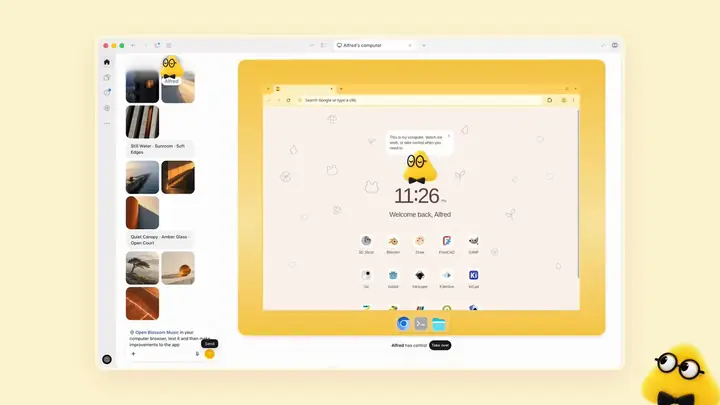
OpenAI 官方博客发布 dots,定位为主动型助手(proactive assistant),可在复杂项目和日常任务之间持续工作,官方强调用户仍能保持对进程的掌控。原文未给出具体模型、参数或接入方式,仅说明其跨任务持续推进的能力定位。对需要同时盯多个长周期项目的制片和 AIGC 整合者来说,这类主动助手可能改变任务跟进方式,但具体能否接入现有创作流程还需看实际产品形态。
OpenAI 官方上线 dots,定位是能跨复杂项目持续推进、同时让你保持掌控的主动型助手。做多线并行项目的制片和整合者可以点开看它怎么接管长周期任务。
点击打开原平台查看,能否访问取决于网络环境
03
AIHOT 公众号爆文
Simon Willison 在旧金山 Fort Mason 现场实时博客 OpenAI DevDay 2026 主题演讲。Altman 上台称这是「最好的一届 DevDay」,先回顾了 Codex on Linux 和 Codex 手机版等已上线功能,随后发布一款定位「与 AI 协作的全新方式」的产品:用户可自定义名字,形象是一个 blob 状头像,演示视频包含大量语音交互,头像「由 Astra 驱动」,并展示了一个迁移 API 的用例。Willison 本人用 Claude Code for web 搭了给实时博客加照片的系统。
Simon Willison 在 Fort Mason 现场逐条记录 DevDay 主题演讲,Altman 上台发布了一款可自定义名字、带 blob 头像的个人 Agent,演示里大量语音交互。做 Agent 工具链和 AI 工作流的可以顺着这份现场记录看 OpenAI 下一步往哪走。
04
@runwayml
Runway 官方宣布以首发合作伙伴身份加入 OpenAI Marketplace,即日起用户可在该平台访问图像、视频、音频和编辑模型,并可将部分 OpenAI 承诺额度用于在 Runway 上的购买。对同时使用 OpenAI 企业额度与 Runway 的团队来说,采购路径多了一条,具体可用模型清单和额度抵扣比例需看官方链接。
Runway 进了 OpenAI Marketplace,OpenAI 的承诺额度能直接拿来买 Runway 的图像、视频、音频和剪辑模型。已经在用 OpenAI 企业额度、又同时跑 Runway 的团队,可以查一下这笔钱能不能省下来。
点击打开原文,能否访问取决于网络环境
01
Every
Every 评测 OpenAI DevDay 2026 发布的 20 多项产品和功能。作者实测后认为 Dots 持久智能体已改变其使用习惯但 bug 较多,Space 办公套件体验较好;Decisions API 在部分测试中以 76/78 对 73/78 的准确率和 230 毫秒对 500 毫秒的响应速度优于 Jev,但另一些测试落后,定价未公布。文中还提到一档每月 500 美元的套餐,含 OpenAI 最高用量额度和 ChatGPT Work 与 Codex 中 Astra Ultrafast 的独家访问。
第三方实测视角,Dots 持久智能体、Space 办公套件、Decisions API 都有上手反馈和跑分对比,做 AI 工作流和 Agent 的可以看这份避坑清单。
点击打开原文
02
@dotey
宝玉(@dotey)分享了一段由 Opus 5.5 自主完成剪辑的视频,并转述作者在评论里公开的 7 步工作流:撰写脚本、从 YouTube 和档案馆搜集知识共享许可素材、剪辑与画面裁剪、画质超分与上色、与配音及字幕标注组合、制作背景配乐、审视成片并迭代优化。对后期和短剧团队来说,这条的价值在于它把「AI 独立完成一条片子的剪辑全流程」拆成了可复用的步骤清单,可以逐环节对照自己现有的工作流,判断哪些能交给模型跑。
从写脚本、找 CC 素材、剪辑裁切、超分上色到配音字幕配乐,7 步全交给 Opus 5.5 跑完。做后期和短剧流水线的可以照着这套流程试一遍,看哪些环节能省人手。
点击打开原平台查看,能否访问取决于网络环境
03
@AYi_AInotes
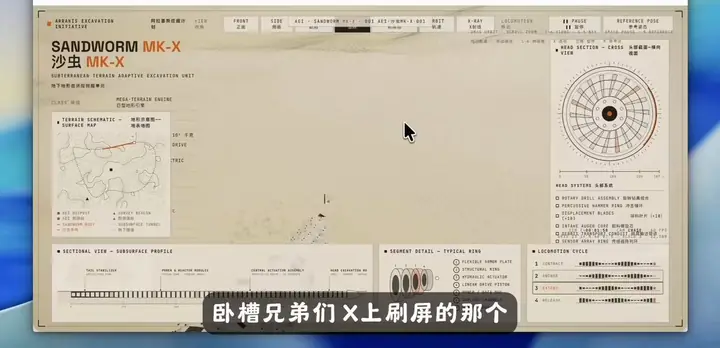
作者用 MiniMax 昨天上线的 M3.1-Flash-Preview,把 X 上刷屏的《沙丘》沙虫变机器人概念视频复刻成一个单文件 HTML 3D 网页,Three.js 走 CDN、零构建,浏览器双击即跑。成品含 6 个机位切换、X 射线内部结构透视、阿拉基斯地形图、头部截面与纵剖面,中段 24 节蠕动驱动拆成收缩/锚定/伸展/释放四拍。作者称前后 7 轮对话、4 个多小时,其中一轮模型自主跑了 55 分 38 秒。模型底子是 M3 编程线,100 万上下文,官方文档写明支持图片和视频输入;出字速度 282 token/秒,思考档默认锁在 max 且关不掉,共 low/med/high/xhigh/max 五档。目前为预览版,仅 MiniMax Code 和 Token Plan 可用,未开放按量 API。
一个 HTML 文件搓出 1312 米机械沙虫,6 机位、X 射线剖面、24 节蠕动全拆开,作者把提示词和参考图都开源了。做概念设计和分镜预演的可以拿这套流程试一遍。
点击打开原平台查看,能否访问取决于网络环境
04
@rainisto
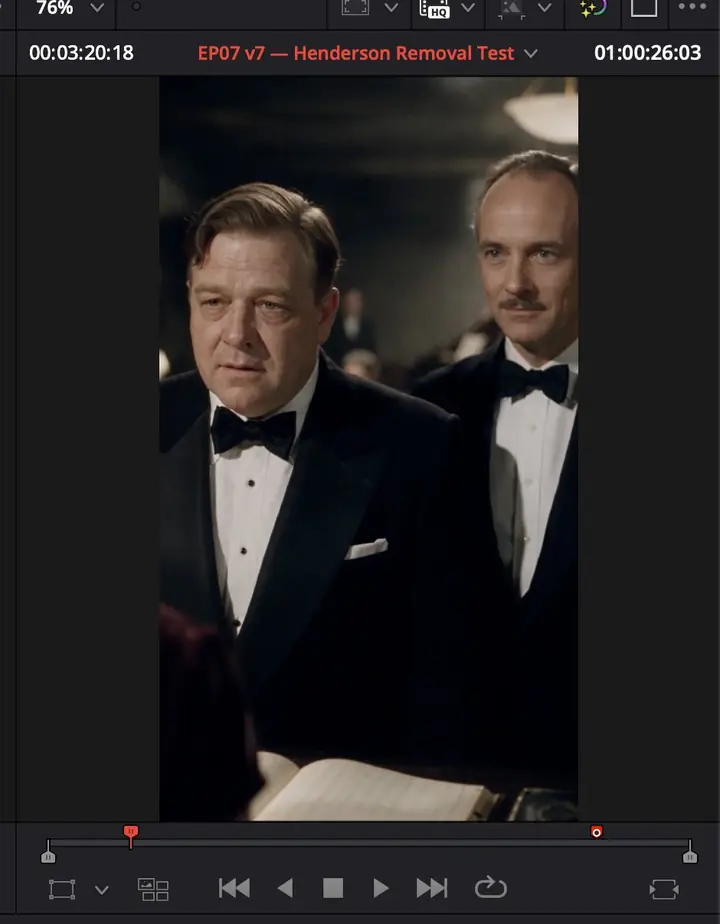
Roope Rainisto 分享的生成式 AI 视频工作建议:投资购买一次性买断的 DaVinci Resolve Studio,因为 Studio 版拥有完整 API 访问权限(免费 21.0.n 版本虽可搭配 MCP,但 API 受限)。接上 MCP 后可用 ChatGPT App(含其图像生成能力)下达自然语言指令,例如「把背景里那个角色去掉」,ChatGPT 会调用 Resolve 和 Fusion 自动执行。作者提到执行需要一点时间,但基本是免费运行。
后期和剪辑师可以试的路子:买断版 Resolve Studio 有完整 API,配合 MCP 让 ChatGPT 直接跑 Resolve 和 Fusion,一句「把背景里那个人去掉」就动手。
点击打开原文,能否访问取决于网络环境
05
@maxescu
创作者 @maxescu 分享了一套双模型分工的 prompt 模板:让 Claude Opus 5.5 Max 负责全部动效与动画,Higgsfield 只生成视频里的静帧图像,目标是产出一支 60 秒的印刷机历史动态图形解说片。风格指定为报纸剪贴拼贴——分层纸片、撕边、半调纹理、柔和阴影加粗体编辑排版。规则里明确要求事实与日期准确、Higgsfield 生成的图内不得出现文字(所有文字由 Claude 以动态排版补上)、全片视觉保持一致,并让结尾回到开场帧以实现无缝循环、禁止硬切收尾。
一条可直接抄的 prompt 分工模板:Higgsfield 只出静帧、动效和排版全交给 Claude,还规定了循环收尾和禁用图内文字。做动态图形和科普解说的可以存下来改改就用。
点击打开原平台查看,能否访问取决于网络环境
06
@ZetoGroovin
作者用相同提示词、相同参考图像、720p/20 秒的条件对比 Kling 4.0 Flash 与 Seedance 2.5,并给出每秒成本:Kling 4.0 Flash 约 12.5 日元(估算价),Seedance 2.5 约 51 日元(10 个服务平均),单条 20 秒约 250 日元对约 1000 日元,成本差约 4 倍,附两段对比视频。
同一提示词、同一参考图、720p/20 秒的横向对比,还算了每秒成本:Kling 4.0 Flash 约 12.5 日元、Seedance 2.5 约 51 日元,单条 20 秒差约 4 倍。做短剧要控成本的,先看这条再决定主力模型。
点击打开原平台查看,能否访问取决于网络环境
07
@nakazakifam
日本创作者 @nakazakifam 对比 ElevenLabs Eleven v4 与 Gemini 3.8 Flash TTS 两款最新语音模型,结论是两者都自然,Eleven v4 这次日语能力大幅加强。视频为 AI 头像 YouTube 风格解说,工具链公开:图像 GPT-Image-2.5、视频 LTX 2.3、音效 Epidemic Sound、BGM 与台本编辑 Opus 5.5、环境 Claude Code / Codex CLI / Colab CLI。
日语 TTS 选型实测:Eleven v4 日语明显加强,跟 Gemini 3.8 Flash TTS 摆一起比自然度。做配音和 AI 口播的可以听一遍再定用哪个。
点击打开原平台查看,能否访问取决于网络环境
08
@nicekate8888
创作者 @nicekate8888 应观众提问,对比测试 Eleven v4 与 Gemini 3.8 Flash TTS 的中文配音效果,试了 ElevenLabs 的内置音色和 Voice Design 两种方式。就试听感受而言,作者认为中文表现 Gemini 3.8 Flash TTS 更胜一筹;同时提到 Eleven v4 生成的音频频繁出现重复朗读,原因不明,并向其他用户询问是否遇到同样问题。
做中文配音的可以拿这条当选型参考:作者实测 ElevenLabs 内置音色和 Voice Design,认为 Gemini 3.8 Flash TTS 中文更自然,Eleven v4 还频繁重复朗读。自己跑一遍对比再定。
点击打开原平台查看,能否访问取决于网络环境
09
Luma AI Blog
Luma AI 官方博客发布《AI Photo Editing Prompts for Color, Light, and Skin》,主题是图像编辑中调色、光影和皮肤质感三类提示词的写法。原文仅给出标题,未展开具体提示词内容与示例图。做 AI 人像修图和视觉开发的可以点开看官方给的提示词结构。
Luma 官方整理的修图提示词合集,覆盖调色、打光和皮肤质感三个方向,做 AI 人像和海报的视觉师可以存下来当模板改。
点击打开原文
10
@FLORAai
FLORA 官方账号转发 @node_pilled 的一条工作流演示:用 FLORA 生成画面帧,交给 Remotion 做程序化动画,中间由 Opus 5.5 把两者串起来。原文只有这一句说明加一个链接,没有参数、时长或成片细节。对做动态图形、片头包装和批量模板的后期来说,这个组合值得自己搭一遍看衔接顺不顺。
FLORA 出帧、Remotion 做程序化动画、Opus 5.5 在中间接线,做动态图形和批量片头的可以顺着这条思路试一遍。
点击打开原平台查看,能否访问取决于网络环境