01
@MaxForAI
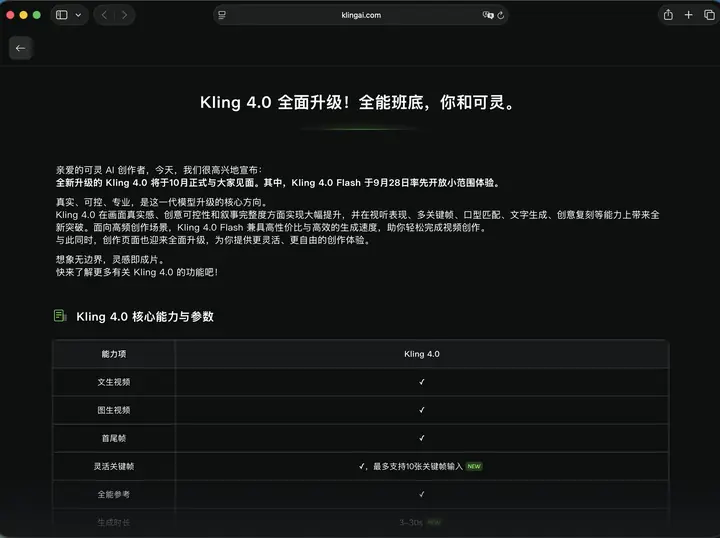
可灵官方公布 Kling 4.0 细节并开启内测:4.0 将于 10 月正式上线,Flash 版自 9 月 28 日起早期内测。核心升级包括单次最长 30 秒(Flash 20 秒,可续延)、最多 10 个关键帧、单任务最多 15 个参考素材(图片/视频/角色/声音)、支持单独修改运镜/风格/背景,并加入 4K/HDR、21:9、原生声音与多语言能力。官方称升级方向为真实、可控、专业。
可灵 4.0 把单次时长拉到 30 秒、关键帧给到 10 个、参考素材一次塞 15 个,还能单独改运镜和风格。做 AI 短剧和长叙事的可以盯 9 月 28 日的 Flash 内测,先摸清多关键帧怎么排分镜。
点击打开原文,能否访问取决于网络环境
02
@Google
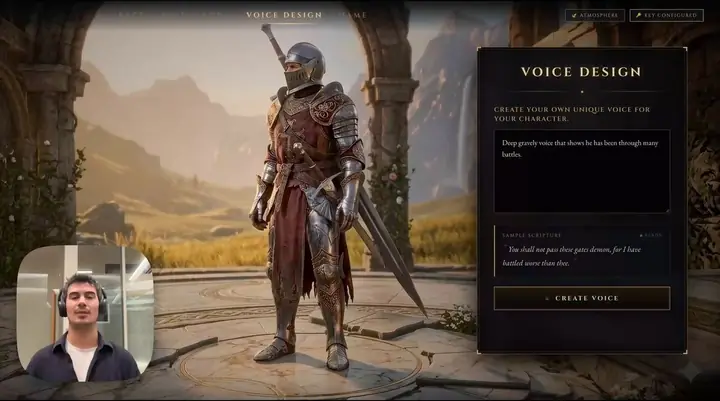
Google 官方介绍 Gemini 3.8 Flash TTS(该产品 9 月 26 日已发布),主打把语音生成做成完整创作台:支持从零设计原创角色音色、覆盖 100 多种语言、调度双人对话,并可逐行定制每句台词的表演,融入自然的笑声、叹息、耳语等效果。做 AI 短剧对白、有声书、虚拟角色配音的团队,可关注多角色对话调度和逐句表演控制这两项能力。
配音和短剧团队重点看:能从头捏原创角色音色、调度双人对话、逐句调表演,还带笑声叹息耳语,做 AI 短剧对白和有声内容的可以直接接 API 试。
点击打开原平台查看,能否访问取决于网络环境
03
TechCrunch AI
Anthropic 发布中端模型 Sonnet 5.5,官方称其为「明显更便宜、更快的工作伙伴」,响应速度提升、token 消耗降低。这是 TechCrunch 的报道,未给出具体价格、上下文长度或跑分数据。对做剧本批量生成、Agent 工作流和长文本处理的创作者来说,中端模型降价提速直接影响单条内容的推理成本,值得接 API 实测一轮。
Anthropic 中端模型换代,主打响应更快、token 消耗更低,做剧本批量生成和 Agent 工作流的可以接 API 跑一周看成本降多少。
点击打开原文
04
@theworldlabs
World Labs 官方账号宣布公司将加入 AMD。官方称自 2024 年成立以来的研发和技术突破,让其对 AI 解决空间与物理世界问题有了清晰愿景,并表示推进空间与物理智能需要扩大投入、扩大覆盖并更贴近硬件。
李飞飞团队的空间智能公司被 AMD 收编,官方说法是要更贴近硬件。做 3D 场景和空间视频的可以留意后续算力侧会不会有变化。
点击打开原平台查看,能否访问取决于网络环境
01
@dair_ai
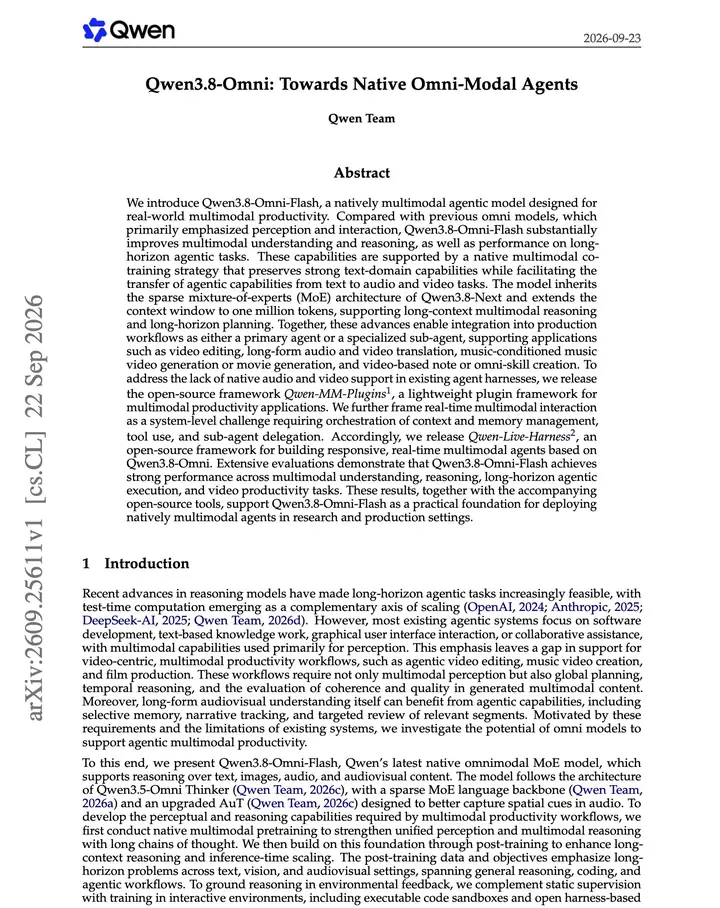
@dair_ai 转述 Qwen3.8-Omni-Flash 技术报告(该产品 9 月 27 日已发布),这是一个原生多模态模型,面向跨文本、音频、视频的长时程智能体任务,举例为视频编辑和长音频视频翻译。模型沿用 Qwen3.8-Next 的稀疏 MoE 架构,上下文窗口 100 万 token,通过协同训练策略在保持文本性能的同时把智能体能力迁移到音频和视频任务。目前为报告阶段。
原生吃文本音频视频、100 万 token 上下文,直接点名视频编辑和长音频视频翻译两个场景,做后期和跨语言内容的可以盯一下后续有没有开放调用。
点击打开原文,能否访问取决于网络环境
02
@JSFILMZ0412
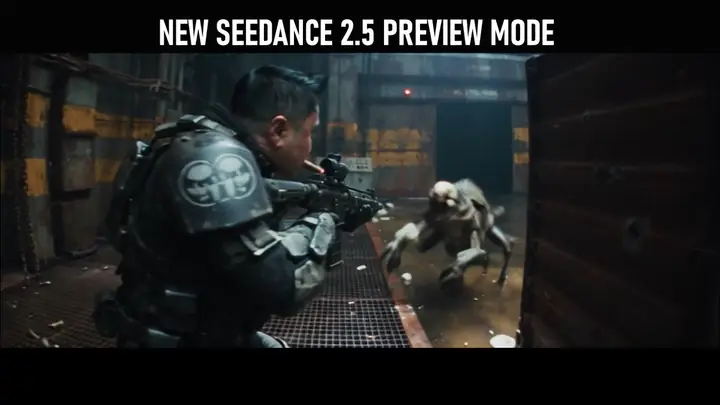
博主 JSFILMZ 对 Dreamina 新上线的 Seedance 2.5 预览模式做了并排提示词测试,对比对象是普通 480p 档位,核心问题是这个更便宜的预览模式画质是否真的更好,测试结果博主称出乎意料,完整对比视频放在评论区。做 AI 短剧和批量出片的团队可以关注这个低成本档位的实际可用度。
Dreamina 新出的 Seedance 2.5 预览模式主打低成本,这位博主做了并排提示词对比测试。跑量出片的短剧团队可以看他的对比结论,判断省钱档位能不能用。
点击打开原平台查看,能否访问取决于网络环境
03
@poteto
Grok bot 的工程与设计负责人 Lauren Tan 和 Peng Zheng 在播客中展示了工作与生活中使用的 14 个 bot,包括把单个关键帧转成完整用户流程的设计 bot、管理工程 bot 团队的工程负责人 bot。他们给出的上手路径是:先观察 bot 工作并纠正,把有效做法沉淀为 skill,待其一次做对后再设为 routine,逐步把更多工作交给 bot。
Grok bot 工程与设计负责人晒出自己日常在用的 14 个 bot,从单张关键帧扩成完整用户流程到管理工程 bot 团队都有。想给创作流程搭自动化助手的,可以看他们「先观察纠正、再沉淀成 skill、最后设成 routine」这套上手顺序。
点击打开原平台查看,能否访问取决于网络环境
04
@howie_serious
作者分享:设计好一个 skill 后,输入一段 mp3 录音,10 分钟即可输出一支 explainer video,走自研路线、不依赖现成动画库,迭代几轮后流程已比较稳定。作者认为 opus 5.5 的能力人人可用,真正拉开差距的是对视频制作流程、视觉风格、技术路线的理解和判断。
一条录音进去、十分钟出来一支讲解视频,作者走自研路线不用现成动画库。做知识类视频和口播转视频的可以看看这套流程怎么搭。
点击打开原平台查看,能否访问取决于网络环境
05
新片场 AIGC 分类
新片场 AIGC 分类的教程视频,针对近期一条情绪短片补出制作方法:只需提供一张底图和一段参考视频,不需要搭建场景。教程形式为视频讲解,时长 3 分 32 秒,属编辑精选内容。做情绪向短片、氛围片的创作者可以按这个思路试跑,重点看单图加参考视频的输入方式在角色和画面一致性上的表现。
只丢一张底图加一段参考视频就能出情绪短片,不用搭场景,做情绪向短片和短剧的可以照着跑一遍看稳定性。
06
AIHOT 全部动态
Simon Willison 在 WeAreDevelopers World Congress North America 闭幕演讲前,把三张鸮鹦鹉照片丢给 Claude Opus 5.5,要求生成 HTML 5 canvas 像素动画——至少 20 只鸮鹦鹉蹦跳开派对、带彩纸效果,并公开了对话记录和成品页面。随后他下载 HTML,让本地 Claude Code 会话用 Playwright 加载页面、在第 3 秒后分散点击触发彩纸,录出 15 秒视频用于嵌入 Keynote。
一条可复用的做法:Claude Opus 5.5 按三张照片生成 20 只鸮鹦鹉的像素动画页面,再用 Claude Code 调 Playwright 自动点击录屏出 15 秒视频。做动态 KV、像素风素材、需要把网页动画转成视频的可以照着跑一遍。
07
@IqrasaifiAI
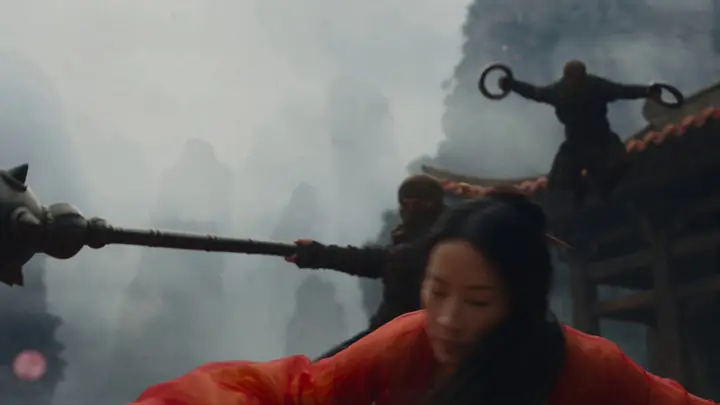
创作者 Iqra Saifi 分享一条武侠动作短片提示词:30 秒、16:9、24fps、AAA 电影级写实,主角为红金丝绸长袍、玉簪束发的女剑客,反派是两名分持三节棍与铁环匕首的暗影武僧,要求全程连续动作、无停顿无对视、跳跃翻转直接接剑招,环境为云雾山寺庭院、陶瓦屋顶、香炉与飘落樱花,并明确禁用字幕、UI、Logo、文字、旁白与背景音乐,只保留山风、衣袂、踏瓦、碎石、剑鸣、破空与呼吸等环境与打斗音效。
一条可直接抄的武侠动作短片提示词,把镜头、角色、兵器、环境音都写死了,做 AI 武侠/短剧打戏的可以拿去改参数跑一遍。
点击打开原平台查看,能否访问取决于网络环境
08
@umesh_ai
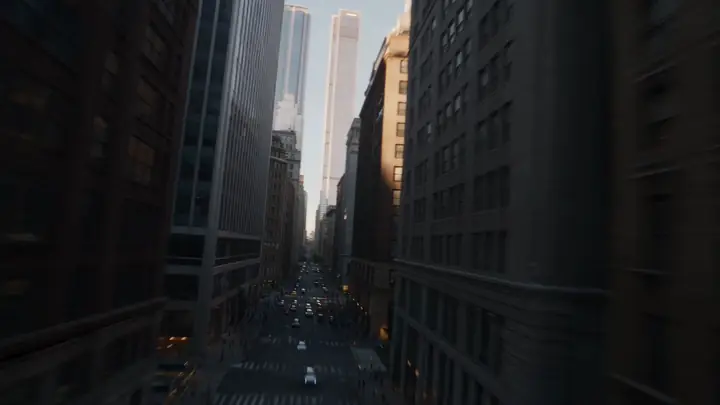
Umesh 分享了一条 15 秒一镜到底的写实超现实城市变形 prompt,按 0-5 秒、5-9 秒、9-12 秒、12-15 秒四段拆解镜头:航拍穿过普通摩天楼、建筑沿隐形接缝像折纸般折叠、整条街道向上弯折让汽车垂直行驶、最后拉远露出整座城市折成一只悬浮云端的巨大纸鹤,并附音效提示(车流渐变为折纸声、结构吱嘎与风声)。
一条可直接抄的 15 秒一镜到底 prompt:城市沿隐形接缝折成纸鹤,连音效节奏都写进了分镜。做视觉开发和 AI 短片分镜的可以存下来改参数试跑。
点击打开原平台查看,能否访问取决于网络环境
09
@FuSheng_0306
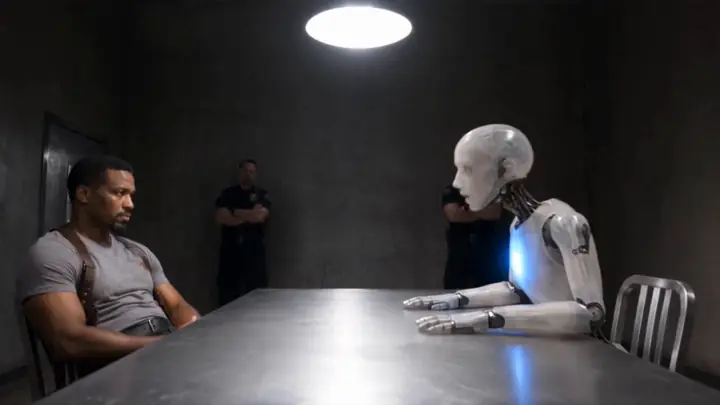
傅盛发帖称中秋期间让 GPT-6 接管自己的微信,连续运行数小时,为 50 位公司骨干各写一段专属祝福,并逐条回复收到的 70 多条祝福,共处理 120 多条消息零失误。他对比称半年前 AI 操作电脑两三步就会停下或点错,这次跑了几千步。
AI 操作电脑从两三步就卡,到这次连跑几千步、120 多条消息零失误,做自动化流程和批量运营的可以看看这个长任务稳定性的实测样本。
点击打开原平台查看,能否访问取决于网络环境
10
@zhongwen_ai
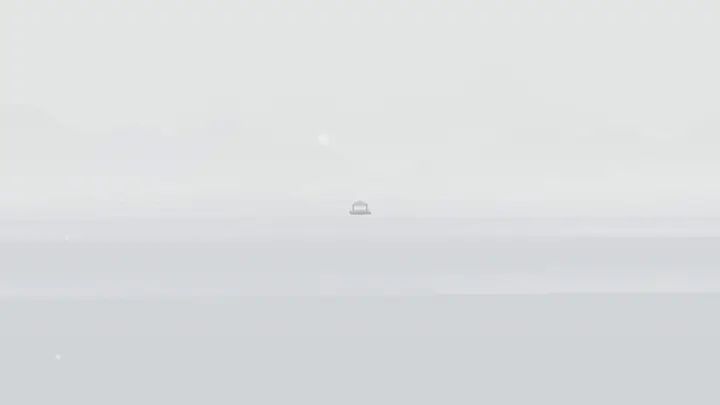
作者因儿子背诵张岱《湖心亭看雪》起意,用 three.js 做了一版网页动画:先从油管下载张清声的真人朗诵并定位时间戳,再在 Poe 上调用 Opus 5.5 生成分镜头剧本,在 GPT-6-Astra 辅助下完成网页制作,出于个人喜好未加中国风背景音乐,认为古文本身的节奏音律已足够。
个人创作者把古文朗诵、分镜剧本和 three.js 网页动画串成一条流程,做文学改编短片或交互影像的可以看看这套做法。
点击打开原平台查看,能否访问取决于网络环境