01
@GoogleAI
Google 本周发布 Gemini 3.8 Flash TTS 与 Gemini 3.8 Flash-Lite TTS 两款音频生成模型,同时推出 Gemini 3.8 Live with Live Avatar,为对话式 AI 带来近实时视觉形象。前者覆盖语音合成,后者把实时对话和视觉形象绑在一起,适合配音、虚拟角色对话、数字人直播这类场景。
两款 TTS 模型加一个近实时视觉形象,配音和虚拟角色对话这条线直接受益,做 AI 短剧配音和数字人直播的可以接 API 跑一周看延迟和自然度。
02
@satyanadella
Satya Nadella 宣布 Copilot 迄今最大更新,定位为覆盖每个模型、设备和任务的工作新 OS,包含四部分:面向企业的主动式长时运行 Agent「Autopilot」、可在公司租户内构建应用的「Code」、聊天与协作合并的「Home」、以及完全嵌入 Copilot 的「Office」。同时可在 Teams 中调用 Copilot,并推出主动推送 M365 重要信息的「Today」。
微软把 Copilot 拆成 Autopilot、Code、Home、Office 四块并塞进 Teams,做制片和团队协作的可以看看这套办公自动化能省多少沟通成本,拍片本身用不上。
点击打开原平台查看,能否访问取决于网络环境
03
@devjuninho
有用户称谷歌已免费开放 Gemini Omni 视频生成:任何拥有谷歌账号的人都能生成 1080p 视频,无需订阅,可控制场景时长、转场、使用模板,全程在浏览器内完成,入口为 vids.google.com。该消息来自个人账号转述,非谷歌官方公告,具体开放范围与限制需自行登录验证。
任何谷歌账号都能免费用 Gemini Omni 出 1080p 视频,还能控时长、加转场、套模板,做短剧和广告的这周拿浏览器跑几条看废片率。
04
@Meituan_LongCat
美团 LongCat 发布 LongCat-2.5-Preview,总参数 1.6T、激活约 48B,提供 1M token 上下文窗口,原生多模态,面向长程任务,覆盖终端、浏览器、GUI、表格和设计工具。现已开放 API(longcat.ai/platform/)和聊天入口(longcat.ai/chat/)。
1.6T 参数、1M token 上下文、原生多模态,主打终端/浏览器/GUI/表格/设计工具的长程任务,API 和聊天入口都已开放。做 Agent 自动化的可以接 API 测一周,看长任务跑不跑得稳。
点击打开原文,能否访问取决于网络环境
05
@ViggleAI
Viggle AI 发布 Viggle Turbo v0.2,支持文生图和图像编辑,6 步即可出图,官方称比 40 步的 Qwen-Image-2.1 快约 5 倍,已在 HuggingFace Space 免费开放运行。对需要快速出分镜草图、批量试风格的视觉和美术团队,出图步数从 40 压到 6 意味着单张等待时间大幅缩短。
6 步出图对比 40 步的 Qwen-Image-2.1 快约 5 倍,HuggingFace 上免费跑。做分镜草图和批量出图的视觉师可以拿它压一轮出图时间。
点击打开原文,能否访问取决于网络环境
06
@innopro_
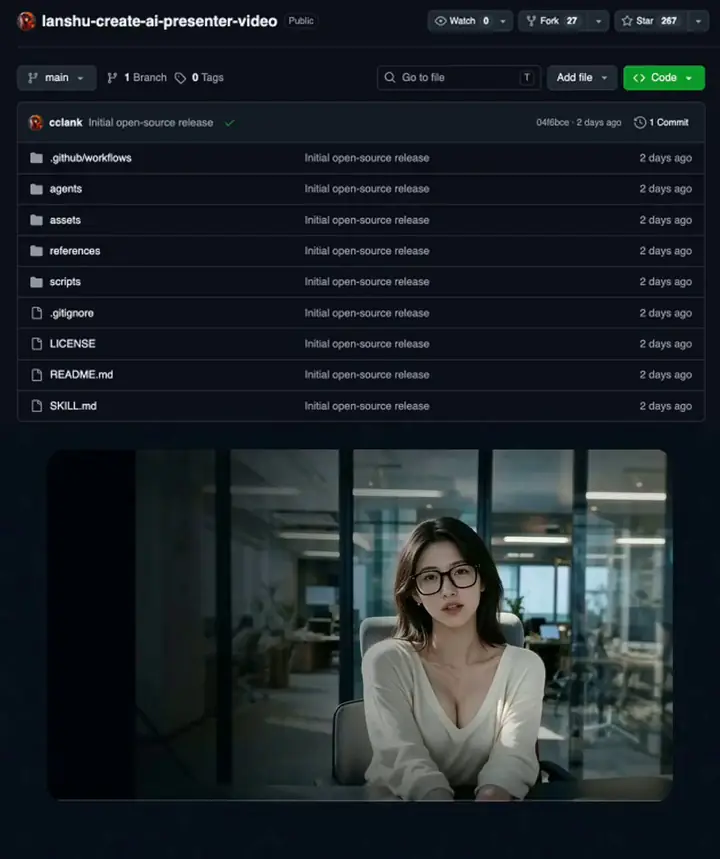
中国开发者发布免费工具 lanshu-create-ai-presenter-video,输入一段脚本和一张有授权的出镜人照片,即可自动生成配音、驱动人物说话并对齐口型,再自动加字幕、生成封面、检查音画同步,最后输出带质检报告的成片。规格为 9:16、1080x1920、30fps、45-75 秒,全程在本地电脑一次运行完成。发布后已获 26000 星标。
脚本加一张授权照片,本地一次跑完配音、对口型、字幕、封面和质检,输出 9:16 竖屏成片。做口播号和短剧的可以拉下来跑一遍,看废片率和口型准度能不能顶住日更。
点击打开原平台查看,能否访问取决于网络环境
07
@thsottiaux
OpenAI 员工 Tibo(@thsottiaux)发推确认 Codex 服务出现中断,团队正在努力恢复正常服务,未给出故障原因、影响范围和预计恢复时间。对依赖 Codex 做自动化脚本或批量处理的团队,只能等官方后续通告。
OpenAI 员工确认 Codex 服务中断、正在恢复,纯运维通告,跟创作工作流没关系,编导和视觉师直接跳过。
01
@Magncsans
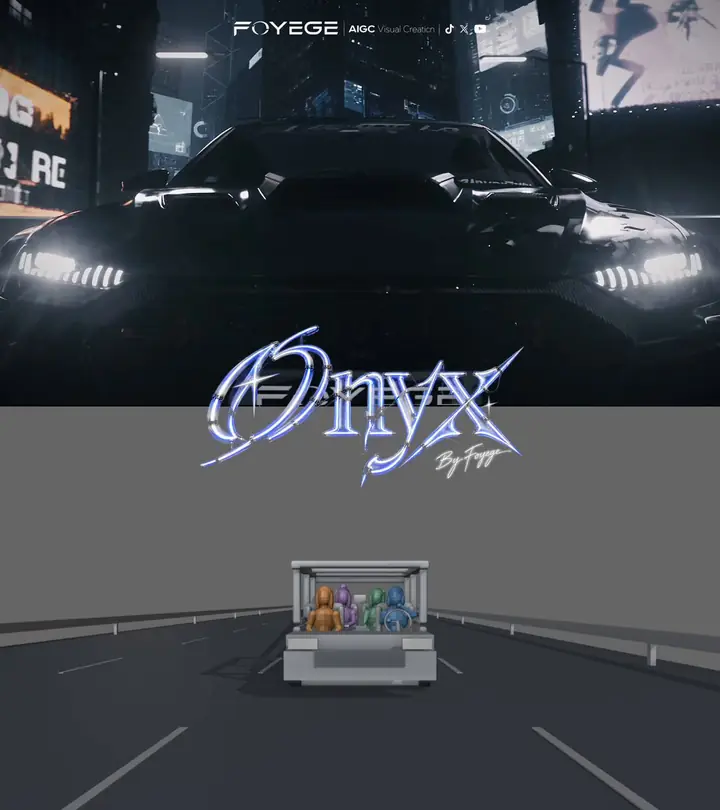
创作者 @Magncsans 分享:为保持场景和角色一致性,整部短片 80% 的镜头用白模预演生成,且都是粗模,这是他第一次把白模工作流投入生产环节。效率上基本 10 分钟内完成一个镜头,不用抽卡,个别镜头生成两次即可。他指出白模预演在 2.0 时期就已具备,如今越来越多人用白模或深度视频辅助生成,本质是给黑盒过程增加确定性,纯写提示词的方法正逐渐被淘汰。
白模预演做一致性、10 分钟一个镜头不用抽卡,做 AI 短剧和长片的可以照这套流程试一遍,比纯写提示词稳得多。
点击打开原平台查看,能否访问取决于网络环境
02
X
AI 研究者 Elvis Saravia 分享 Pexo 实测:把数小时研究的内容喂给 Pexo,10-15 分钟后自动生成一条 30 秒视频,系统围绕研究内容自动完成抠图、贴纸、辅助图像的整套视觉处理,作者称元素都跟着故事走、没有随机堆砌,且这是首次尝试。作者认为历史或解说类内容的工作流因此改变。
把一份研究丢进去,10-15 分钟自动出成片,抠图、贴纸、辅助图像都跟着故事走。做历史和解说类内容的可以拿自己手头的稿子跑一遍,看拼贴逻辑稳不稳。
点击打开原平台查看,能否访问取决于网络环境
03
@xingbugengming
推文公开了一份用 Opus 5.5 生成 UI 动效的完整提示词,要求模型先询问 8-12 个 UI 状态(按钮、加载器、播放器、滑块、开关、图表、命令面板等)和一首约 120 BPM 免版税音乐,再输出单个 1440x1440 的 HTML 文件。技术要点包括:所有样式在 seek(t) 内从时间计算、弹簧用闭式阶跃响应、用 numpy 分析歌曲节拍网格、Playwright 每帧 4 子帧渲染配合 ffmpeg tmix 做 60fps 动态模糊、每拍先渲一帧检查。发帖人提到 Remotion 被 Opus 5.5 取代,并期待 OpenAI Dev Day 发布新模型。
一份可直接抄的 UI 动效提示词:120 BPM 节拍网格、弹簧动画、Playwright 逐帧渲染加 ffmpeg 动态模糊,做动效和片头包装的可以拿去跑一遍。
点击打开原平台查看,能否访问取决于网络环境
04
Runway Blog
Runway 官方博客发布《Evaluating Cost vs. Quality Using Runway Model Router》,主题是用 Model Router 在成本与质量之间做取舍评估。原文仅给出标题,未展开具体模型清单、价格档位或对比数据。对需要控制单条生成成本、又要保证出片质量的短剧和广告团队来说,这类官方口径的选型说明可作为内部跑量前的参考框架。
Runway 官方出的 Model Router 成本/质量对比说明,做预算的制片和跑批量生成的团队可以照着算一遍自己该用哪档模型。
05
@suno
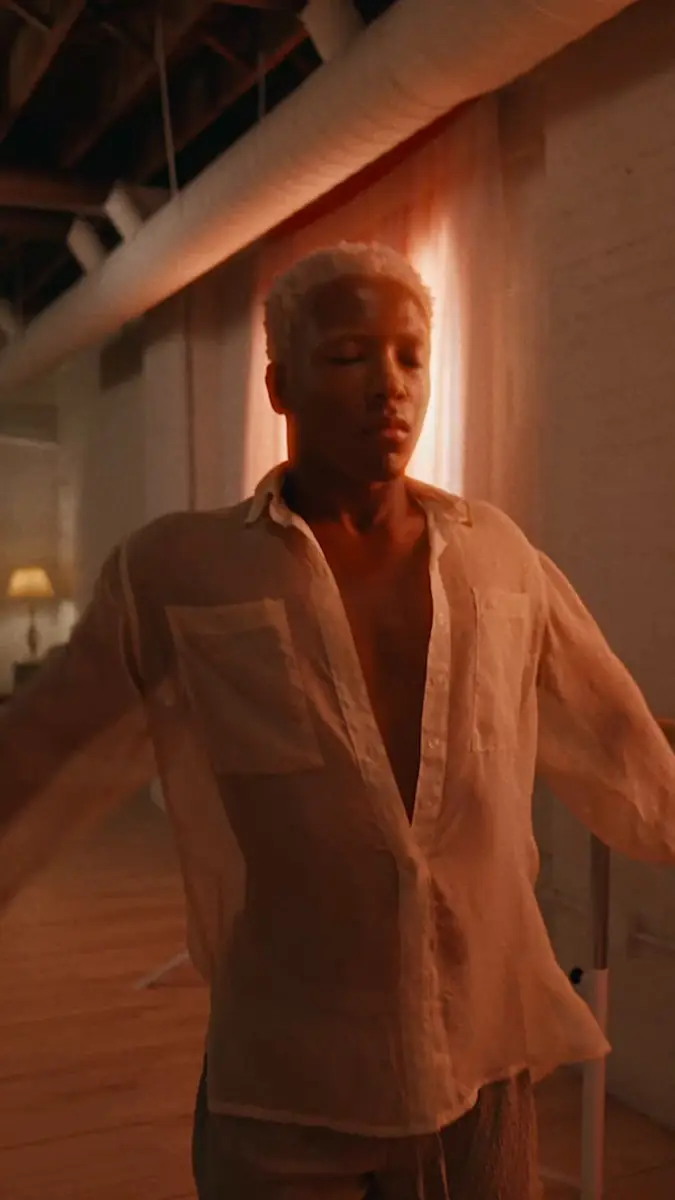
Suno 官方介绍案例:舞者 @braylonbrowner 用 Suno v6 把自己的舞蹈动作变成一首歌,并据此完成首支音乐视频,由 Nina McNeely 执导,成片在 suno.com/braylon 可看(该产品 9 月 10 日已发布)。这条展示的是「动作作为音乐起点」的创作路径,而非单纯用文字提示生成配乐。做 MV、舞蹈影像、音乐短片的团队可以关注动作与音乐生成之间的对应关系。
Suno 官方展示舞者 @braylonbrowner 用 v6 把编舞动作转成音乐,成片由 Nina McNeely 执导。做 MV、舞蹈影像和音乐短片的可以看看动作驱动音乐这条新玩法。
点击打开原平台查看,能否访问取决于网络环境
06
@trymirage
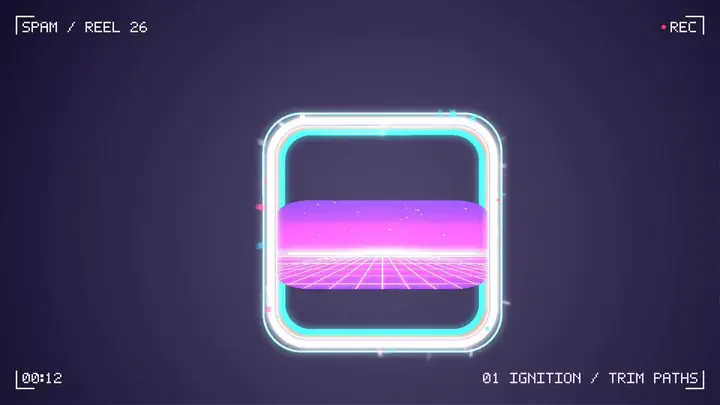
Mirage(@trymirage)称 Opus 5.5 擅长动态图形,与 Tesseract 搭配达到专业级水准,并展示了一次性生成、完全可编辑的动效成果,含 1600+ 图层和 3700+ 动画。对做动态设计和后期的创作者来说,这条的价值在于验证了 AI 直接产出可编辑多图层动效工程的可能性,具体工具链和接入方式需看原帖。
Mirage 团队实测 Opus 5.5 加 Tesseract 一次跑出 1600+ 图层、3700+ 动画且全部可编辑的动效,做后期和动态设计的可以看看这套组合能不能接进自己的流程。
点击打开原平台查看,能否访问取决于网络环境
07
@bcherny
Anthropic 的 Boris Cherny 称 Claude Opus 5.5 近几周是他的日常主力模型。他让 Opus 5.5 和 Fable 5.1 各自把 HAProxy 从 C 移植到 Rust,两者都通过几乎所有测试,Opus 5.5 用时 9.5 小时、Fable 5.1 用时 12 小时,成本低 51%。引用的官方介绍称 Opus 5.5 是 Claude 5.5 家族首个模型,多数任务达到 Fable 5.1 水平,运行成本比 Opus 5 低 40%。
Anthropic 员工拿 HAProxy 从 C 移植到 Rust 做对照,Opus 5.5 比 Fable 5.1 快 2.5 小时、便宜一半。跑长任务自动化的可以拿这个当成本参考。
点击打开原平台查看,能否访问取决于网络环境
08
@DomoAI_
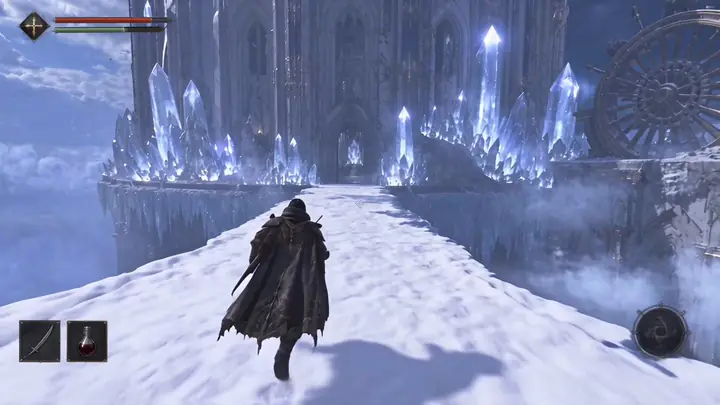
DomoAI 官方发布教程,演示如何用 Seedance 2.5 从图片生成完整的 AI 游戏实机视频,以一场 boss 战为例逐步拆解制作过程,并附上 DomoAI 试用链接。适合想尝试游戏画面风格、实机演示质感的创作者参考其分步做法。
从一张图到完整 boss 战,DomoAI 把用 Seedance 2.5 做游戏实机画面的步骤拆开讲了。做游戏向内容、想蹭实机质感的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
09
@nawalsehar
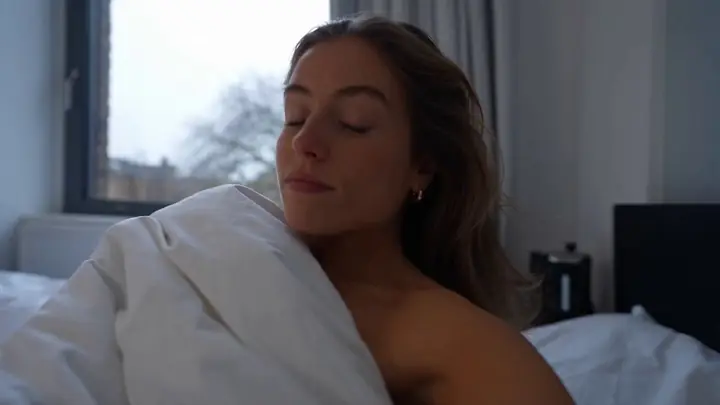
创作者 Nawal 用 Seedance 2.5 生成 30 秒超写实真人大学 vlog,主角为中欧棕发女性,从雨天醒来、煮咖啡、出门撑伞、穿过湿城到课前抵达大学。参数为 16:9、24fps、4K,要求手机 vlog 质感:自然手持晃动、自动对焦变化、真实雨滴与积水倒影、自然表情与人体动作,仅保留环境同期声,禁配乐、旁白、CGI 感、换脸、解剖畸变、字幕与水印,并附四句英文台词。
一条完整可抄的 prompt:手机手持感、雨天地面反光、自然光变化、无配乐纯环境音,还列了禁项清单。做写实向短剧和 vlog 的可以拿这段当模板改。
点击打开原平台查看,能否访问取决于网络环境
10
@arena
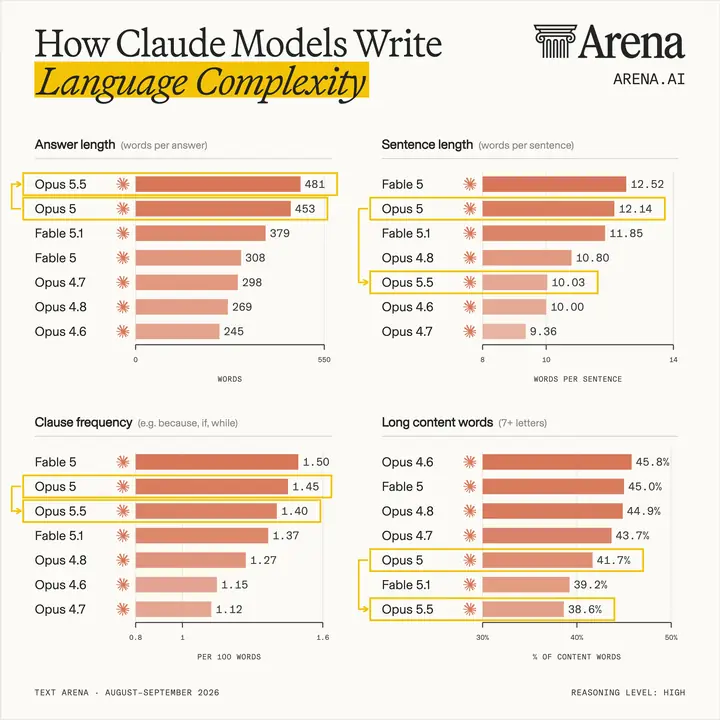
Arena 对比 Claude Opus 5.5 与 Opus 5 在高推理 Text Arena 输出上的写作表现,12 项指标有 10 项改善:长实词占比从 41.7% 降到 38.6%,句子平均从 12.14 词缩到 10.03 词(短 17%),破折号减少 95%、分号减少 73%。代价是答案变长 6%(453→481 词),为 Opus 家族最长;同时「perhaps」「arguably」这类模糊限定词上升 97%,每千词 0.39→0.77。
写剧本、写旁白、写分镜说明的可以看一眼:Opus 5.5 句子短了 17%、破折号少了 95%,但「perhaps/arguably」这类含糊词涨了 97%,答案还长了 6%。
点击打开原文,能否访问取决于网络环境