01
@midjourney
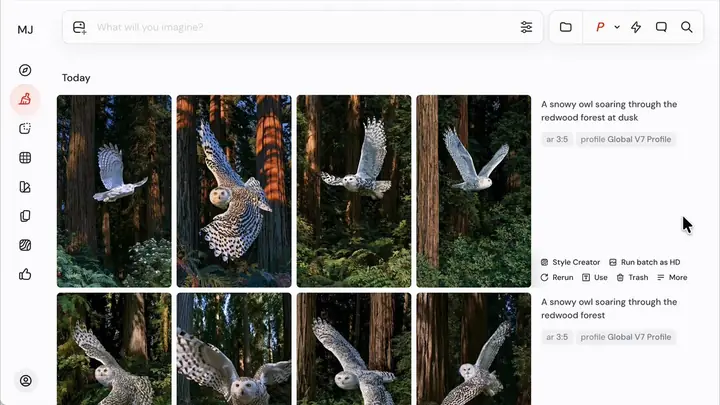
Midjourney 官方发推称,很多人在问新编辑模型怎么用来做角色一致性和其他效果,因此专门做了一支演示视频。推文本身只有这一句说明加视频链接,具体操作步骤和参数需看视频内容。对做角色 IP、系列图、分镜视觉开发的创作者来说,官方亲自出教程意味着这套角色一致性用法已被验证,值得跟着视频跑一遍。
Midjourney 官方针对新编辑模型的角色一致性用法出了演示视频,做角色 IP 和系列图的视觉师可以跟着跑一遍,看它怎么把同一张脸稳定复用。
点击打开原平台查看,能否访问取决于网络环境
02
@gkxspace
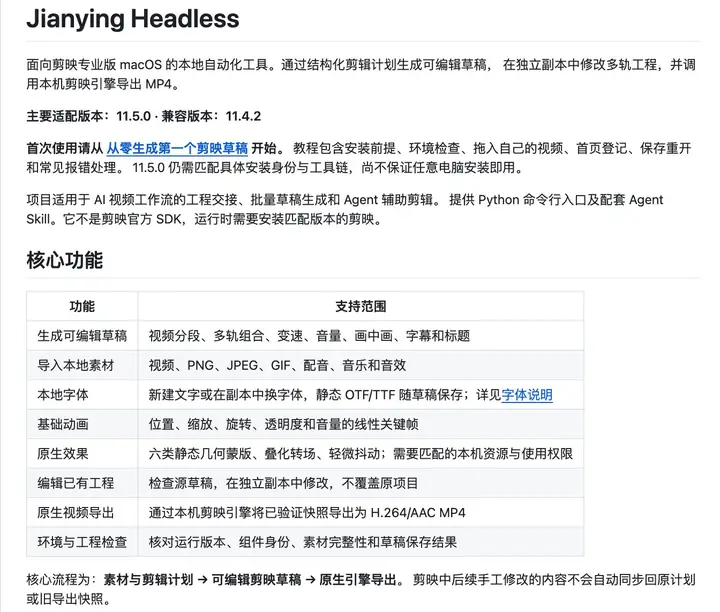
作者称剪映今天上线 Agent,走封闭全家桶路线、能力只在软件内、卖 AI 会员、不开放第三方调用。他推荐逸尘的逆向开源项目,思路相反:把剪辑软件控制权交给外部 Agent,可用 Codex 一条指令批量粗剪几十条视频、加字幕、配 BGM;用几分钱的 DeepSeek 配合豆包 ASR,一小时视频成本不到一块钱;产出仍是剪映原生工程,可打开人工微调。作者提醒该项目随时可能 404,建议尽快 Fork。
剪映 Agent 走封闭全家桶,这套逆向方案反过来把剪辑控制权交给外部 Agent:Codex 一条指令批量粗剪加字幕配 BGM,一小时视频成本不到一块钱,做批量口播和短视频后期的可以 Fork 一份存着。
点击打开原文,能否访问取决于网络环境
03
@AYi_AInotes
GitHub 1.1 万星标的开源桌面端工具 OpenCreator,输入 40 分钟长视频或公开视频链接后单次运行完成字幕断句、多语种翻译、语音配音,自动估算口播语速对齐音轨,文本过长时调用语言模型精简成口语表达;跑完可自适应竖屏排版并生成封面素材,对应 YouTube、TikTok、B站、抖音规格。底层模型和 TTS 服务支持自由配置,本地运行不按分钟付费。
40 分钟长视频一次跑完字幕断句、多语种翻译、配音和竖屏适配,做视频出海和矩阵分发的后期可以拉回本地试一周,省掉按分钟付费的切片订阅。
点击打开原平台查看,能否访问取决于网络环境
04
@CrazyKaomei
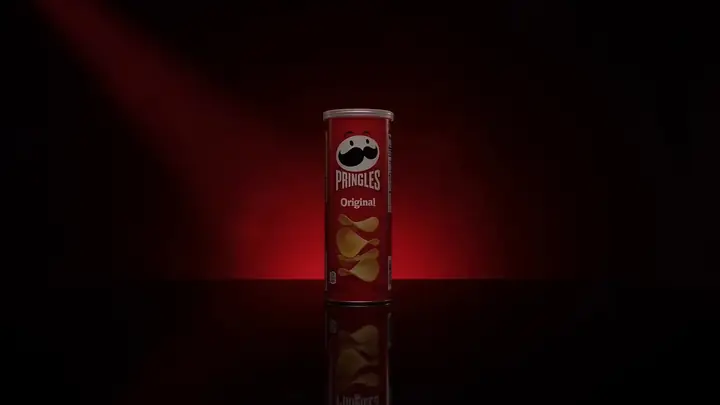
博主 @CrazyKaomei 称,过去一分钟报价 1000 元起步的商业级食品宣传片,现在普通人坐在电脑前两分钟就能复刻,并公开了完整分镜脚本和视频生成提示词,建议有 Gemini 会员的用户直接上手试。对做广告片和商业短视频的团队来说,这是一份可直接套用的食品类广告复刻流程,值得对照自己的报价和交付周期重新算一遍账。
一条商业食品广告片过去一分钟报价 1000 元起步,现在两分钟就能复刻,作者把完整分镜脚本和视频提示词都放出来了。接广告单的制片和视觉师可以照着跑一遍,看看自己那套报价还站不站得住。
点击打开原平台查看,能否访问取决于网络环境
05
@mustafasuleyman
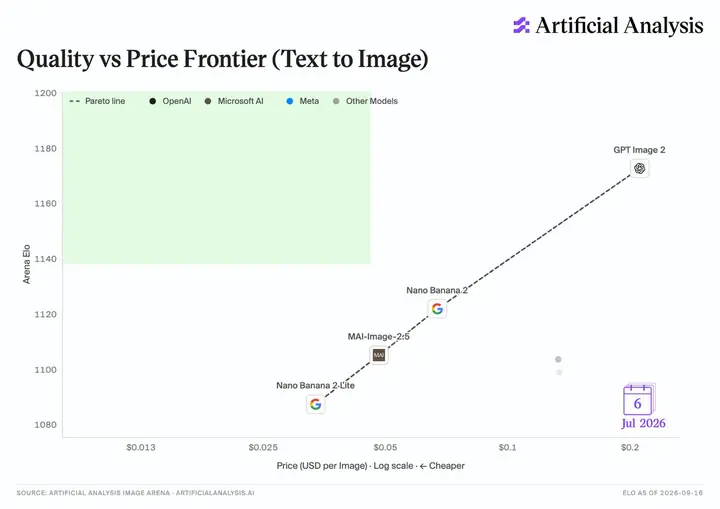
微软 AI CEO Mustafa Suleyman 发推称 MAI-Image-2.6 具备「全球图像生成最佳性价比」,生成质量更高、更便宜更快,并提到近几周 Muse Image、MAI-Image-2.6 和 GPT Images 2.5 一起推动了文生图在价格与速度上的帕累托前沿。推文未给出具体单价、出图速度或对比数据。
微软 AI 负责人自己下场说 MAI-Image-2.6 把文生图的价格和速度往前推了一截,还点名 Muse Image、GPT Images 2.5 同批。做批量出图的可以拿同一批 prompt 跑三家比单价和出图速度。
点击打开原平台查看,能否访问取决于网络环境
06
@CharaspowerAI
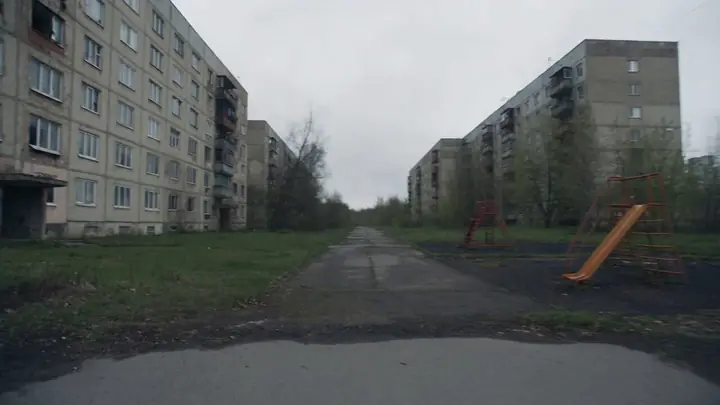
创作者 Pierrick Chevallier(@CharaspowerAI)分享用 Seedance 2.5 做恐怖片质感的思路:刻意追求糟糕的自动对焦、摇晃构图、空荡建筑和容易被忽略的细微细节,认为画面越糙恐怖感越可信,并公开了完整 30 秒提示词。做恐怖、悬疑、伪纪录片风格的编导和视觉可以拿这套 prompt 跑一遍,看模型对失焦和手持晃动这类「缺陷美学」的还原度。
反着来的思路:用失焦、晃镜、空建筑堆恐怖感,作者说这是他在 Seedance 2.5 里刻意推的方向,附完整 30 秒提示词。拍恐怖/悬疑向的可以抄这套 prompt 试一遍。
点击打开原平台查看,能否访问取决于网络环境
07
@trq212
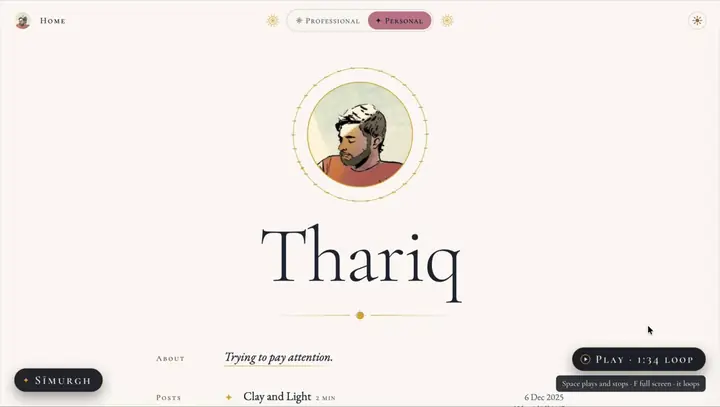
X 用户 Thariq(@trq212)用 MAX 订阅让 Opus 5.5 批量生成个人网站重设计方案,通过工作流让模型自我迭代和批判,最终方案命中了他想要的调性;随后他又让模型把整个迭代过程做成一支预告片。属于个人使用体验分享,展示了用工作流驱动模型自我批判、并把过程素材二次加工成视频的思路。
用工作流让模型自己迭代+批判设计方案,再把迭代过程剪成预告片,做视觉开发和提案演示的可以看看这套「让 AI 自己挑刺」的玩法。
点击打开原平台查看,能否访问取决于网络环境
08
@GumVue
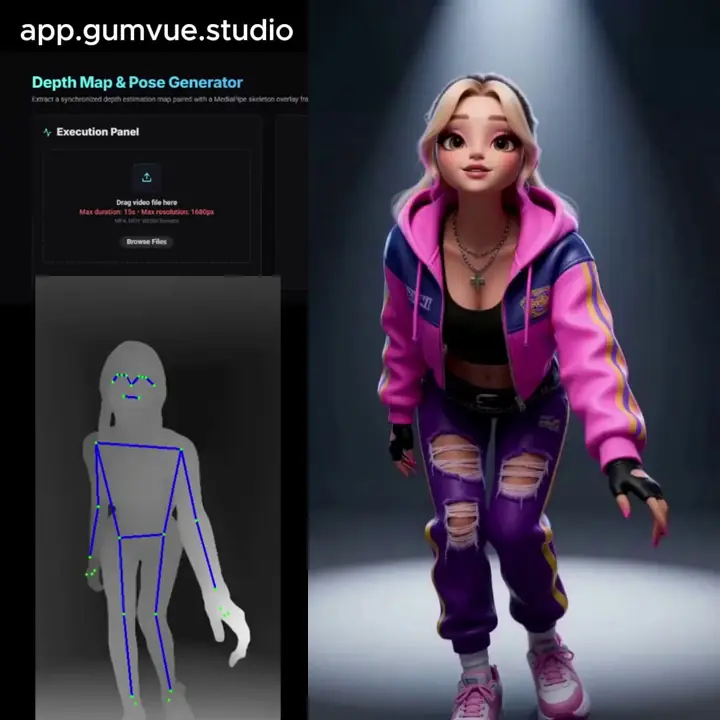
Gumvue Studio 发布 Depth Map & Pose Generator 工具,可逐帧提取同步的深度估计图,并叠加 MediaPipe 骨架。演示视频使用 Minimax H3 模型生成。该工具面向需要从视频中提取深度信息和人体姿态数据的场景,可用于 AI 视频转绘、动作捕捉参考、后期合成等流程。
逐帧导出深度图和 MediaPipe 骨架叠加,做 AI 视频转绘、动作参考、后期合成的可以试一下这个工具。
点击打开原平台查看,能否访问取决于网络环境
09
@krea_ai
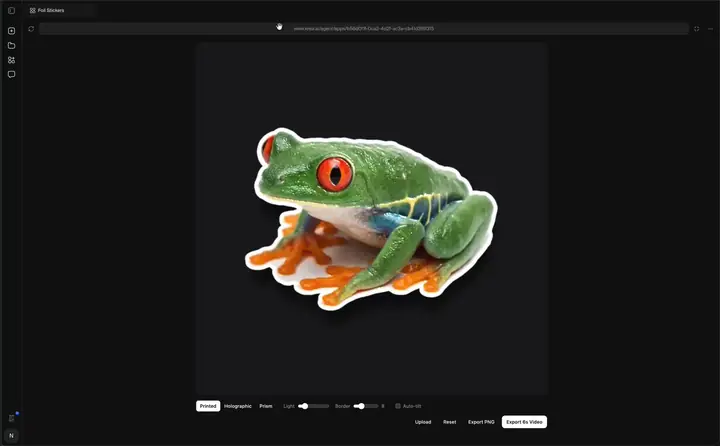
Krea 官方转发用户 @nicdunz 的作品:在 Krea Agent 里搭了一个自定义应用,把任意图片转成烫金贴纸效果,支持拖动倾斜查看、切换不同质感(finish)。这是 Krea Agent 自定义应用能力的一个用例展示,作者附了可直接试用的链接。做视觉开发和物料设计的可以看看这类小应用怎么搭,判断能不能套到自己的出图流程里。
Krea Agent 里能自己搭小应用了,这条把图片转成可拖动、可换质感的烫金贴纸。做视觉和物料的设计师可以点开试一下手感,想想自己那套流程能不能也搭一个。
点击打开原平台查看,能否访问取决于网络环境
10
@dotey
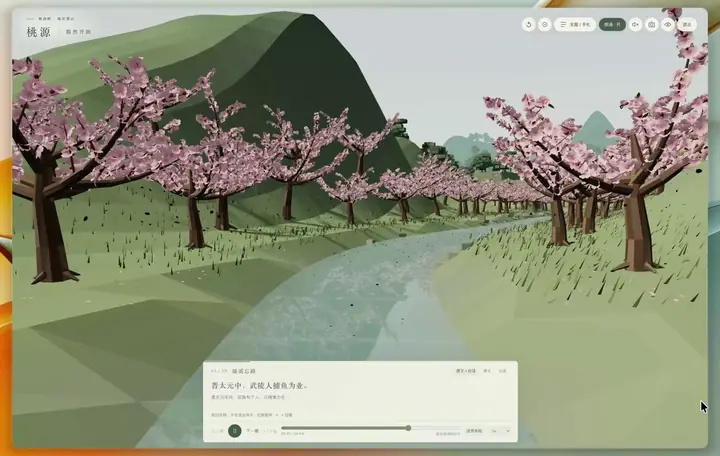
宝玉回应此前「桃花源」作品被批不好看,重做了「牛来」版桃花源,用 GPT 6 Astra 以一条提示词 one-shot 生成完整可交互 3D 网页,并公开了提示词与制作方法,附可直接打开的网页链接。他自评 3D 水平有限、视频录制效果一般,建议直接打开网页体验。对做 AI 交互视觉和网页生成的创作者来说,这条的价值在于一条提示词产出完整 3D 场景的可行性样本,以及可复用的提示词写法。
一条提示词 one-shot 出完整可交互 3D 网页,作者把提示词和做法都放出来了,做 AI 网页/交互视觉的可以打开链接自己转一圈,看这套做法能不能挪到自己的项目里。
点击打开原平台查看,能否访问取决于网络环境