01
@OpenAI
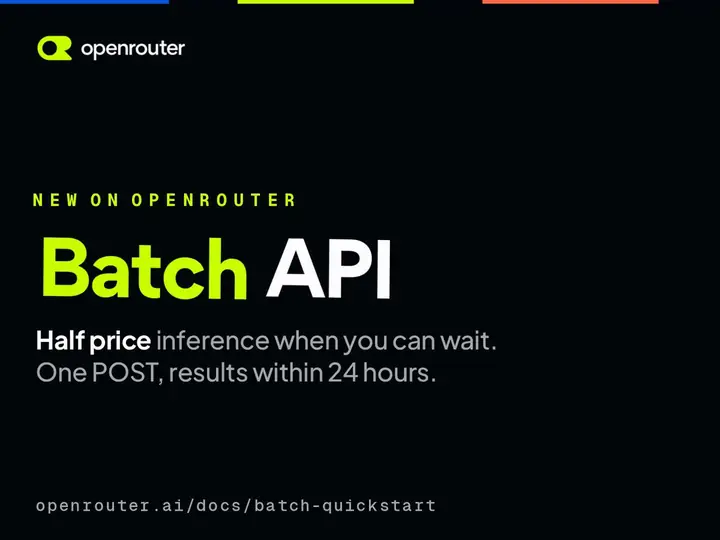
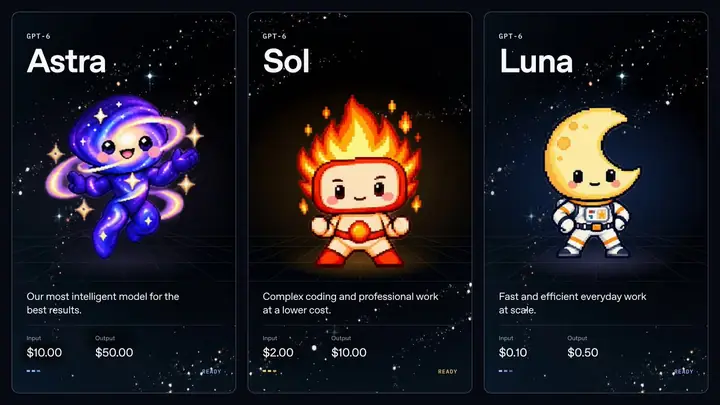
OpenAI 发布 GPT-6 Sol 和 GPT-6 Luna 两款模型,基于 GPT-6 Astra 的技术成果,主打更快、更可负担、适合大规模使用。官方称提升了缓存与推理效率并把节省传导给用户,两款模型的 API 价格比 GPT-5.6 促销定价低 50%。对需要大批量调用模型的短剧团队和 Agent 工作流搭建者来说,成本直接砍半,适合先接 API 实测出片流程里的脚本、翻译、批处理环节。
两款新模型基于 GPT-6 Astra,主打快和便宜,API 价格比 GPT-5.6 促销价还低 50%。做剧本批量生成、字幕翻译、Agent 流水线的团队,这周可以接 API 跑一遍算算成本。
点击打开原平台查看,能否访问取决于网络环境
02
@ClaudeDevs
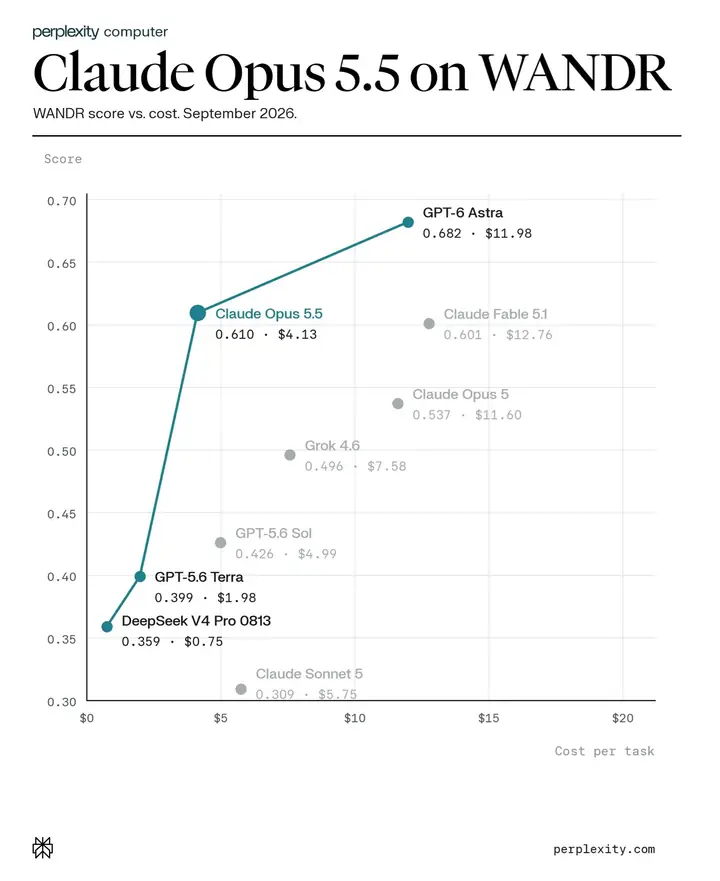
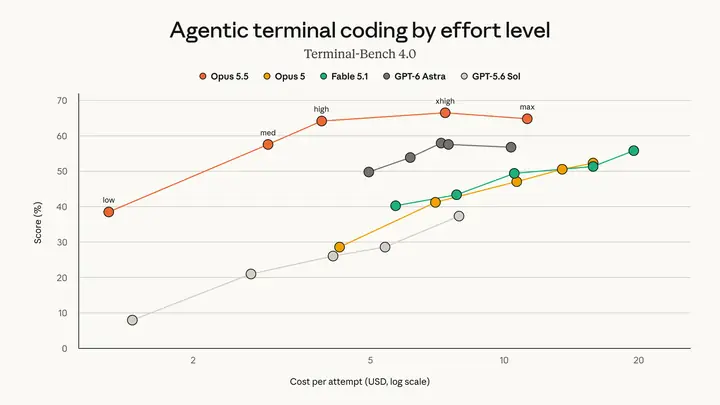
Anthropic 推出 Claude 5.5 家族首个模型 Claude Opus 5.5,官方称多数任务达到 Claude Fable 5.1 水平,运行成本比 Opus 5 低 40%,每任务速度快约 30%。Claude Code 中 5 小时会话限额今日提升 20%,因定价更低额度内可用量多 25%,Pro、Max、Team 用户另获一次可随时使用的额度重置。引用图显示其在 Terminal-Bench 4.0 各 effort 档位得分领先。
Opus 5.5 每任务快约 30%、成本比 Opus 5 低 40%,Claude Code 额度同步上调,写剧本、跑分镜脚本、搭自动化流程的可以接 API 实测一周。
点击打开原文,能否访问取决于网络环境
03
@PixVerse
PixVerse 官方发布全新实时世界模型 PixVerse R2,官方描述其能力为:可探索「鲜活的世界」,用提示词实时控制和编辑场景,塑造故事走向,并让角色具备记忆与回应能力。官方未公布模型参数、开放时间、价格或接入方式。对做互动叙事、实时影像和 AI 短剧的创作者来说,实时可控 + 角色记忆是此前工作流里最难啃的两块,值得等实测验证延迟与一致性。
PixVerse 官方放出 R2 实时世界模型,主打提示词实时控制与编辑场景、角色带记忆能回应,做互动叙事和实时影像的可以蹲一波实测看延迟和可控性。
点击打开原平台查看,能否访问取决于网络环境
04
@trymirage
Mirage 发布 Tesseract,定位为「给 AI 代理用的视频创作套件」,官方称其为面向 GPT-6 Astra 和 Sol 重建的 After Effects 与 Premiere。代理可直接调用其创作引擎,完成素材剪辑、动效与声音处理,做精确修改并直接渲染,无需在传统软件界面里手动操作。官方提供 ChatGPT 插件获取,并称演示视频本身即由 Tesseract 制作。
把剪辑、动效、声音的控制权交给 AI 代理,改片和渲染都能在对话里完成,做后期和批量出片的可以装个 ChatGPT 插件跑一遍。
05
@TencentHunyuan
腾讯混元发布 Hy Image3.5 preview,主打专业级图像生成,在对比 Hy Image3.0 的人类评测中胜率提升 30%。支持文生图与图生图,最高 2K 分辨率,一致性更好;Tencent Cloud API 定价每张 0.024 美元,参考图不收费,OnSolo 与 Miora 内可免费试用两周。官方同时放出多组生成案例。
混元新图像模型人评胜率比 3.0 高 30%,支持 2K 文生图/图生图,API 每张 0.024 美元、参考图不收费,做视觉开发和 KV 的可以拿它跟现有出图工具比一轮一致性。
点击打开原文,能否访问取决于网络环境
06
@AntLingAGI
蚂蚁百灵开源 Ming-Image-0.1-Design 系列,含 Ming-Image-0.1-Design(6B)和 Ming-Image-0.1-Design-Layer(6B)两个模型,同时开源 Ling UI Design Skill 和 Image-to-Editable-PPT Skill 两个 Agent Skills。官方称 Ming-Image-0.1-Design 在 Artificial Analysis 的 UI/UX Design 排行榜上位列开放权重模型第一。
6B 开源图像模型,主打 UI/UX 设计稿生成,还配了 UI 设计和图片转可编辑 PPT 两个 Agent Skill,做视觉开发和物料批量出图的可以拉下来跑一遍。
07
@motion_so
Motion(@motion_so)发布面向动效设计的 GPT-6 集成:用户提供想法、素材和视觉参考后,通过 Motion MCP 可自动构建动画场景、排版与过渡效果,并生成多个可继续编辑的版本;用自然语言描述修改需求,GPT-6 会在 Motion 内直接更新视频。
给想法、素材和视觉参考,GPT-6 通过 Motion MCP 直接生成动画场景、排版和转场,还能用一句话改片。做后期和动效的可以上手试试这套改片方式。
点击打开原平台查看,能否访问取决于网络环境
08
@_jasonsilberman
开发者 jason silberman 称团队用 5 个月构建了一个跨平台、基于 Rust 的渲染引擎,可替代 Premiere 和 After Effects,目前为其网页端和 iOS 应用的视频编辑器提供支持,现已直接在 ChatGPT 中免费开放访问。作者还提到该引擎与 GPT-6 Sol 搭配效果不错。对后期和剪辑团队来说,值得实测它在 ChatGPT 内的实际渲染能力与可接入程度。
用 Rust 重写的渲染引擎,作者称可替代 Premiere 和 After Effects,现在 ChatGPT 里免费开放。做后期和批量剪辑的可以进去跑一遍,看它能不能接进现有流程。
09
X
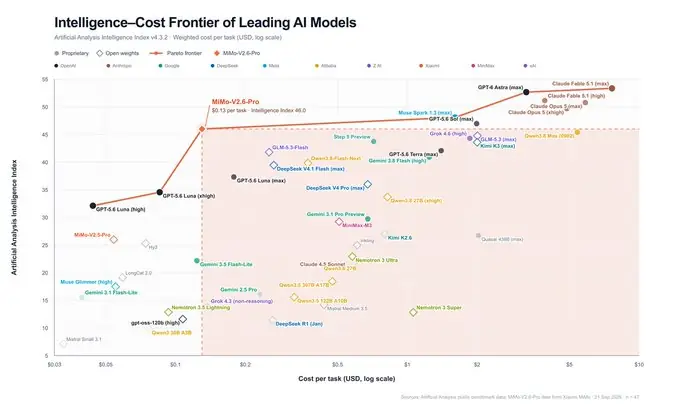
小米发布开放权重模型 MiMo-V2.6-Pro,Artificial Analysis 智能指数得分 46,为开放权重模型中最高,较前代 MiMo-V2.5-Pro 的 26 大幅提升,每任务成本 $0.13,落在智能与成本帕累托前沿。同步开源 Pro、Flash、MiMo-V2.6-Distill-Qwen-9B、技术报告、7K+ RL 任务环境、全流程 RL 框架和可组合 mini-harnesses。
小米把 MiMo-V2.6-Pro 连同 Flash、蒸馏版、技术报告和 7K+ RL 环境一起开源,开放权重模型里智能指数最高。做 Agent 和自动化流程的可以看看这套 RL 框架能不能接进自己的调度里。
点击打开原文,能否访问取决于网络环境
10
@runwayml
Runway 正式推出 DIFFUSE,一个面向代理机构、品牌和工作室的平台,用于搜索、对接并雇佣 AI 原生人才,官方称需求正在加速增长,注册入口已开放。对靠 AI 接商单的独立创作者和短剧团队来说,这是多了一条被甲方直接找到的渠道,可以先注册看平台上的需求类型和报价方式。
Runway 自己搭了个 AI 人才对接平台,代理机构、品牌、工作室可以在上面搜人、约人、雇人。接商单的独立创作者和短剧团队可以先去注册占个位,看甲方需求长什么样。
点击打开原平台查看,能否访问取决于网络环境
11
@ArtificialAnlys
Artificial Analysis 把 Controlled Voice Arena 扩展到日语、中文、印地语、西班牙语、德语、法语、葡萄牙语、越南语、阿拉伯语 9 种语言,发布多语言 TTS 排行榜。评测用标准化克隆音色、各语言母语者撰写的 prompt、母语者偏好投票,每种语言独立计算 Elo。结果显示 Cartesia Sonic 家族在 9 个新榜中领先 8 个(Sonic 3.6 在 7 种语言第一,Sonic 3.5 领先葡萄牙语),Inworld Realtime TTS-2 以 1185 Elo 拿下中文第一,ElevenLabs Eleven v3 家族在 7 种语言进入前三。
配音和 AI 短剧团队选 TTS 模型前先看这份榜:Cartesia Sonic 3.6 在 7 种语言排第一,Inworld 拿下中文第一,Eleven v3 七种语言进前三。
点击打开原平台查看,能否访问取决于网络环境
01
@aiwarts
AI 创作者「卡尔的AI沃茨」把自己积累的 463 个 AI 视频整理成 Skill 和提示语模版并全部开源,作者自述从程序员转型做 AI 视频、做到百万播放,方法论核心是「审美积累」。对做 AI 视频的编导和视觉师来说,这是一份可直接取用的提示语参考库,适合按题材翻找对应模版再套用到自己的项目里。
463 个 AI 视频案例拆成的 Skill 和提示语模版全开源,做视觉和短剧的可以直接拿来当参考库,先翻一遍挑几个套着跑。
02
@VibeEverything
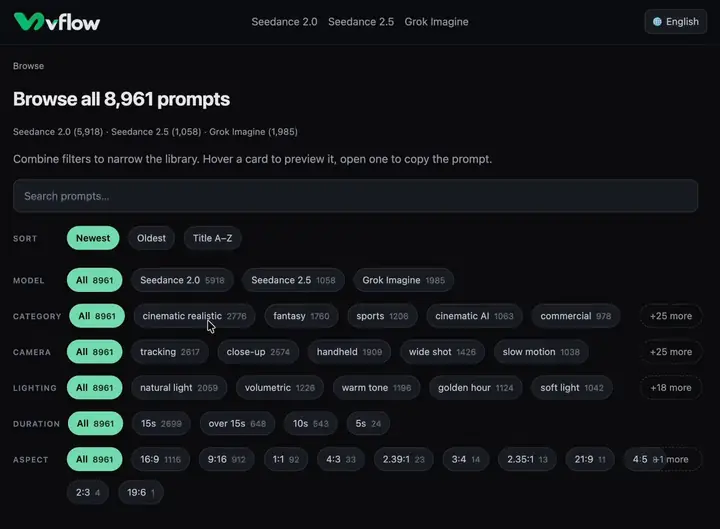
一个按导演手法整理的 AI 视频提示词库,汇集约 9000 条视频与对应提示词,可按广告、奇幻、Vlog 等类型筛选,也能按镜头运动和灯光条件过滤,方便找到想要的参考片。每条视频的镜头运动、氛围等要素被整理成表格,不用逐条读长 prompt 就能看到核心的镜头处理方式。
按广告、奇幻、Vlog 等类型和镜头运动、灯光筛选参考片,每条还配了镜头与氛围的整理表,编导和视觉师找参考镜头时能省掉翻长 prompt 的功夫。
点击打开原平台查看,能否访问取决于网络环境
03
@krea_ai
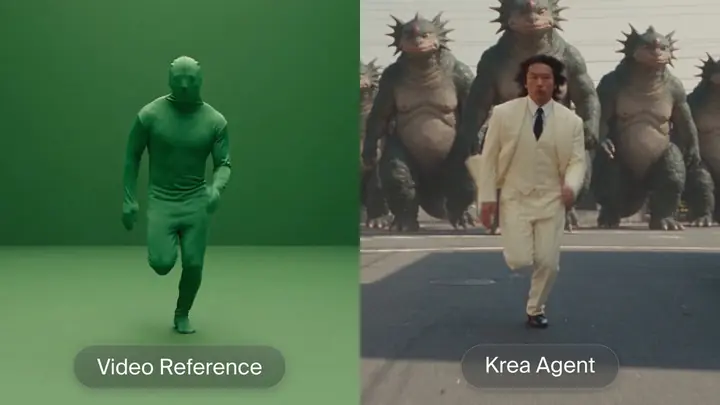
Krea AI 官方发布演示,展示用 Krea Agent 仅凭一个参考视频即可生成电影感镜头,并附上制作步骤讲解。核心卖点是单参考视频输入、Agent 自动完成镜头生成,面向镜头语言和视觉风格迁移场景。做分镜预演和视觉开发的可以按官方步骤跑一遍,验证单参考输入下的风格还原度和镜头稳定性。
Krea 官方放出的用法演示:只给一个参考视频就能让 Agent 出电影感镜头,做分镜和视觉开发的可以照着跑一遍,看它能不能接进自己的镜头设计流程。
点击打开原平台查看,能否访问取决于网络环境
04
@fakeWow_
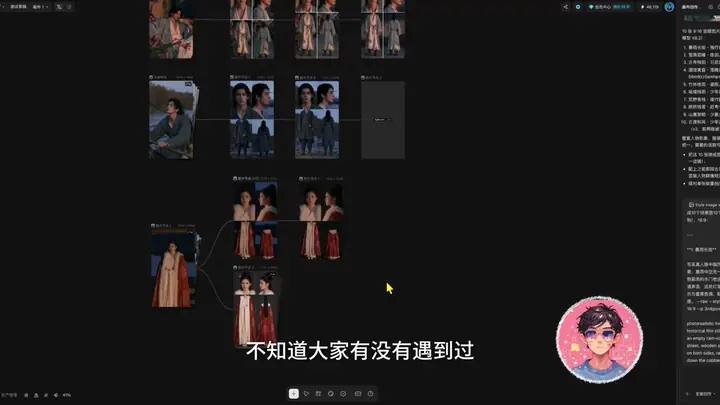
AIGC 圈圈作者 @fakeWow_ 分享如何在改图后尽量保住 Midjourney 生成的角色底图质感,附提示词。他指出用 GPT Image 2 或 Nano Banana 系列改图后,Midjourney 原本的角色质感会损失,并实测了不同质感下生成视频的效果差异。
用 GPT Image 2 或 Nano Banana 改图后 Midjourney 的角色质感总掉,这条给了提示词和不同质感下的出视频效果对比,做角色一致性的视觉师可以照着试。
点击打开原平台查看,能否访问取决于网络环境
05
Tripo
Tripo 官方发布博客,介绍用 GPT-6 Astra + Tripo + Unreal Engine MCP 批量生成 3D 资产、组装成 UE5 中可游玩中世纪城市的完整工作流,并附上博客链接。对做虚拟制片、场景概念设计和 3D 预演的创作者来说,这套「批量出资产再拼场景」的做法有参考价值,可对照自己的场景搭建流程看能否复用。
Tripo 官方放出完整工作流:GPT-6 Astra 加 Tripo 加 UE5 MCP,批量生成 3D 资产拼出一座可游玩的中世纪城市。做虚拟制片、场景概念和 3D 预演的可以拆一遍这套批量出资产的流程。
06
@CharaspowerAI
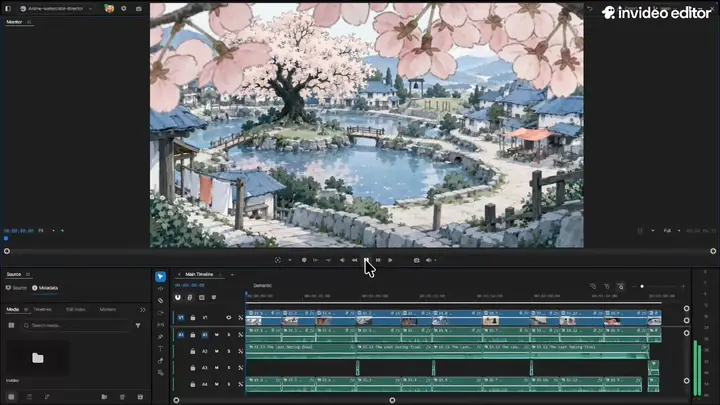
创作者 @CharaspowerAI 把自己剪好的 4 分钟电影感预告片交给 invideo Editor,要求把声音设计提升一个层级。原片已自带配乐、环境音和音效,但作者指出 4 分钟体量的项目里有几百个细碎节点,声音处理会直接改变画面冲击力。这条是创作者对 AI 音频工具的实际使用分享,附有视频链接。
4 分钟片子里几百个声音细节,作者把成片丢给 invideo Editor 做音效升级,做后期的可以看看 AI 补声音设计到什么程度。
点击打开原平台查看,能否访问取决于网络环境
07
OpenAI Blog
OpenAI 官博介绍客户案例:Parallel 的 agent 借助 GPT-6 Astra 研究和综合劳动力市场数据,相比此前使用的模型,耗时和成本均减半(该产品 9 月 4 日已发布)。这是官方口径的效率对比,对做 AI 调研、资料汇总类自动化流程的团队,可作为一个降本参考样本。
OpenAI 官博的客户故事:Parallel 的 agent 用 GPT-6 Astra 做劳动力市场数据研究,时间和成本都砍半(该产品 9 月 4 日已发布)。做 AI 调研/资料整理类工作流的可以看看这个降本样本。
点击打开原文
08
Luma AI Blog
Luma AI 官方博客发布 AI 打光提示词专题,按黄金时刻、硬光、实景光源(practicals)、霓虹四类光线风格整理提示词写法,面向 AI 图像/视频生成中的光线控制场景。原文仅给出标题,未展开具体提示词文本与示例图。做视觉开发和分镜的可以按这四类光线建立自己的打光词库,跑图时逐类对比出片效果。
Luma 官方博客把黄金时刻、硬光、实景光源、霓虹四类打光写成提示词模板,做视觉和分镜的可以存下来当打光词库用。
09
@nakazakifam
日本创作者 @nakazakifam 分享用 AI 数字人制作并自动剪辑的解说视频流程:头像原图用 GPT-Image-2.5,唇形同步用 LTX 2.3 LipSync,转写与时间戳用 Soniox v5,配乐音效用 Epidemic Sound,剪辑由 GPT-5.6 Sol 配合 Remotion 完成,运行环境为 Google Colab 与 Codex。作者自评想做出科技类 YouTuber 的高级感,但目前效果仍有差距,冲击力和趣味性不足,认为内容扎实或许可以弥补。
一条把 AI 数字人、唇形同步、自动转写、自动剪辑串成完整流程的实测分享,做口播号和知识类视频的可以照着搭一遍,看自己那条流程卡在哪一步。
10
@ClaudeDevs
Claude Devs 发布 Opus 5.5 首次会话使用建议:把整个任务一次性交出去并定义「完成」标准和汇报节点;不必再写「think carefully」,因为模型总是先思考;长任务运行后询问它继续推进还需要什么。完整 playbook 发布在 claude.dev 博客。属于提示词写法层面的官方经验,不涉及新模型或新功能发布。
官方给了三条上手建议:整块任务直接交出去、别写 think carefully、长任务跑完问它还需要什么。用 Claude 写剧本大纲或做资料整理的可以照着调一遍提示词。
点击打开原文
11
@MinLiBuilds
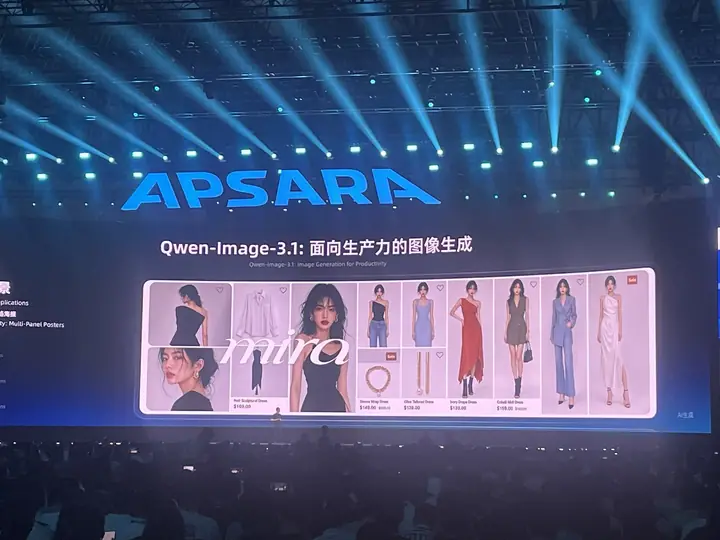
推主 @MinLiBuilds 发帖称「我们吃了两天的 qwen image 2.1 只是个前菜」,并引用自己 9 月 21 日的推文,暗示后面还有更大的发布,但正文未说明具体是什么产品、什么时间上线。
只有一句悬念,没说是哪个模型、什么时候上,做视觉的可以先记着这个账号,等真东西出来再看。
点击打开原文,能否访问取决于网络环境