01
@alibaba_cloud
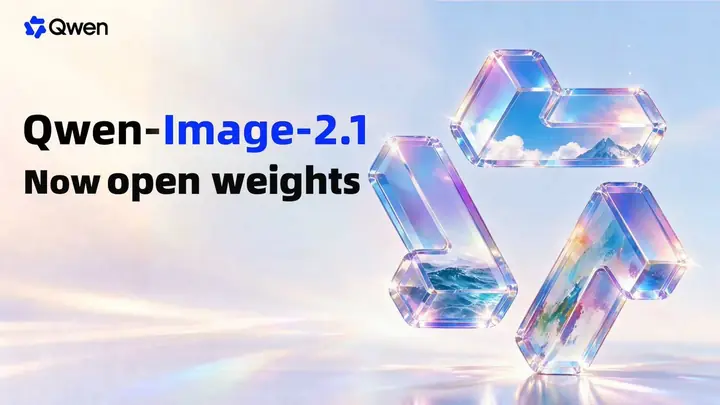
阿里云 Qwen 团队官方介绍 Qwen-Image-2.1 图像生成模型并开放权重(该产品 9 月 21 日已发布),定位 Qwen-Image 系列中最均衡、高性价比的版本,统一支持生成与编辑。7B 轻量架构,多图输入推理速度大幅提升;原生生成和编辑 RGBA 透明图层,可在透明图上直接合成与改字;支持最多 10 张参考图并做精确局部控制,人像与产品保真度高;覆盖全景图、信息图、虚拟试穿等场景。权重已在 Hugging Face、ModelScope 和 GitHub 开放。
7B 轻量架构统一生成与编辑,原生出 RGBA 透明图层,最多吃 10 张参考图还能锁住人像和产品细节。做视觉开发和电商图的这周可以拉下来跑一遍,透明图层合成和虚拟试穿是能直接进流程的能力。
点击打开原文,能否访问取决于网络环境
02
@BytePlusGlobal
BytePlus 发布企业级 AIGC 平台 Dramagic,面向短剧和视频制作,流程为脚本分析→素材设置→分镜→视频预览,主打编辑级精确度、内置一致性检查和多人协作,用于制作规划、审查和规模化。做短剧的可以关注它的一致性检查和多人在线协作能否解决角色走形和团队返工问题。
字节旗下 BytePlus 出了个专做短剧的企业级平台,从剧本分析到分镜到视频预览一条流程走完,还带一致性检查和多人协作。做短剧的可以蹲一下能不能试用,重点看它的一致性检查到底管不管用。
点击打开原平台查看,能否访问取决于网络环境
03
@ViggleAI
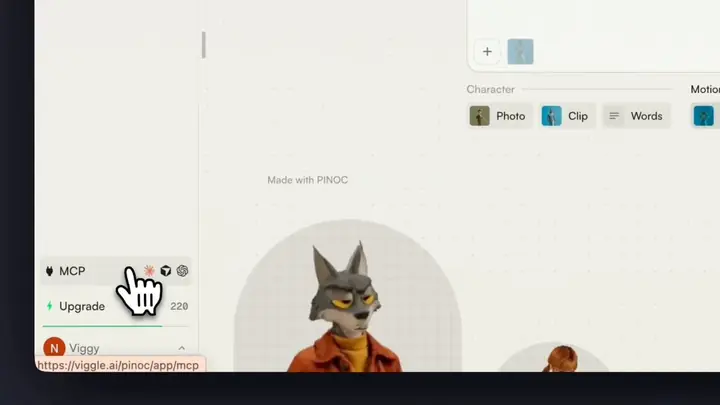
Viggle 发布 PINOC MCP,定位为面向 AI 智能体的角色动画引擎:智能体搭建游戏或 3D 场景后,可调用 PINOC 生成已绑定骨骼的动画 Gaussian splat 角色。支持文生动作、视频转 mocap、预设动作库三种方式驱动自有 mesh。引用推文称整条宣传视频(含屋顶跑酷游戏)由 GPT-6 Astra 加 PINOC MCP 制作。
Viggle 把角色动画做成 MCP 接口,智能体搭完 3D 场景能直接调它生成绑好骨骼的动画角色,做 AI 游戏和 3D 内容的可以接上试。
点击打开原平台查看,能否访问取决于网络环境
04
通义 QwenAudio
通义 QwenAudio 上线 Qwen-Audio-3.1-Realtime 产品页,同步放出技术报告预览,导航栏已链接到报告 PDF。该仓库共 3 次提交,最新一次于 9 月 21 日完成,页面包含 demo 与概览脚本。做配音、虚拟角色对话和实时字幕的团队可以先去跑页面上的 demo,听实时语音的延迟和自然度表现。
通义把实时语音模型 Qwen-Audio-3.1-Realtime 的产品页和技术报告一起放出来了,页面带 demo 和概览脚本。做 AI 配音、虚拟角色对话、实时字幕的可以先去跑 demo 听延迟和自然度。
点击打开原文
05
xAI
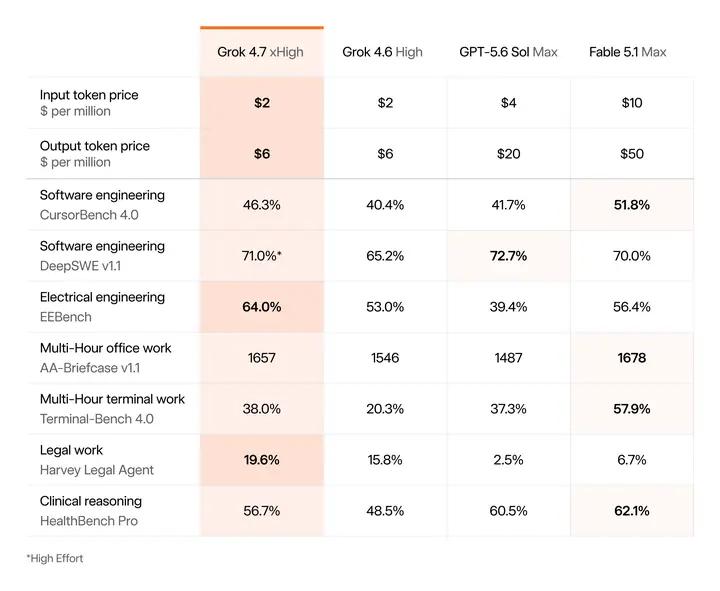
xAI 发布 Grok 4.7,官方定位为其最强编码与知识工作模型,定价 $2/百万输入 token、$6/百万输出 token,与 Grok 4.6 同价同速,另提供速度和价格加倍的快速变体。该模型面向代码生成与知识处理场景,对 AIGC 创作者而言,它更接近后台脚本与自动化流程的候选模型,而非直接产出画面的工具。
xAI 新模型定位编码和知识工作,$2/$6 每百万 token 与上代同价同速,另有加价加速版。做 Agent 自动化和批量脚本的可以接 API 测一轮,看写代码和长文档处理稳不稳。
点击打开原文,能否访问取决于网络环境
06
@OpenRouter
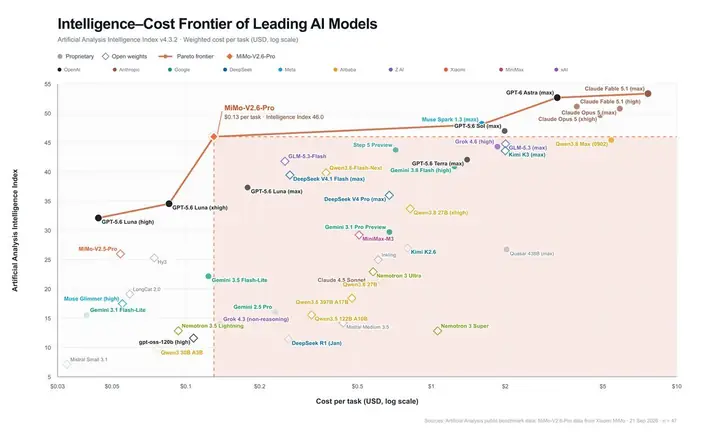
小米 MiMo-V2.6 系列三款模型上线 OpenRouter:1T+ 参数旗舰、开源 MoE 模型、以及约 10 倍速的旗舰变体。三款均支持文本、图像、视频、音频输入,上下文长度 1M。对做多模态素材处理和长上下文工作流的团队来说,多了一个可接入的模型选项,具体生成质量和速度表现需自行实测。
1T+ 参数旗舰、开源 MoE、约 10 倍速变体三款齐发,都吃文本图像视频音频、1M 上下文。做多模态工作流和 Agent 的可以接 API 跑一周,看长上下文处理素材的实际表现。
点击打开原文,能否访问取决于网络环境
07
@TungaBayrak
Freya 团队发布 Adam 和 Eve 两款 AI 语音,官方称是迄今最像人声的模型,其中 Adam 在 DesignArena 的 AudioRealismBench 榜单上位列 AI 模型第一,团队称已跨过恐怖谷。官网 freyavoice.ai 已开放 API 调用,榜单地址 designarena.ai/leaderboard/audiorealismbench。适用于配音、虚拟角色对白、旁白等场景。
Freya 放出 Adam 和 Eve 两款语音,Adam 在 DesignArena 的 AudioRealismBench 上排到 AI 模型第一,官网已开 API。做 AI 配音、虚拟角色对白的后期和短剧团队可以接上去试听一轮。
点击打开原平台查看,能否访问取决于网络环境
08
@MeshyAI
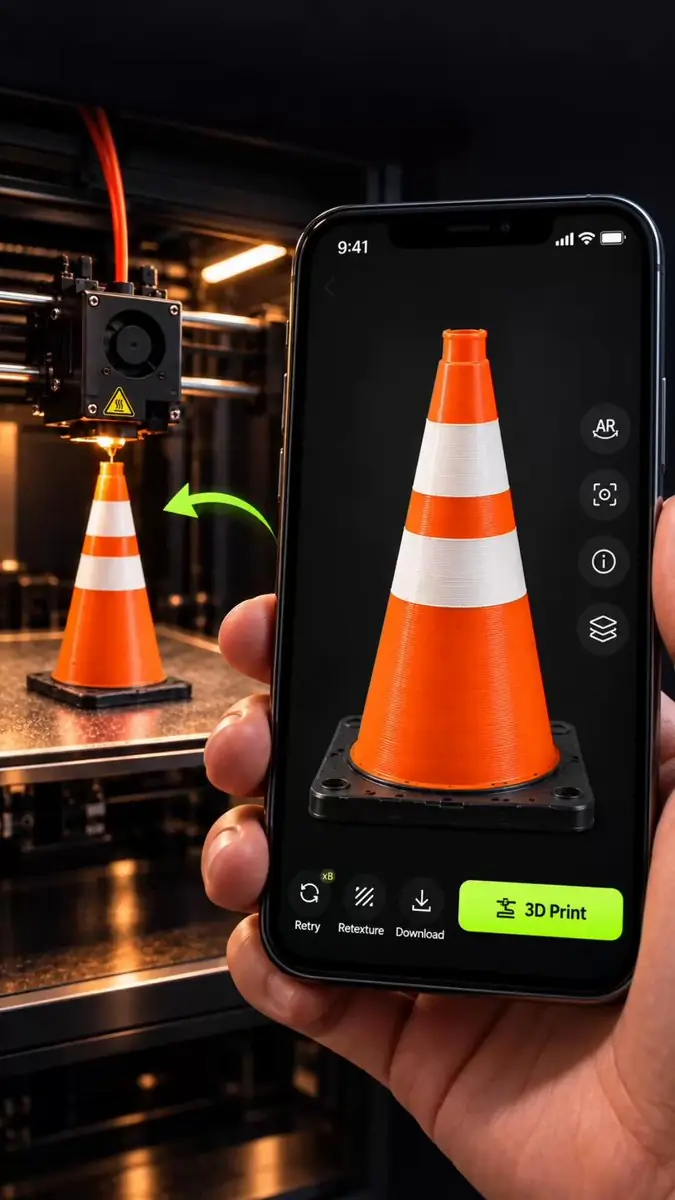
Meshy 官方宣布 Meshy 应用上线手机端,用户拍下照片即可在几秒内生成 3D 模型。官方以路边交通锥为例,称早上在人行道拍的照片已在桌面打印出来,并邀请用户下载 Meshy 应用体验。对做美术资产、道具概念和实体手办的创作者来说,手机拍照直接出模型省掉了建模起步环节,可实测生成精度和可打印性。
手机拍张照几秒出 3D 模型,官方拿路边交通锥举例,说早上拍的已经打印到桌面。做美术资产、道具概念和实体手办的可以下载试一轮,看生成精度够不够用。
点击打开原平台查看,能否访问取决于网络环境
09
OpenAI Blog
OpenAI 官方博客宣布,正与一个独立的「数学与人工智能顾问组」合作,由该小组指导新兴 AI 成果的审阅与对外沟通工作。这是 OpenAI 在 AI 研究成果发布流程上的治理安排,与视频生成、图像创作、剪辑配音等创作工具链无直接关联。
当天有 4 家独立信源在报同一件事,属于行业动向本身。对具体创作流程没有直接用处,但这个量级的消息值得知道。
点击打开原文
01
@aiaicreate
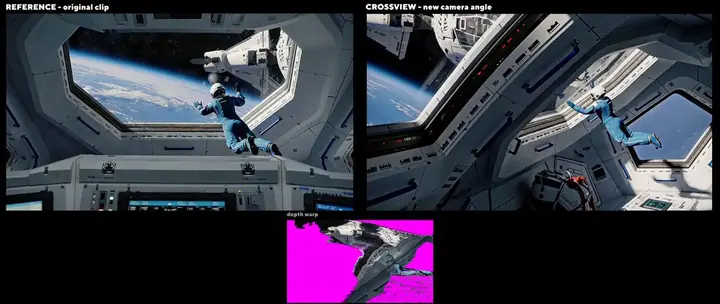
社区作者 @aiaicreate 公开 MiniMax H3 用 LoRA「CrossView-Warp」,可更改现有视频的摄像手法,配套 ComfyUI 使用,MiniMax Design 官方账号转帖。发布后引发热议,多数评价称赞功能强力,也有部分人认为提示词本身已足够。
给已经拍好的片子换运镜,这个 LoRA 直接改摄像机运动,做后期和分镜的可以拿旧素材跑一遍看能不能救回废镜头。该产品的发布我们已在 2026-08-01 报过,这条是官方对已有能力的介绍,不是新上线。
点击打开原平台查看,能否访问取决于网络环境
02
@Stefan_3D_AI
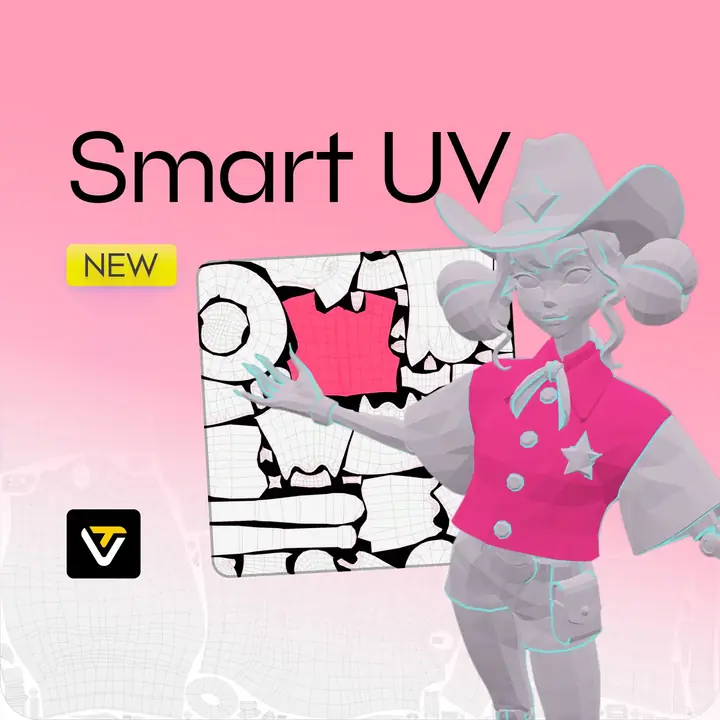
Stefan 3D AI 与 Philipp Sieben 合录的本周 3D AI 新闻拆解:Tripo P2.0 Smart UV 实现自动展 UV 并生成干净接缝,称这是 3D AI 此前唯一没攻下的环节;Meshy 7.1 Ultra 4K 几何精度达 4096³、最高 8000 万三角面,缝合线和雕刻是真实网格而非贴图绘制;GPT-6 Astra 可自行驱动 Blender 与 Unreal,完成建模、绑骨、动画并搭建可行走场景。另含 Hunyuan Miora、Hitem3D Agent 及四篇论文,其中一篇直接取消 UV。
Tripo P2.0 自动展 UV、Meshy 7.1 上 4K 八千万面、GPT-6 Astra 自己驱动 Blender 和 UE 建模绑骨搭场景,做 3D 资产和虚拟制片的可以听这期拆解。
点击打开原平台查看,能否访问取决于网络环境
03
@LumaLabsAI
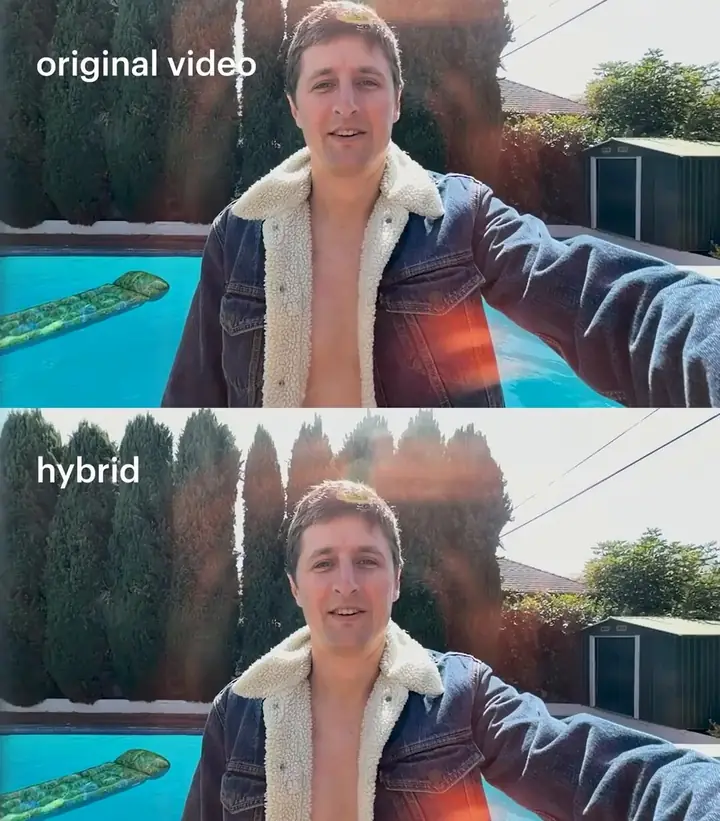
Luma AI 官方发布一条演示,主题是用混合制作(hybrid production)处理水下拍摄:水下布景搭建成本高,绿幕打光在水下还有额外难题,混合制作让这类镜头容易得多,成片标注 Made with Luma。原文未给出具体镜头拆解、所用模型版本或工作流细节。对需要水下镜头的广告、短剧和 MV 团队来说,这是一条可参考的实拍+生成混合思路样本。
水下布景贵、绿幕打光难,Luma 用混合制作把这块绕过去了。做广告和短剧里带水下镜头的,可以看看它怎么把实拍和生成拼在一起。
点击打开原平台查看,能否访问取决于网络环境
04
MarkTechPost
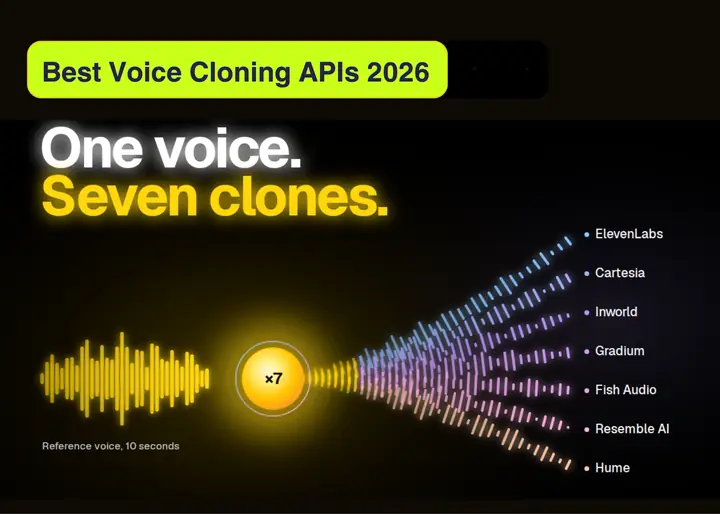
MarkTechPost 用同一段 10 秒参考音频(安静环境 WAV、两句文本,一句口语一句含数字和人名)在 ElevenLabs、Cartesia、Inworld、Gradium、Fish Audio、Resemble AI、Hume 七家平台实测语音克隆,从参考音频需求、同意验证、商业许可、语言数、每 1M 字符价格五个维度对比。Hume 官方最低要求 15 秒,ElevenLabs 建议 1-2 分钟,本次 10 秒测试低于其官方指引;Resemble AI 定价页未列 TTS 费率,第三方追踪显示 2026 年中约每秒 0.0005 美元。价格核对时间为 2026 年 9 月 20 日。
同一段 10 秒参考音频在 ElevenLabs、Cartesia、Fish Audio 等七家跑克隆,比相似度、同意校验、商用许可和每 1M 字符价格。做 AI 配音和短剧对白的,这份对比表能直接拿来选供应商。
点击打开原文
05
OpenAI Blog
OpenAI 官博发布客户故事:Higgsfield AI 借助 GPT-6 Astra,在一天内上线新的视频功能,面向小企业简化视频广告制作,并加快新创作工具推向市场的速度。对做视频广告和短剧工具链的团队来说,这条的价值在于看一家视频产品公司如何把模型能力快速转成可上线的功能,而不是拿到可直接复用的工作流。
OpenAI 官博的客户故事:Higgsfield 用 GPT-6 Astra 把新视频功能压缩到一天上线,做广告视频和短剧工具链的可以看看它怎么把开发周期压下来。
06
@kentdhani
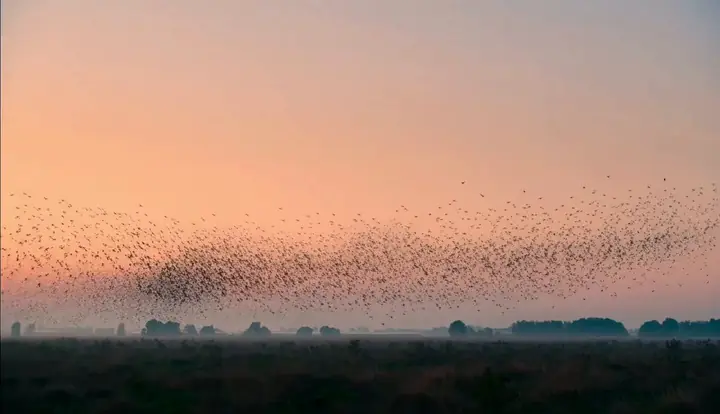
创作者 Kent Dhani 用 MiniMax H3 做压力测试,生成一千只鸟如一体般移动的鸟群镜头,重点观察队形是否保持。测试在 RTX5090 上本地运行,针对的是数百个小移动物体这类模型通常崩掉的场景——常见问题是模糊或丢失计数,作者称 H3 这次没有出现。
拿千只鸟群飞测 H3 的密集小物体处理,RTX5090 本地跑,做视觉的可以看它怎么扛住这种容易糊成一片的镜头。
点击打开原平台查看,能否访问取决于网络环境
07
@googleaidevs
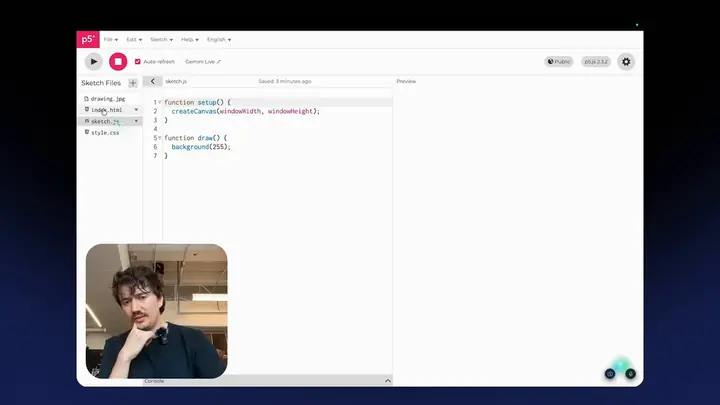
Google AI for Developers 官方演示:用 Gemini 3.8 Live Extended Thinking 构建一个编程导师,能实时看见用户屏幕,定位卡住的 bug 并直接指出问题,同时通过 function calling 引用 p5.js 库讲解代码逻辑。演示聚焦「屏幕理解 + 实时讲解 + 工具调用」的组合能力,面向编程教学场景。对做 AI 教学、实时屏幕理解或交互式讲解类应用的团队,这条展示了 Live 模型接屏幕流并联动外部库的可行做法。
Google 官方演示用 Gemini 3.8 Live Extended Thinking 做能看屏幕的编程导师,靠 function calling 调 p5.js 讲逻辑。做 AI 教学、实时屏幕理解类应用的可以拆它的实现思路。
点击打开原平台查看,能否访问取决于网络环境
08
OpenRouter
OpenRouter 官方博客的客户案例:AI 视频音频编辑平台 Descript 在开发剪辑 Agent「Underlord」时,原本维护 OpenAI、Anthropic、Google 三套直连集成并自写兜底逻辑,加一个模型要花几小时工程时间、再等几天排进工程师日程,一个模型可能压一周才知道值不值得用。改用 OpenRouter 统一接入后,评测缩短到一两小时,团队每周能多次试新模型,非工程岗也能自己发起评测。
Descript 原来接 OpenAI、Anthropic、Google 三家要自己写兜底逻辑,加个模型得排队等工程师一周;换成 OpenRouter 统一接入后一两小时就能跑完评测。自己搭工具链的团队可以看看这套接法。
点击打开原文
09
@aiwithaayat
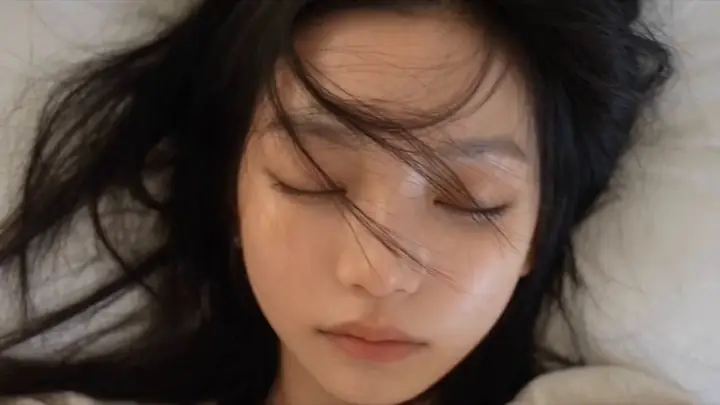
创作者 Ayat 用 Seedance 2.0 生成一段韩式晨间生活短片,并公开了完整提示词:韩籍女性角色设定(自然白皙肤色、黑长直发、柔和五官)、晨间化妆、外带咖啡、木质家具咖啡店读菜单、吃甜点、回家护肤收尾等场景,明确要求特写美妆镜头、真实手部动作、眼神交流、浅景深、暖色调、平滑运镜,输出 16:9 竖屏 30 秒、无字幕无水印。提示词把角色一致性、光线氛围和镜头节奏都写进了文本层。
一条完整的 Seedance 2.0 提示词范例,从晨间化妆、咖啡店到护肤收尾,把镜头景别、光线、色调、时长都写死了。做生活方式类短片和广告的可以拿这段当模板改。
点击打开原平台查看,能否访问取决于网络环境
10
@DDJCXX
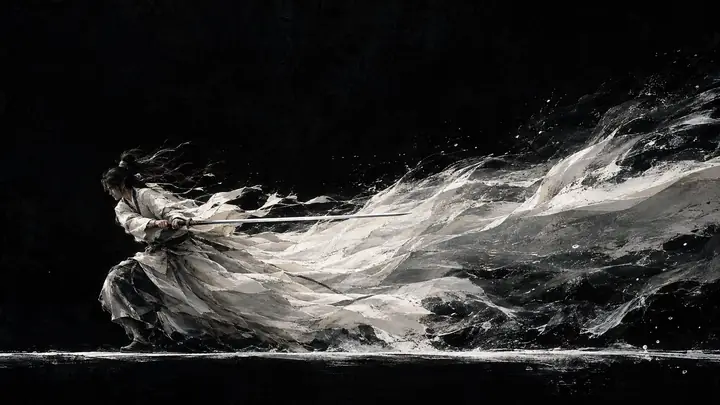
推主「硅基废话」分享中式美学第二弹的完整 prompt:16:9 超宽横构图,东方武侠概念绘画,融合中国水墨、厚涂油画、丝绸质感与干刷笔触。画面以深黑墨黑为巨大负空间,剑客置于左侧三分之一处、身形偏小,白衣长袍被高速拖向右侧形成连续白色流动结构,末端碎成墨丝、水痕与飞散颗粒,配低调高反差侧光。中英双语 prompt 全文公开。
一条可直接抄的东方武侠概念图 prompt,从构图、负空间到衣摆拖尾的材质过渡都写死了,做视觉开发和 KV 的可以存下来当模板改。
点击打开原文,能否访问取决于网络环境