01
@Alibaba_Qwen
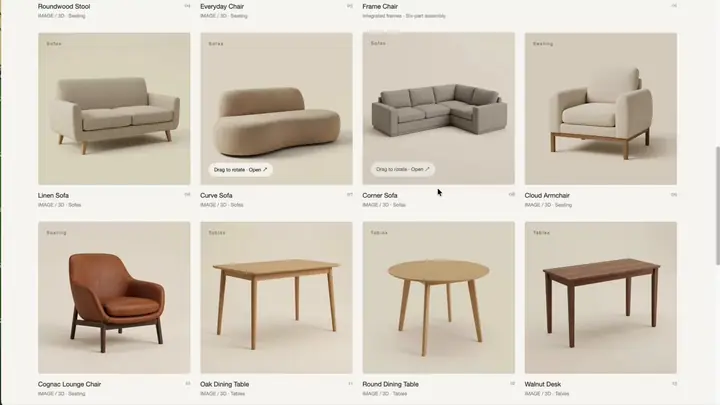
通义千问发布 Qwen-Image-2.1,Qwen-Image 系列中主打均衡与性价比的图像模型,已开放权重。7B 轻量架构,生成与编辑一体化,官方称多图输入推理速度大幅提升;原生支持生成和编辑 RGBA 透明图层,编辑最多支持 10 张参考图并做精确局部控制,人像与商品保真度较高;擅长全景图、信息图和虚拟试穿,纹理与排版表现较好。权重已在 Hugging Face、ModelScope 和 GitHub 放出。
7B 轻量架构,生成和编辑一体,原生出 RGBA 透明图层,最多吃 10 张参考图做局部精修。做海报、KV、虚拟试穿的视觉师这周可以拉下来跑一遍,透明图层这块能省掉不少抠图返工。
点击打开原文,能否访问取决于网络环境
02
公众号
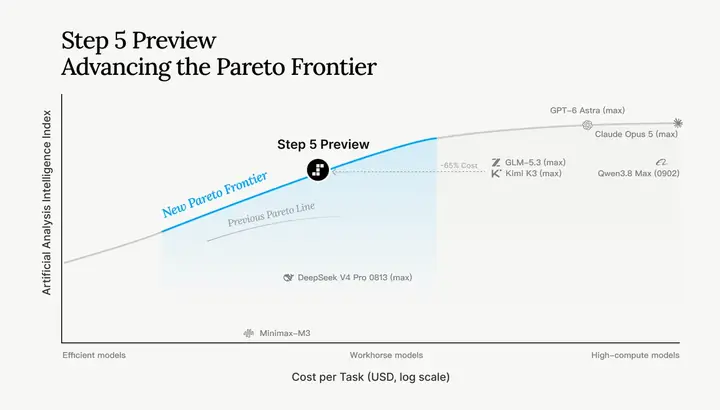
阶跃星辰发布旗舰基座模型 Step 5 Preview,稀疏 MoE 架构,总参数 600B、激活 27B,支持 100 万 Token 上下文与文本、视觉输入,Artificial Analysis Intelligence Index 得 44 分,居全球开源模型前三,单任务成本为 Claude Opus 5 的 1/8,10 月 15 日开源权重。这是基座模型发布,不直接产出图像或视频,对影视创作流程的直接帮助有限,主要价值在长文本处理和低成本推理。
600B 总参、27B 激活的稀疏 MoE,100 万 Token 上下文加视觉输入,单任务成本压到 Claude Opus 5 的 1/8,10 月 15 日开源权重。做 Agent 和长文本处理的可以等权重落地后接进来跑成本账。
点击打开原文,能否访问取决于网络环境
03
@hq4ai
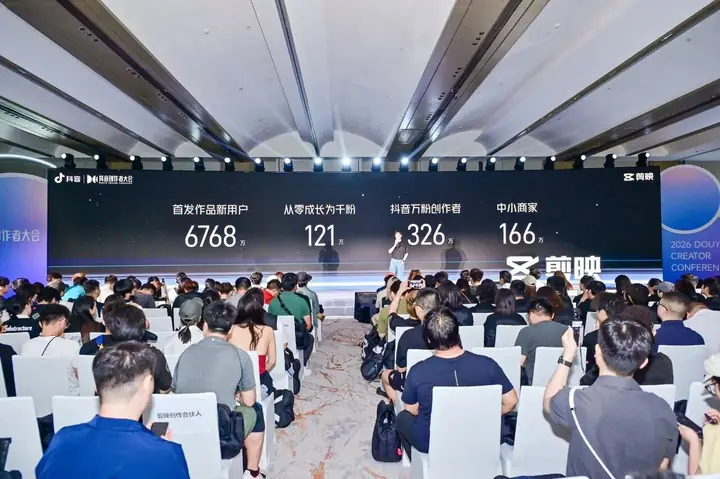
剪映在创作者大会现场发布剪映 Hub,由无限画布与多轨道编辑器构成,可从一句话、一个参考视频或一份文档出发,整合即梦、小云雀等平台生成的资产;同步上线 AI Ultra 会员,把 AI 创作积分与剪映 SVIP 专业剪辑权益并入同一订阅。另推出 AI Agent「小映」,从创作热点到决策给出建议。
剪映把无限画布、多轨剪辑和即梦等平台的生成资产塞进同一个工作台,还上了积分与 SVIP 合并的 AI Ultra 会员。做短剧和批量出片的团队值得跑一遍,看能不能省掉来回导素材那一步。
点击打开原文,能否访问取决于网络环境
04
AIHOT 全部动态
据 @mark_k 消息,Google DeepMind 的 Nano Banana 2.5(代号 spicy-mayo)已部署,计划下周发布。合作伙伴已通过 Vertex 获得访问权限,模型名 nano-banana-2.5,支持 minimal、medium、high 三档思考等级,图像尺寸覆盖 512、1K、2K、4K。
Google 图像模型 Nano Banana 2.5 已部署待发,支持 512 到 4K 尺寸和三档思考等级,做视觉开发和 KV 的可以盯住下周上线,第一时间测角色一致性和出图分辨率。
点击打开原文,能否访问取决于网络环境
05
@xiaohu
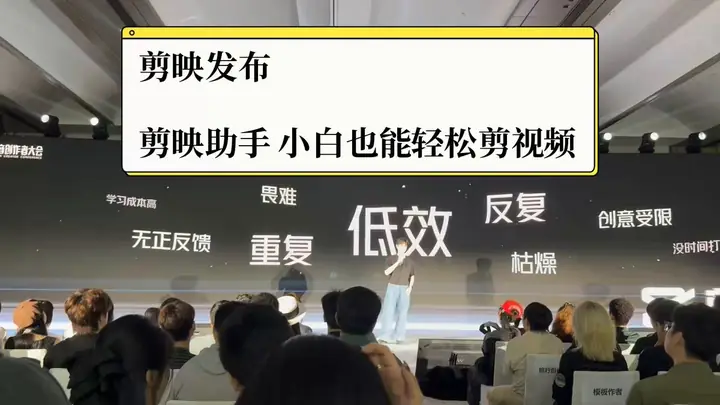
剪映发布「剪映助手」,支持通过自然语言描述来剪辑视频,即用文字指令驱动剪辑操作。该条为第三方账号 @小互 的转述,未给出具体功能范围、支持的指令类型或上线平台。对做后期和短剧批量生产的团队来说,如果自然语言能直接落到时间线操作上,粗剪、套模板、批量出片这类重复环节有机会压缩人力。
剪映把剪辑入口改成自然语言描述,做后期的可以上手试一周,看口播粗剪、批量套模板这类重复活能不能真省下来。
点击打开原平台查看,能否访问取决于网络环境
06
@alibaba_cloud
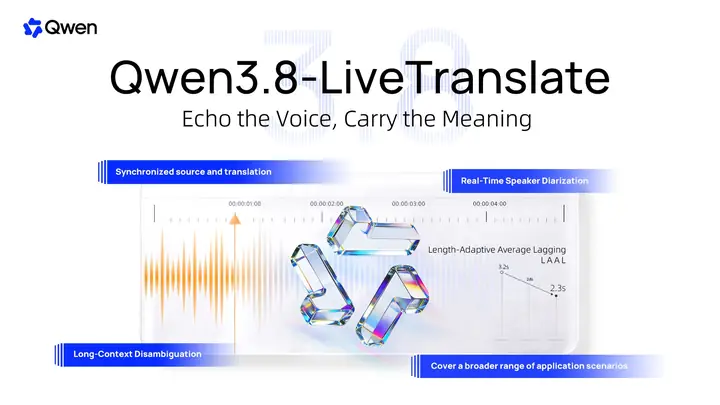
阿里云通义官方介绍新一代实时同声传译模型 Qwen3.8-LiveTranslate(该产品 9 月 20 日已发布),采用 Interleave 架构,在 60 种语言上把平均延迟 LAAL 从 2.8s 降到 2.3s,同时提升忠实度、流畅度和简洁性。新增能力包括实时说话人分离并配合更稳定的音色克隆、源文与译文同屏双语显示、以及利用对话历史对人名和术语做长上下文消歧。已可通过 Qwen Cloud 和 Model Studio 试用。
60 种语言平均延迟从 2.8s 压到 2.3s,还带实时说话人分离和音色克隆,做海外短剧配音、双语字幕、直播同传的可以接 API 跑一周看效果。
点击打开原文,能否访问取决于网络环境
07
The Decoder
腾讯混元语音团队联合多所高校发布 Gander 模型,架构上分两层:"小脑"负责实时对话,可替换的"大脑"处理后台智能体任务,测试中后台用的是 GPT-5.6 家族模型。模型可同时处理语音、图像和文本,对话过程中随时可被打断。
腾讯混元语音团队联合高校发的 Gander,把实时对话和后台智能体任务拆成"小脑+大脑"两层,对话随时能被打断。做虚拟角色对话、AI 客服式交互的可以盯一下这套架构。
点击打开原文
08
公众号
百度在超级智能体大会深圳站发布百度搭子开发平台与生态开放平台,升级企业版并新增移动端和多人协作。开发平台通过 Agent API 开放智能体配置、工具与技能配置及运行能力,支持公有云、VPC 专属部署和本地私有化。官方称用户规模环比增长 9 倍、交付物增长 4.3 倍、专家套件使用量增长 7.3 倍。
百度把智能体配置、工具技能和运行能力通过 Agent API 开放,支持公有云、VPC 和本地私有化部署,做团队内部流程自动化的技术整合者可以看看能不能接进自己那套流程。
09
@Gorden_Sun
网易有道开源实时语音转文字模型 Confucius4-R2T2,主打低延迟实时转录:从听到声音到文字上屏平均延迟 200-600 毫秒,出字节奏可在 80 毫秒到 2 秒之间调节;文字输出后直接固定、只往后追加,不再回头涂改,解决实时字幕跳字问题;支持预设热词以精准识别人名、品牌名和行业术语,重点优化中英文,同时支持日、韩、法、德、俄等多语种,模型已在 Hugging Face 开放下载。适合会议实时字幕、语音输入法、同声传译等场景。
字幕不再跳字回改,出字后直接固定只往后加,延迟 200-600 毫秒可调,做实时字幕和配音对轨的后期可以接来跑一遍。
点击打开原平台查看,能否访问取决于网络环境
01
The Decoder
Runway 公布实时视频生成研究:用户在描述提示词的同时视频即开始流式生成,而非输入后等待成品。方案基于其首个 General World Model GWM-1(构建于 Gen-4.5 之上,逐帧生成,支持镜头运动、机器人指令或音频控制),通过用自身输出训练模型抑制误差累积。Runway 称用户反馈最耗时的是反复生成与修改,目标是压缩到首帧的时间;实时生成还能减少 GPU 占用、降低成本。该思路最早在 3 月的 Runway Characters 中提出,GWM-1 于 2025 年 12 月推出。
输入提示词的同时画面就开始流式生成,不用等成品再返工。做分镜预演和短剧快节奏出片的,可以盯一下这套 GWM-1 逐帧生成的路子。
点击打开原文
02
@magnific
Magnific 官方发布案例:Wonder Project 为《House of David》第二季制作 AI 生成素材,要求能与实拍画面剪在一起而不出戏。做法是把该剧实际拍摄的画面帧作为参考,用 Magnific 把剧集既有的视觉语言迁移到 AI 生成素材上。对做剧集级混合制作的团队来说,这是「实拍帧当风格参考」这一思路的公开样本。
剧集实拍和 AI 生成素材混剪的实战案例,视觉师可以看它怎么用实拍帧当参考统一风格,做长剧集混合制作的值得拆一遍。
点击打开原平台查看,能否访问取决于网络环境
03
@royxy
推主 @royxy 把一批碧山视频素材交给 ChatGPT,由它全自主操作剪映完成剪辑,自己分析素材、加文字和音乐,产出一条约三分钟的导览视频。作者自评「流程是能跑通的」,成片质量未做评价。对后期和短剧团队来说,这是 AI 直接操控剪辑软件完成从素材到成片的实测样本,可关注其自动化程度与成片可用性。
把一堆素材丢给 ChatGPT,它自己分析、配字、配乐,直接操作剪映出了条三分钟导览片。做后期和批量剪辑的可以看看这条路走不走得通。
点击打开原平台查看,能否访问取决于网络环境
04
公众号
MiniMax 官方披露六项全球合作案例,其中 Genspark 基于 MiniMax M3 开放权重做后训练,产出 PPT 专用模型 Gen-1 Slides,并成为其 AI Slides 标准模式的默认模型;在 200 个真实生产任务评测中,Gen-1 Slides 的综合得分与视觉设计得分均列五个参测模型第一,单份生成成本为 Claude Opus 5 的十分之一。其余合作方包括 HUMAIN 与 Nebius。
MiniMax 官方披露六项全球合作,其中 Genspark 用 M3 开放权重后训练出 PPT 专用模型 Gen-1 Slides,200 个真实任务评测综合与视觉设计双第一,单份成本只有 Claude Opus 5 的十分之一。做 AI 制片和工具选型的可以看这份成本账。
05
@PixVerse
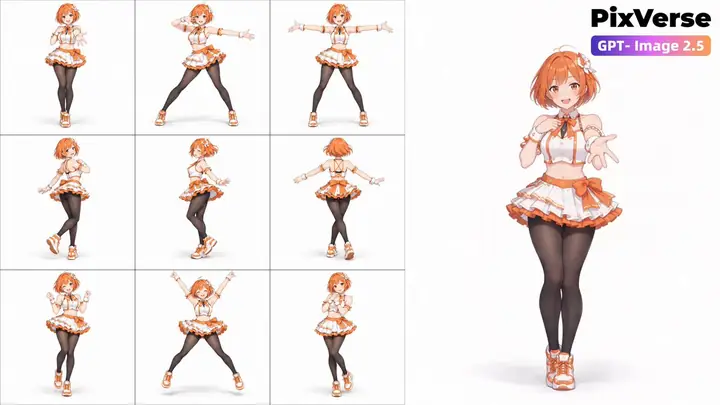
PixVerse 官方账号演示:用 GPT-Image 2.5 生成 4×4 sprite sheets(像素画精灵图),再在 PixVerse 平台上用 Seedance 2.5 把静态精灵图做成动画。推文同时宣传 PixVerse 上可无限使用 GPT-Image 2.5。像素风游戏美术、复古动画方向的创作者可参考这套「出图—动画」的两步做法。
PixVerse 官方演示:GPT-Image 2.5 出 4×4 sprite sheet,再用 Seedance 2.5 在 PixVerse 上做成动画。做像素风游戏美术和复古动画的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
06
@PixVerse
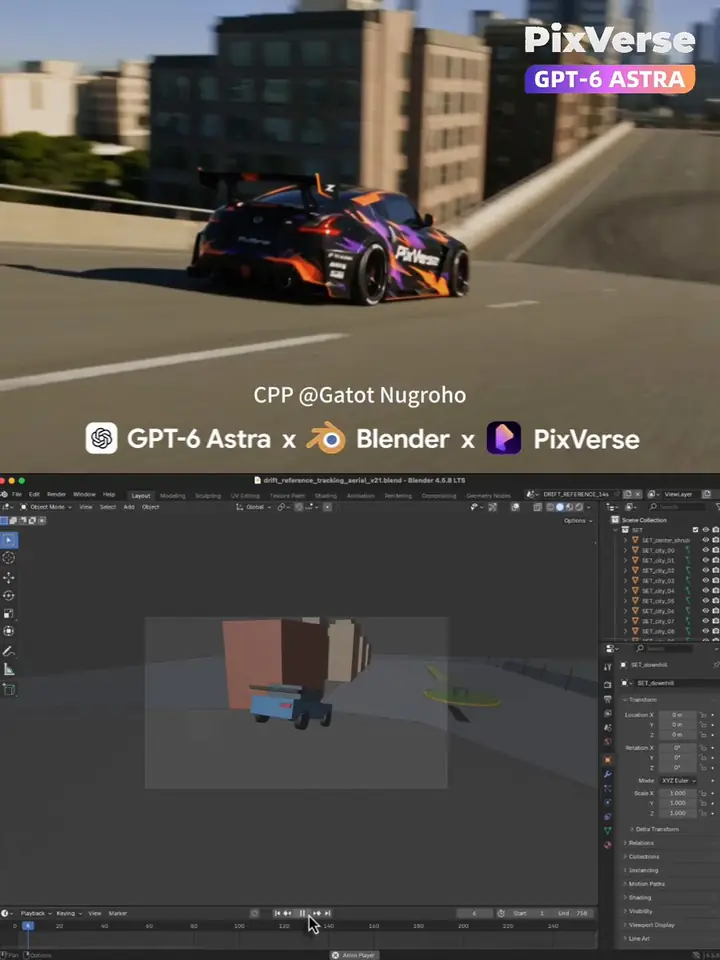
PixVerse 官方账号转发其平台创作者 @Gatot Nugroho 的作品:一段漂移镜头,制作工具为 GPT-6 Astra 加 Blender,作者在推文中公开了完整提示词。画面主打漂移的真实感,官方配文强调「没人需要坐到方向盘后面」。对做汽车广告、动作场面和车戏的视觉师来说,这条的价值在于提示词公开,可以照着复现看这套工具组合的出片稳定性。
漂移镜头的真实感是看点,作者公开了完整提示词,做汽车广告和动作场面的视觉师可以照着跑一遍,看 GPT-6 Astra 加 Blender 这套组合能不能稳定出车戏。
点击打开原平台查看,能否访问取决于网络环境
07
@PixVerse
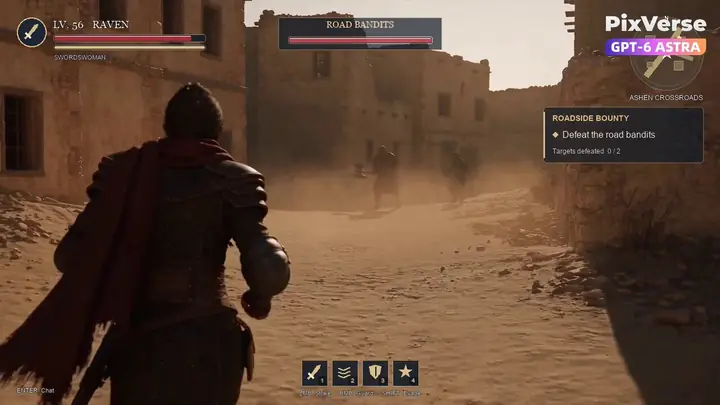
PixVerse 官方账号发布一段奇幻 RPG 风格的伏击场景演示:日落时分的尘土小路,画面中加入两个强盗角色,官方称用 PixVerse 制作并公开了完整提示词。属于厂商自发的场景能力展示,题材偏奇幻动作向,可参考其场景氛围与角色入画的处理方式。
官方放出的场景演示,日落尘土小路加两个强盗的伏击桥段,附完整提示词,做奇幻题材和动作分镜的可以照着拆一遍提示词结构。
点击打开原平台查看,能否访问取决于网络环境
08
Tripo
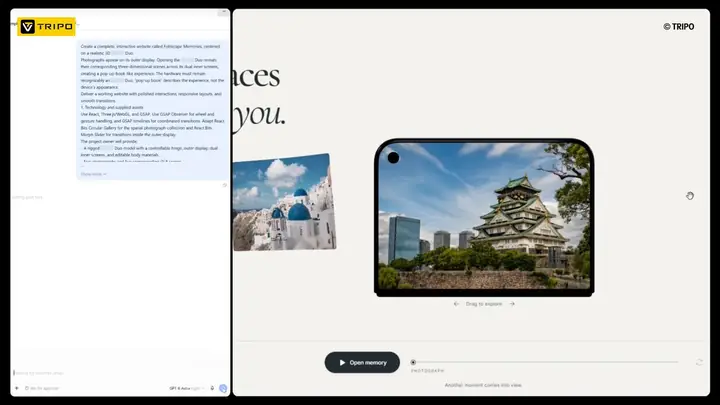
Tripo 官方展示了一个浏览器内的虚拟 iPhone Duo 体验:从一张平面 2D 旅行照片出发,生成完全可交互的 3D 弹出式场景。技术分工是 Tripo 生成核心 3D 模型,GPT-6 Astra 负责基础网格、材质和 WebGL 交互,官方称链接和提示词在推文下方。
Tripo 出 3D 模型、GPT-6 Astra 管网格材质和 WebGL 交互,把一张旅行照变成浏览器里能点能转的 3D 弹窗。做互动影像和空间叙事的可以拆一下这套组合。
点击打开原平台查看,能否访问取决于网络环境
09
@magnific
Magnific 公开了其开场视频所用的 prompt 与 VERA 角色表:prompt 要求生成一段 5 秒写实时尚拼贴视频,并附上角色表以在全部视角中保持同一人物、脸、服装和配饰完全一致。这是角色一致性工作流的一个可直接复用的写法样本,做角色 IP、时尚向短片和系列化内容的创作者可以拿角色表 + 一致性 prompt 的组合套进自己的流程试跑。
官方放出了开场视频用的 prompt 和 VERA 角色表,核心是用角色表锁住人物、脸、服装在所有镜头里一致,做角色 IP 和时尚向短片的可以照着改一版。
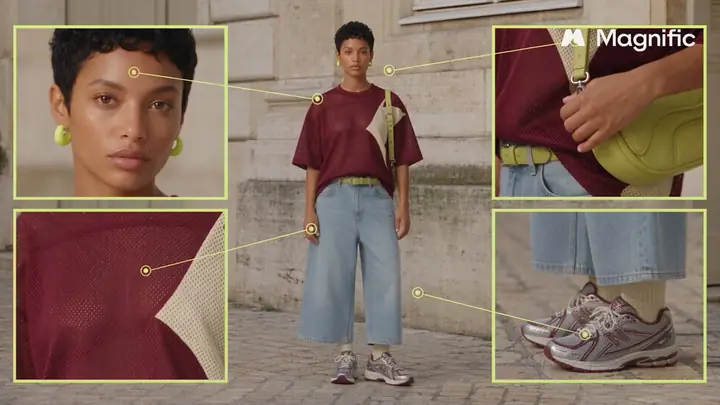
点击打开原平台查看,能否访问取决于网络环境
10
@karyabangjumawa
创作者 @karyabangjumawa 用 PixVerse 制作、并对比 Seedance 2.0 与 2.5 的动作测试片段「BLACKOUT」:早期 2.0 结果偏 3D 动画感,部分 2.5 尝试保留了 Blender 教程式的原始对象,本该代表人的移动方块直接变成了成品角色。作者复盘问题部分出在自己——动作调度含糊、物理交互不清、参考图权重给得太高,随后围绕「可读的动作与反应」重写指导,明确人物接触点和环境反馈。作者强调多次尝试间改了多个变量,无法把早期失败归因于单一设置或 Seedance。
同一份动作指导喂给两个模型,出片差距被逐条拆开讲,做动作戏和打斗镜头的视觉师可以对着这份对比调自己的提示词写法。
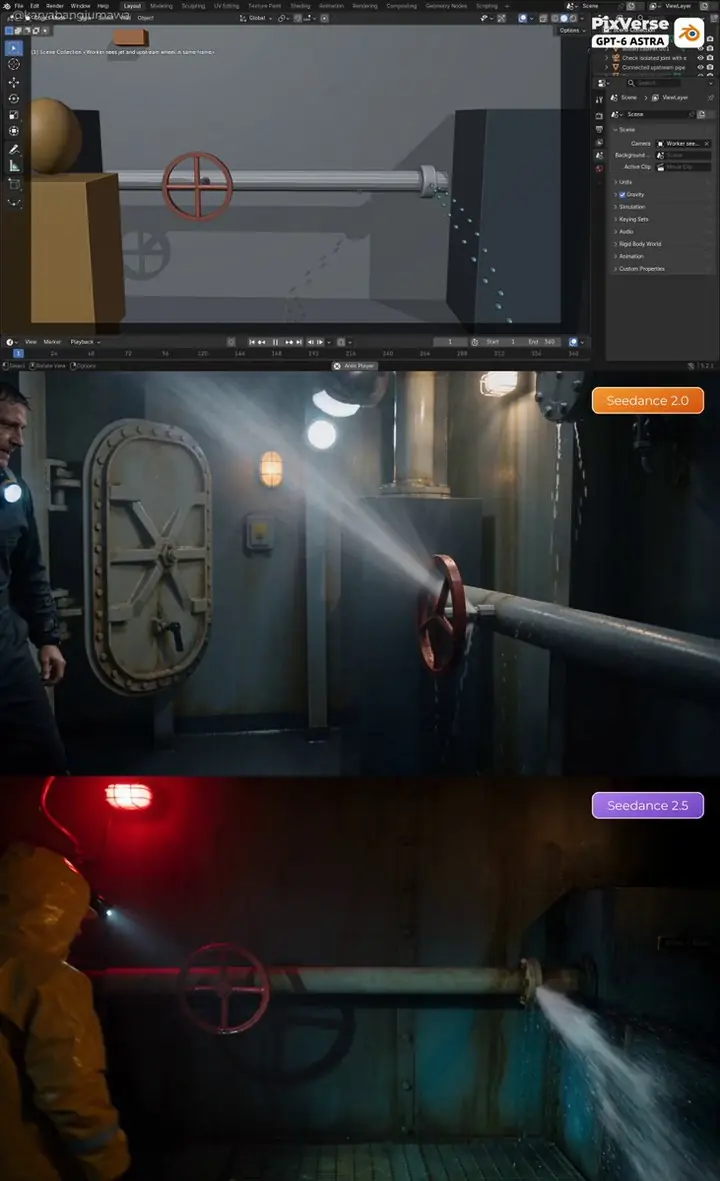
点击打开原平台查看,能否访问取决于网络环境