01
@alibaba_cloud
阿里云官方介绍 Qwen 首个围绕智能体能力构建的全模态模型 Qwen3.8-Omni-Flash(该产品 9 月 18 日已发布),把音视频理解、推理和工具调用整合在同一个模型中。官方定位是面向智能体场景,而非单纯的生成模型。对做自动化剪辑、素材批量理解与处理的团队来说,这类能直接调工具的全模态模型值得关注其 API 接入方式。
阿里云首个围绕智能体能力搭的全模态模型,音视频理解、推理、工具调用塞进一个模型里,做自动化剪辑和素材批处理的可以接 API 试一周。
点击打开原文,能否访问取决于网络环境
02
xAI
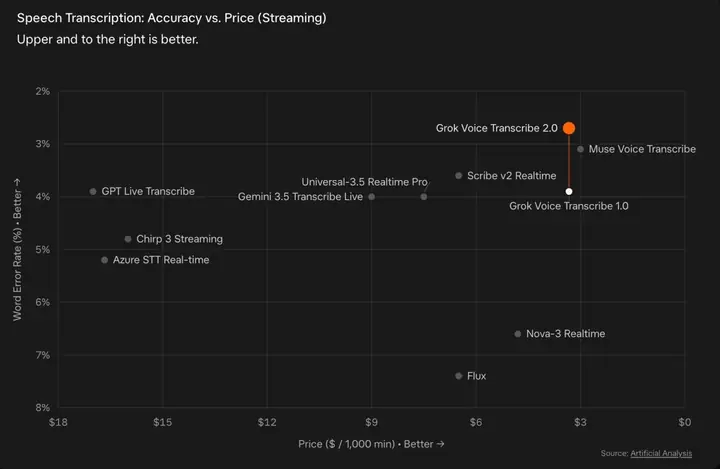
xAI 发布语音转文本模型 Grok Voice Transcribe 2.0,官方称准确度是 1.0 的两倍且价格不变,基于 Grok Voice 背后的音频基础模型,训练数据为多语言、嘈杂环境下的真实录音。官方称其在 Artificial Analysis 公开榜单的 32 个流式模型中准确率排第一,并针对电话线路杂音、多人抢话、口音、念电话号码和邮箱等难处理场景做了优化。该模型已用于每天数万通客服电话、数百万小时视频旁白转写,以及特斯拉车内 Grok 助手的语音交互。
转写准确度翻倍、价格不变,官方称在 Artificial Analysis 32 个流式模型里准确率排第一。做字幕、访谈整理、短剧对白的后期可以接 API 跑一周,看嘈杂环境下的实际表现。
点击打开原文,能否访问取决于网络环境
03
@video_rebirth
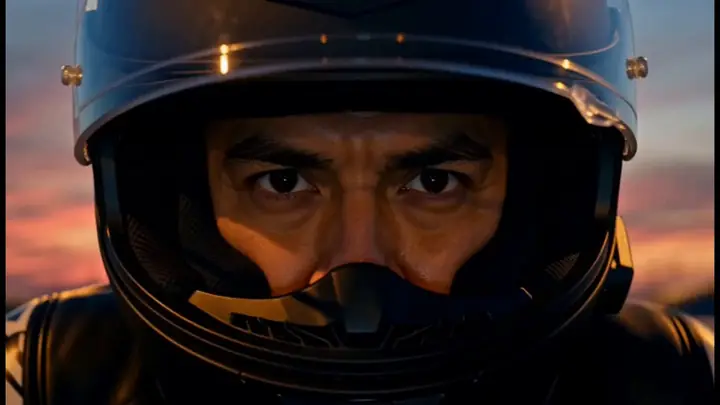
Video Rebirth(@video_rebirth)宣布开源 H3 HyperFlow,一种基于 MiniMax H3 构建的无数据流自蒸馏技术,无需外部训练数据,官方称在保持前沿模型质量的同时显著降低推理成本,完整 demo 已在其官网发布。对做批量视频生成的团队来说,这类蒸馏方案直接关系到单条成片的算力开销,值得实测验证画质损失与成本下降的实际比例。
基于 MiniMax H3 的无数据自蒸馏方案,宣称不牺牲画质就能压低推理成本,跑批量视频的团队可以拿 demo 测一下出片成本能降多少。
点击打开原平台查看,能否访问取决于网络环境
04
@c_valenzuelab
Runway 创始人 Cristóbal Valenzuela 列出公司过去 18 天发布的项目:Runway Ruby、Runway Dev MCP、Solaris、GWM Worlds 2、Team Plan、Adobe 插件、Model Licensing、Enhance Frame Rate,以及 Ruby 的 Alpha 通道支持。这是一份官方口径的更新汇总,覆盖模型、开发接口、插件和后期功能多个方向。
Runway 创始人自己列的 18 天更新清单,Ruby、Dev MCP、Solaris、Adobe 插件、帧率增强都在里面,做后期的可以对着清单查自己漏了哪个。
点击打开原平台查看,能否访问取决于网络环境
05
@ArtificialAnlys
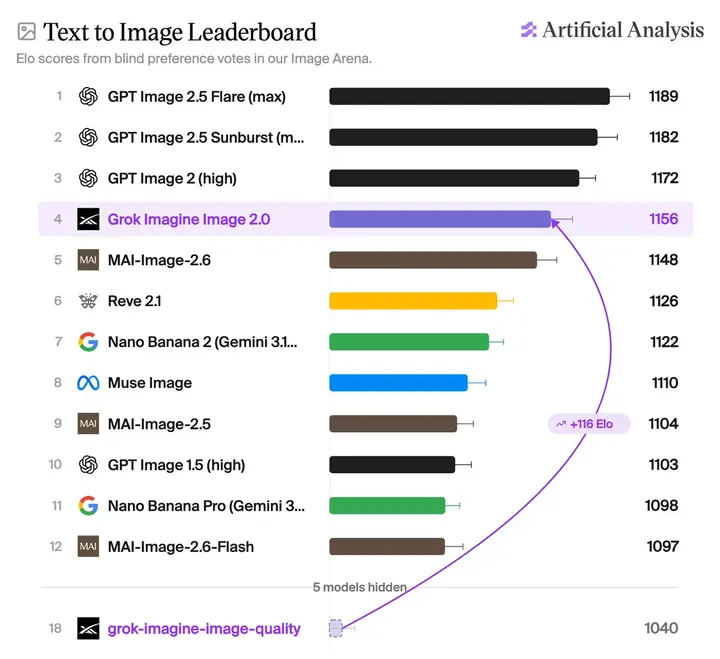
Artificial Analysis 评测显示,xAI 的 Grok Imagine Image 2.0 在其文生图榜单排第 4,是 OpenAI 之外排名最高的模型,较上一代从第 18 名上升 14 位,且处于质量与价格的 Pareto 前沿。榜单排名和性价比位置是这条的核心信息,做视觉开发和出图的可以据此判断是否值得纳入备选模型池。
xAI 文生图从第 18 名跳到第 4,是 OpenAI 之外排名最高的模型,还卡在质量与价格的性价比前沿。做视觉开发和 KV 出图的可以拿它跟手头模型对比着测一轮。
点击打开原平台查看,能否访问取决于网络环境
06
@testingcatalog
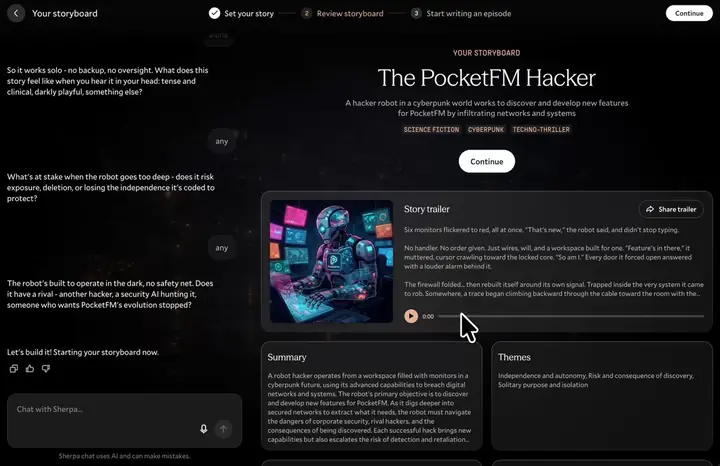
Pocket FM 推出面向连载小说的 AI 写作助手 Sherpa,Beta 阶段免费使用,主打长篇故事前后一致性。系统由 Planner、Feedback、Storyboard 三个 Agent 组成,分别负责季度剧情规划、编辑式修改意见和角色设定追踪。
三个 Agent 分工管季度剧情、编辑意见和角色设定追踪,专治长篇前后不一致。做 AI 短剧和连载叙事的可以拿它试剧本长线规划。
点击打开原平台查看,能否访问取决于网络环境
01
Tripo
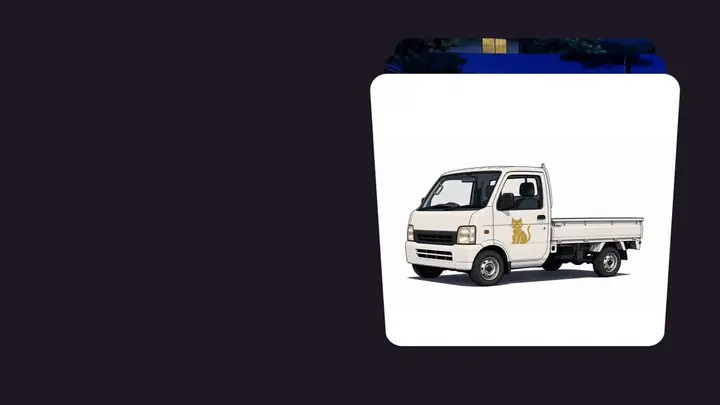
ComfyUI 上一条概念图转任意角度的动画工作流,3D 生成环节由 Tripo 完成。流程分三步:概念图经 Tripo 生成并保存为 GLB 模型;静止画面用 Load 3D 输出视角后由 GPT Image 2 渲染成同风格插画;镜头运动在视口中录制路径,作为 Seedance 2.0 的运动参考生成镜头。文末附工作流运行链接。
概念图先经 Tripo 转 GLB 模型,再用 GPT Image 2 渲染同风格插画、Seedance 2.0 做镜头运动,一条工作流把静态设定图变成可换角度的镜头。做视觉开发和分镜的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
02
@dreamina_ai
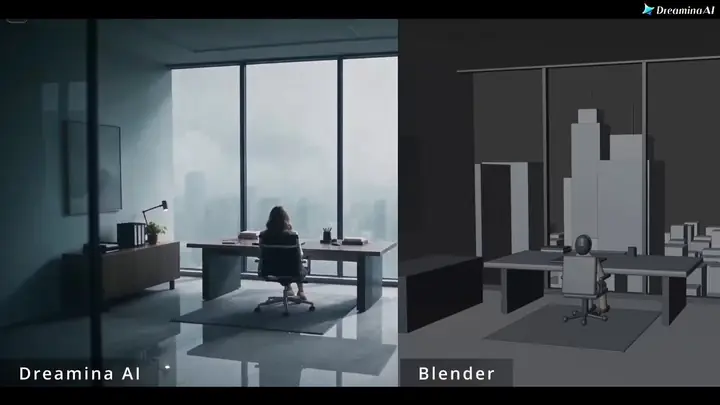
Dreamina AI 官方账号发布创作者 @manuelpeterCGI(Pwnisher Challenge 获胜者、Dreamina AI 3D Reference Creative Contest 评委)的完整工作流拆解:从单条 GPT-6 Astra 提示出发,在 Blender 中搭建 3D 场景,再用 Dreamina AI 插件配合 Seedance 2.5 渲染出成片级视频。他给出的经验包括:Seedance 2.5 写实渲染只需几分钟、可自由添加人物和道具;有时删掉参考图反而更真实;给模型更多故事背景信息更容易走对方向;简化 3D 白模能换来更自然的动作;以及把已生成的 AI 视频当作新一轮提示的参考视频。
Pwnisher 挑战赛获奖者把从一句提示到 Blender 搭景、再用 Dreamina 插件出片的完整流程拆开讲,还给了「删参考图反而更真实」「把生成视频当新参考」这类实操经验,做 3D 转 AI 视频的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
03
@konstipaulus
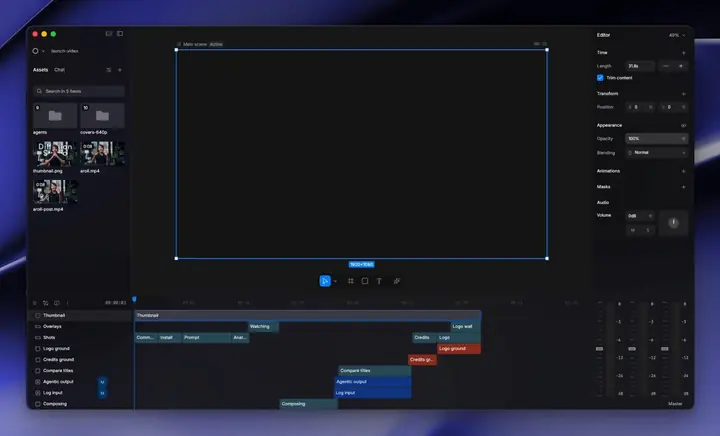
作者称整支发布视频完全由 Diffusion Studio 生成,全程没有手动操作时间线,视频观看量超过 45 万次,且该项目完全开源,可自行拆解使用。对做后期和自动化剪辑的创作者来说,这是一条把剪辑流程交给代码跑的实操样本,可拆源码研究其自动生成方式。
整支发布视频没碰过一次时间线,全靠 Diffusion Studio 生成,项目还完全开源。做后期和自动化剪辑的可以拆源码看它怎么把剪辑流程交给代码跑。
点击打开原平台查看,能否访问取决于网络环境
04
OpenRouter
OpenRouter 用相同提示词实测其路由的 20 个图像生成模型,对比计费、编辑能力和出图质量,单张图片成本区间为 $0.006 至 $0.134,最高与最低相差 22 倍。对需要批量出图的团队来说,这份横评可以直接当选型参考,按单张成本和质量权衡该接哪个模型。
同一提示词跑 20 个图像模型,单张从 $0.006 到 $0.134,做批量出图的制片和视觉师可以拿这张价目表挑性价比。
点击打开原文
05
@ForwardEditor
推文称 GPT-6 Astra 通过 MCP 接入 DaVinci Resolve,作者 @ForwardEditor 同时附了一条 44 秒的视频演示。原文只有这一句描述加视频,没有给出具体配置步骤、MCP 服务端写法或达芬奇版本要求。对后期和剪辑岗来说,这是把大模型能力直接挂进剪辑软件的一次尝试,值得看视频确认实际能调用的操作范围。
有人把 GPT-6 Astra 用 MCP 接进了达芬奇,剪辑台里直接调模型。做后期的可以顺着这条摸一下 MCP 接法,看能不能塞进自己的调色/剪辑流程。
点击打开原平台查看,能否访问取决于网络环境
06
@PixVerse
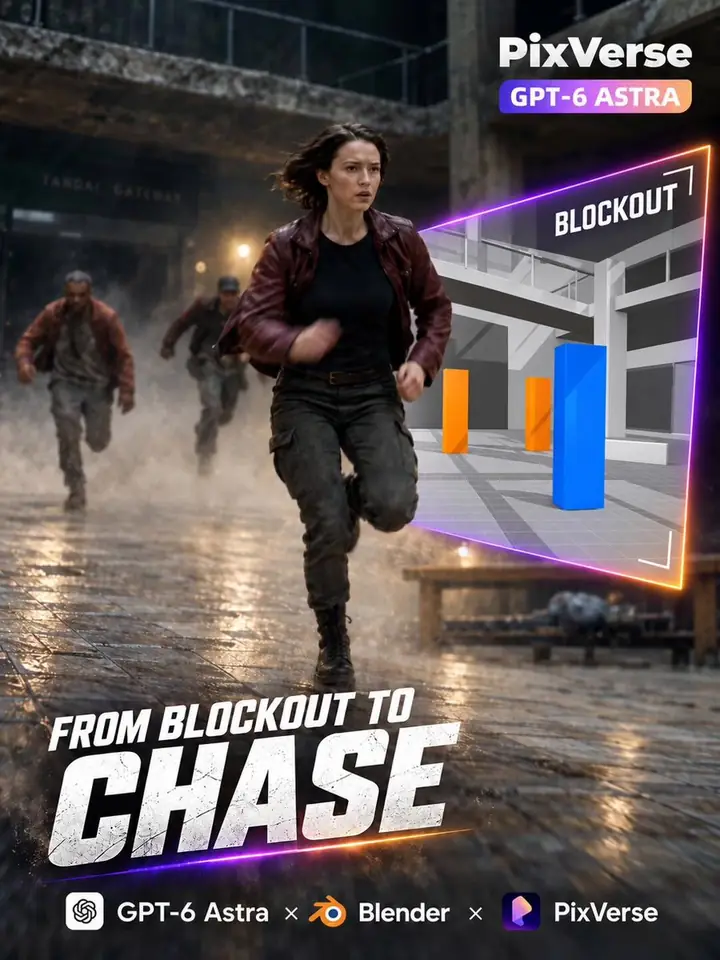
PixVerse 官方发布一条工作流演示:用 Astra 规划镜头运动,再由 PixVerse 渲染出动作场景成片,Blender 参与其中。官方称这套组合是「动作场景的疯狂组合」。对做动作戏和镜头调度的创作者来说,这是一条可参考的分工思路——镜头运动交给规划工具、渲染交给视频模型。
官方演示了 Astra 规划镜头运动、PixVerse 出片的分工,做动作戏和镜头调度的编导可以顺着这条思路试一遍。
点击打开原平台查看,能否访问取决于网络环境
07
@emollick
Ethan Mollick 给 Claude 下了一条开放式指令:挑一个让你着迷的问题或谜团,尽力解决,并做一部能在社交媒体分享的影片。Claude 选了伏尼契手稿尝试破解但失败,随后产出了一部影片,Mollick 评价其观感不错、也是一部合格的讲解片。这条展示的是把选题、研究、成片串成一条指令交给模型自主完成的用法。
沃顿教授给 Claude 一句开放式指令,让它自己挑谜题、尝试破解、再做成可分享的影片。做 AI 短片和自动化内容流程的可以看看这种「一句话交给 Agent 全流程」的玩法。
点击打开原平台查看,能否访问取决于网络环境
08
@karyabangjumawa
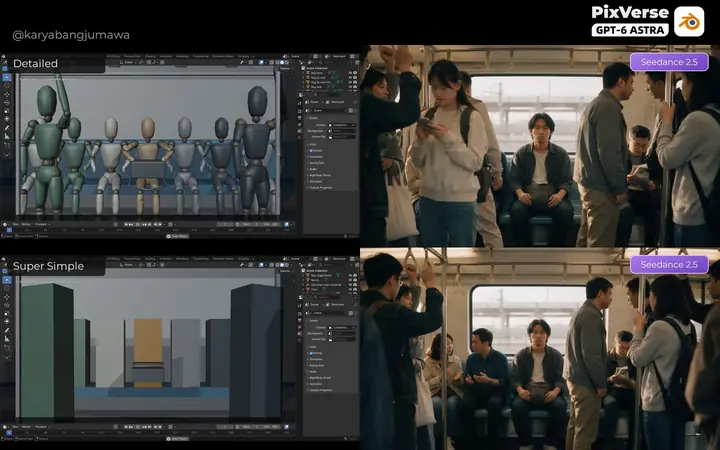
创作者用 PixVerse 做了一组对照测试:同一模型、同一提示词、同一图像参考下,分别生成「Detailed」和「Super Simple」两版,成片用三个镜头节拍——居中推近、跟随取耳机动作的侧面特写、回到正面拉出。作者先修正了场景本身:早期布景把拥挤的火车处理成一排安静坐着的人,角色行为也过于刻意,于是把动作改成从包里取出耳机而非开场就拿着。结论是细节版动作更僵硬,但作者明确表示这不能证明细节本身导致僵硬,也不代表简单版总是更好。
作者用同一模型、同一提示词、同一参考图跑出「细节版」和「极简版」两版,发现细节多的那版动作反而更僵硬。做 AI 短片调表演的可以拉片看这个对比。
点击打开原平台查看,能否访问取决于网络环境
09
@karyabangjumawa
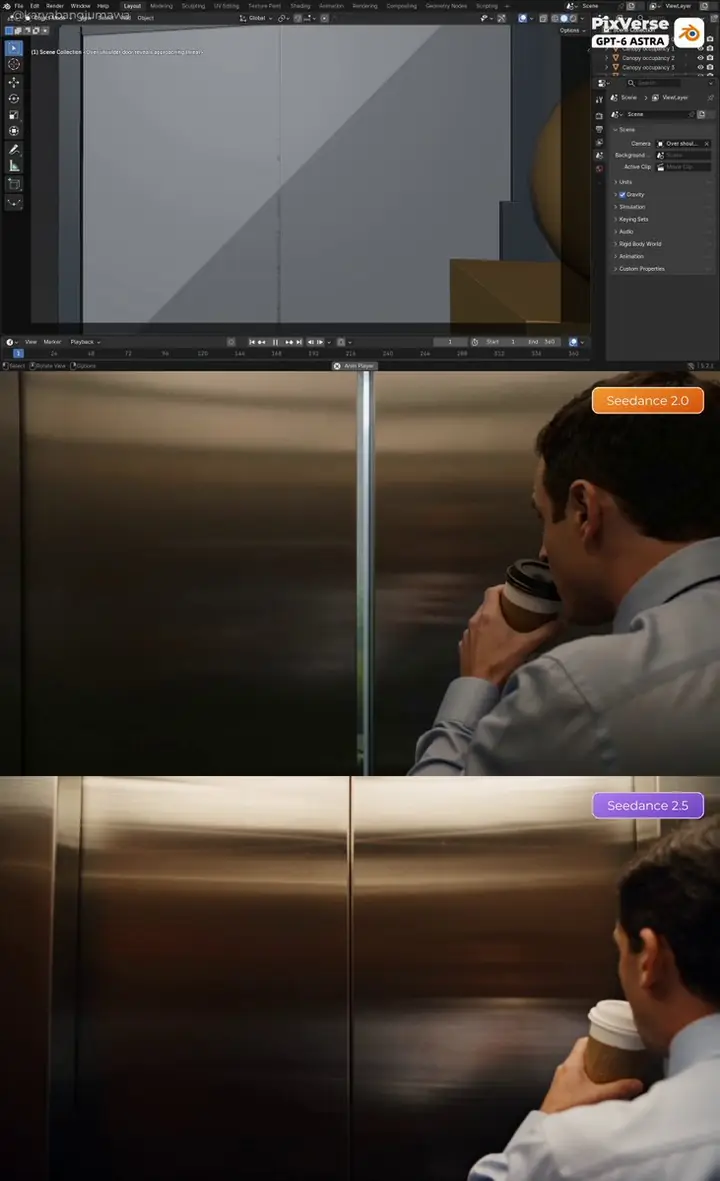
创作者用 PixVerse 制作「错误楼层」电梯遇恐龙场景,复盘第一版问题:机位角度没交代清楚镜头该展示什么、序列缺乏张力、恐龙 CG 感明显。修改方案是重做 Blender 相机与空间布局,把森林留在电梯外,只用恐龙外观参考图,保留喜剧与威胁的反差。作者同时放出 2.5 与 2.0 两版结果对比,并指出提示词指南修正后模型理解仍有差异。
作者把「错误楼层」这场戏的翻车点摊开讲:机位没交代清楚、恐龙一眼假、空间关系乱。做 AI 短片和分镜的可以看他怎么用 Blender 重搭相机和空间,以及 2.5 与 2.0 同一提示词下的差距。
点击打开原平台查看,能否访问取决于网络环境
10
@AIWarper
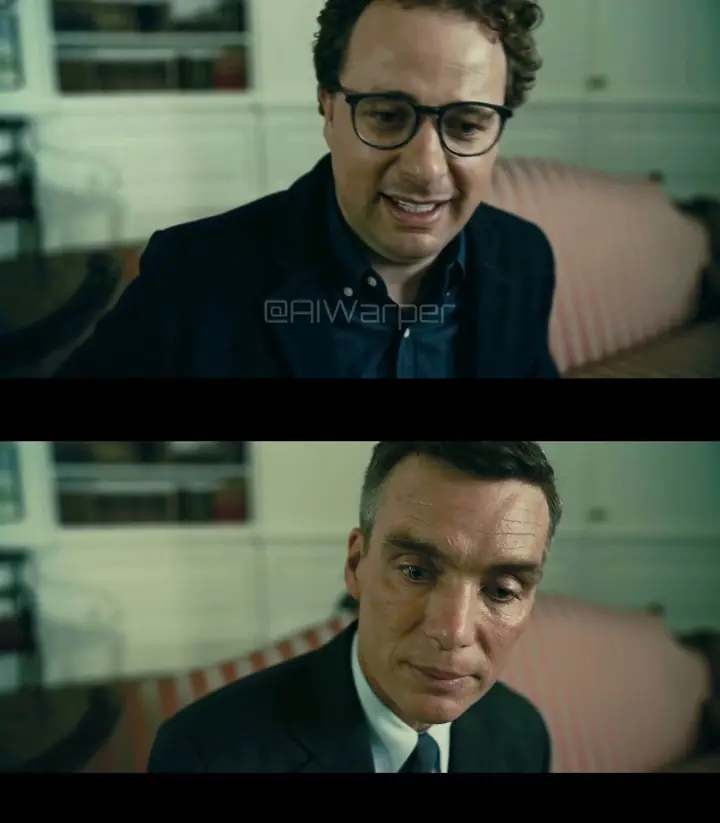
创作者 @AIWarper 实测 H3 的提示遵循能力,指出它做「替换角色但逐字匹配所有动作」这类基础任务时非常挑剔,另外叠加任何类型的 turbo lora 都会让控制难度显著上升,明确建议不要这么做。
做角色替换和动作复刻的可以留意这条踩坑记录:H3 提示遵循很挑,加 turbo lora 后更难控,先别急着上加速方案。
点击打开原平台查看,能否访问取决于网络环境