01
@alibaba_cloud
阿里云 Wan3.0 视频生成模型开放 API 接入,可通过 Model Studio 和 Qwen Cloud 使用(该产品 8 月 26 日已发布)。官方称这不是增量更新,而是从 Wan 2.1、2.2 到 3.0 的跨代跃升,在运动参考、一致性、创意控制和分辨率上均有提升,官方表述是让模型对创作者、电影人和叙事者更友好。
阿里云把视频模型从 2.1/2.2 直接推到 3.0,官方点名运动参考、一致性、创意控制和分辨率四项升级,现已开放 API。做 AI 短片和短剧的可以接 Model Studio 跑一周,重点看角色一致性和运动参考稳不稳。
点击打开原平台查看,能否访问取决于网络环境
02
@runwayml
Runway 上线 Fall 2026 模型合集,官方称是其规模最大的一次模型更新,新增 Fish Audio S2.1 Pro、MiniMax H3 Max、Cartesia Sonic 3.6、Flux Video 放大与编辑,与 Runway 自有模型及其他前沿实验室模型并列可用。音频、视频生成、放大、编辑集中在同一平台内调用。
Runway 一口气把 Fish Audio S2.1 Pro、MiniMax H3 Max、Cartesia Sonic 3.6 和 Flux 视频放大/编辑塞进同一个平台,做后期和短剧的可以上去跑一遍,看配音、放大、剪辑能不能省掉来回切工具。
点击打开原平台查看,能否访问取决于网络环境
03
Google AI
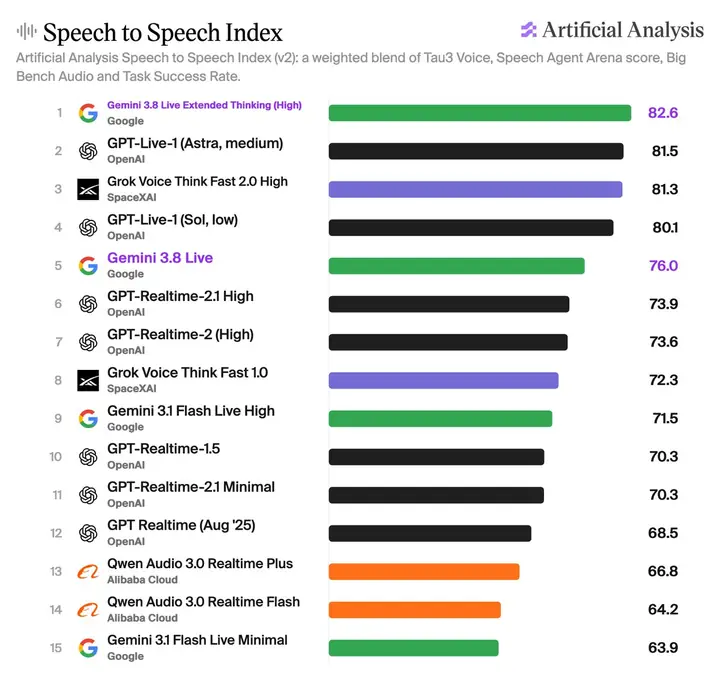
Google 在 Gemini API 和 Google AI Studio 更新 Gemini 3.8 Live 与 3.8 Live Extended Thinking 语音模型(该产品 9 月 16 日已发布),支持异步函数调用(后台执行 API/工具调用同时继续流式输出音频)、视觉上下文(对话可基于实时画面输入)、97+ 语言和可配置思考,Extended Thinking 版位列 Artificial Analysis 语音到语音榜单第一。同批还有 Gemini 3.5 Transcribe 语音转文字模型,覆盖 85+ 语言,流式平均词错率 4.0%、非流式 2.6%。
Gemini 3.8 Live 支持异步函数调用和视觉上下文,对话不中断就能后台跑任务,做 AI 配音、虚拟角色对话、实时字幕的可以接 API 试一周。
点击打开原平台查看,能否访问取决于网络环境
04
@gpumaxxer
Higgsfield 宣布 API 正式上线,自称市场上最便宜,并支持 Seedance 2.5 在美国地区使用面部输入,称无其他提供商能做到。同时开源了过去 18 个月构建的全部代码,发布在 GitHub 上。发起人另设 5 万美元奖金,征集真正有人用的竞品 demo,参与者需引用推文附上 demo,期限 7 天。
Higgsfield 把 API 和 18 个月的代码全开源了,还悬赏 5 万美元征集竞品 demo,做工具链和短剧批量生产的可以接 API 跑一周看成本。
点击打开原平台查看,能否访问取决于网络环境
05
@higgsfield
Higgsfield 发布官方 API,一个接口集成 50 多个前沿模型,官方称价格低于订阅制,按量付费无承诺。上线 7 天内可在自选的 3 个模型上锁定最高 50% 折扣。入口为 open.higgsfield.ai。对需要批量调用多模型出图出片的团队,这是把生成能力接进自有流程、按用量控成本的一条路径。
一个 API 打包 50 多个前沿模型,按量付费不用订阅,7 天内锁定最高折扣。做批量出片、想把生成能力接进自己流程的团队可以先去 open.higgsfield.ai 看模型清单和单价。
点击打开原平台查看,能否访问取决于网络环境
06
@StepFun_ai
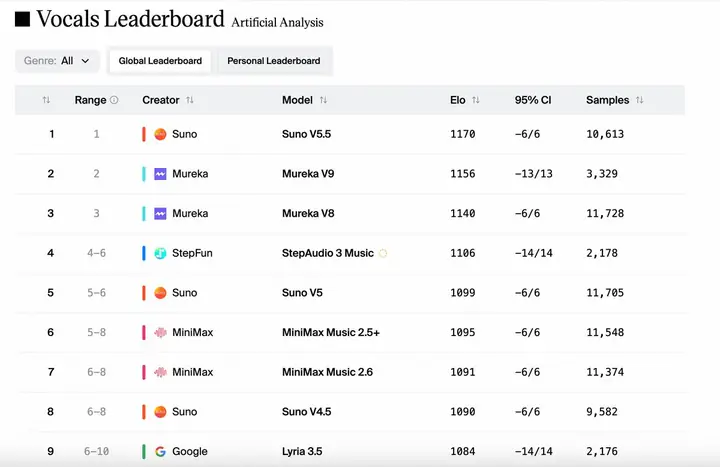
阶跃星辰(StepFun)与 ACE Studio 联合发布 StepAudio 3 Music,这是阶跃星辰首个音乐生成基础模型,可从提示词和歌词生成完整歌曲。支持歌曲生成、纯音乐生成、音乐翻唱、人声转歌曲调度四种工作流,基于 ABC-COT 先规划曲式结构再合成,用户可改写提示词、编辑 ABC 记谱迭代调整。交互式演示已上线,ABC-COT API 即将推出。
阶跃星辰首个音乐生成基础模型,支持整曲、纯音乐、翻唱、人声转调度四种工作流,还能改 ABC 记谱迭代调曲式。做短剧配乐和 AI 音乐后期的可以先去交互式 demo 试听。
点击打开原文,能否访问取决于网络环境
07
OpenAI Blog
OpenAI 官方博客发布 AI 广告新体验,包括 Sponsored Agents、面向营销人员的工具,以及与 HubSpot、Shopify 的集成。这是 OpenAI 在广告商业化方向的产品发布,具体能力细节和上线范围需查看原文。
OpenAI 官方发布 AI 广告产品线,含 Sponsored Agents 及 HubSpot、Shopify 集成,做品牌投放和商业变现的制片人可以看看这套玩法怎么接。
08
@SynthesiaIO
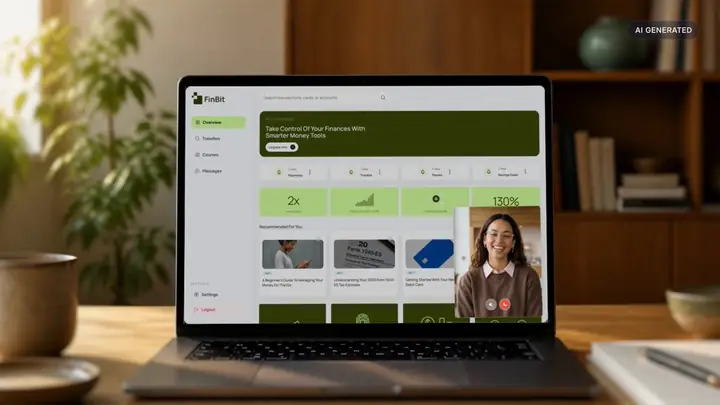
Synthesia 发布 Interactive Avatar API,提供实时数字人能力:能听、能说、能实时回应,通过 LiveKit SDK 嵌入自有产品。开发者自带 LLM、知识库和业务逻辑,Synthesia 负责数字人层——声音、面部、口型同步。官方定位场景为 AI 销售代表、客服等实时对话应用。
Synthesia 把数字人做成可嵌入的实时 API,声音、面部、口型它包了,LLM 和知识库你自己接。做虚拟主播、AI 客服、互动角色的团队可以接 LiveKit SDK 跑一周看延迟。
点击打开原平台查看,能否访问取决于网络环境
09
@SpaceXAI
Grok Voice 已在 fal 平台上线,来自 @SpaceXAI 的语音模型,0.70 秒内应答,并在句子结束前完成工具调用;支持词级时间戳转录、25+ 种语言 30+ 种音色的文本转语音,以及用两分钟音频进行声音克隆。演示视频中每个声音都来自 Grok Voice。做 AI 配音、虚拟角色对话和实时字幕的团队可直接在 fal 上调用测试。
0.7 秒应答、句子没说完就能调工具,还带词级时间戳和两分钟音频克隆音色,做 AI 配音和虚拟角色对话的可以接 fal 跑一周看延迟稳不稳。
点击打开原文,能否访问取决于网络环境
10
@MaxForAI
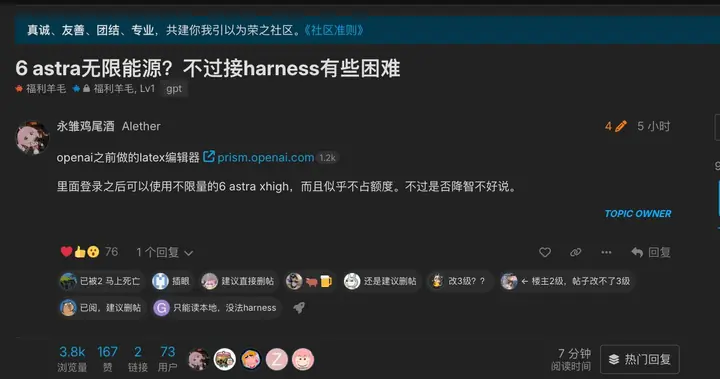
有 Reddit 用户 9 月 16 日报告,Codex 额度耗尽后,OpenAI 官方免费 LaTeX 编辑器 Prism 里的 GPT-6 Astra Extra High 仍可继续使用,疑似走独立 usage pool。官方文档写明 Free/Go/Plus/Pro 个人用户均可进入,内置 AI 助手由前沿模型驱动,但未标注具体额度。Prism 目前无终端、无本地文件系统、无 Git 集成。
OpenAI 官方 LaTeX 编辑器 Prism 疑似有独立额度池,Codex 用完后仍能调 GPT-6 Astra Extra High。搞工具链的可以研究下这个入口,但没终端没本地文件,暂时只能当个纯文本大脑用。
点击打开原文,能否访问取决于网络环境
11
@dreamina_ai
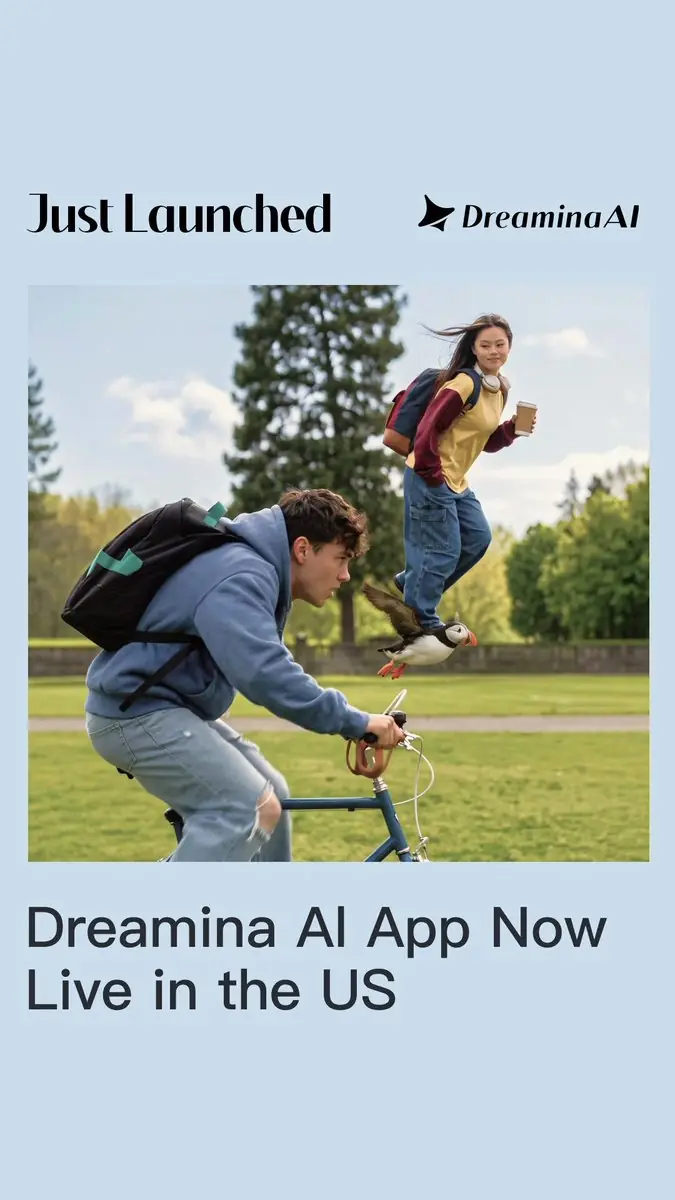
Dreamina 官方宣布 Dreamina App 正式在美国上线,同步推出 Cast 功能:几次轻触即可创建「AI Self」,可放入任意场景、风格或故事中。官方同步开启 #CastYourselfIn 挑战赛,TikTok、Instagram、X 三个平台各取点赞前 10 名,要求带 Dreamina 水印并打指定标签,获奖者得 30 天 Advanced 订阅,截止 9 月 20 日。Cast 可免费试用,邀请好友可解锁更多免费生成额度(限美国)。
Dreamina 独立 App 登陆美国,Cast 功能几次点击就能造出可放进任意场景和风格的 AI 分身,做角色 IP 和短剧的可以下载实测一下形象一致性。
点击打开原平台查看,能否访问取决于网络环境
12
@OpenRouter
OpenRouter 上线隐身模型 Union Alpha(@unionalphaai),定位多模态,面向研究、编程和 Agent 工作流,支持 256K 上下文与工具调用,官方称达到前沿级通用性能,目前免费开放试用并征集反馈。对做自动化流程和 Agent 调度的技术整合者来说,可接 API 实测其在批量任务和工具调用上的稳定性。
多模态、256K 上下文、支持工具调用,免费开放试用。做 Agent 工作流和自动化脚本的可以接 API 跑一轮,看它在批量任务调度上稳不稳。
13
@_LuoFuli
小米 MiMo-V2.6 正处于强化学习训练阶段,团队从三方面扩规模:计算上每步约 2B tokens、1568 条 prompt 各做 16 次 rollout 且全异步;环境与 harness 上做多任务 agentic RL,单次运行混合多种 harness;评分上做 agentic 组内信用分配,结合测试用例与 rubric 奖励。团队称已研究 RL 能扩展到多远,未来几周逐步开源细节并直播训练过程。
小米 MiMo-V2.6 的 RL 训练细节:每步约 2B tokens、1568 条 prompt 各跑 16 次、全异步,还打算直播训练过程。做模型训练和 Agent 的可以蹲后续开源。
01
@TanLuAI
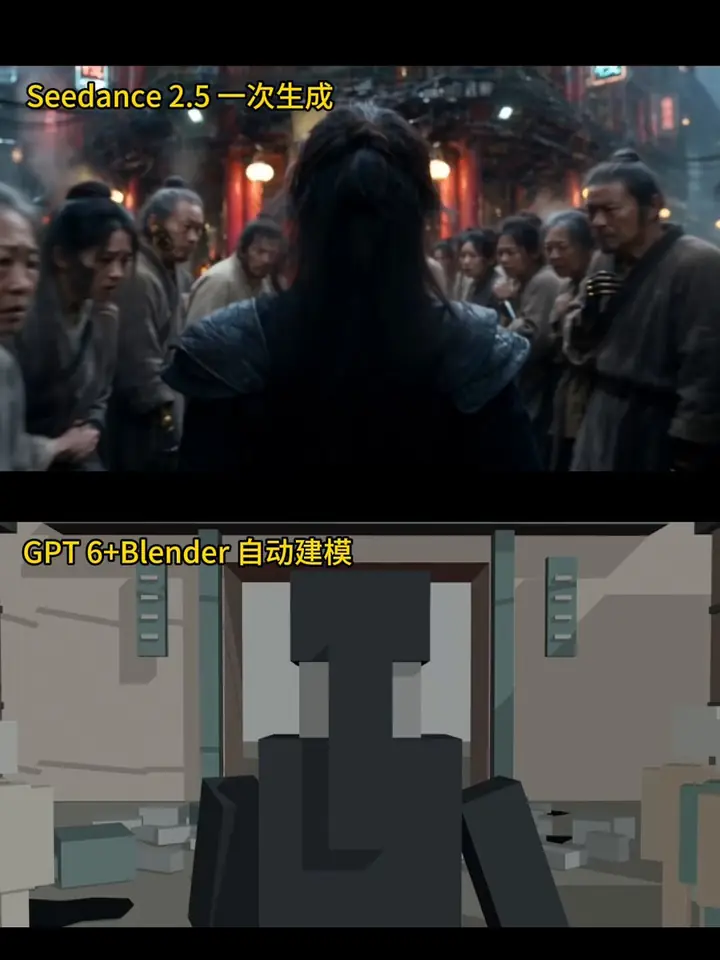
作者 @TanLuAI 分享用 GPT 6 + Blender + Seedance 2.5 做一镜到底 AI 视频的流程经验,认为难点已从镜头调度、人物走位转移到资产图准备和资产描点提示词撰写。他给出两个踩坑案例:场景图只传正面导致正反打镜头雷同,群众角色卡数量太少而画面人物过多导致克隆人。建议场景图尽量包含完整正反打画面并在提示词中标注正打/反打,群众角色卡要数量多、外貌各异,并用提示词限制人数(示例:固定出现 11 名围观平民,每名只出现一次,不复制人物填充背景)。
一镜到底的难点已经从镜头调度挪到资产图准备和描点提示词,作者把正反打场景图和群众角色卡的具体写法都贴出来了,做 AI 短剧和长镜头的可以照着改自己的提示词模板。
点击打开原平台查看,能否访问取决于网络环境
02
@ryanvogel
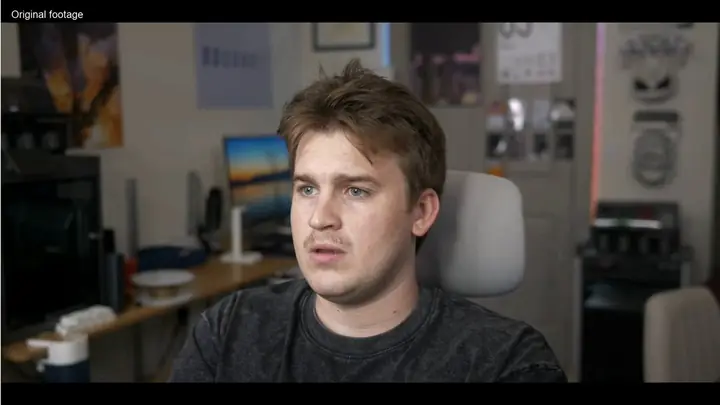
创作者 ryanvogel 发布一支视频,称完全由 Astra 控制 Blender 制作,他本人只提供总体方向和故事情节,渲染、转场、跟踪(rotos、tracking)均由 Astra 完成,并附有完整视觉特效分解。对后期和特效团队来说,这是把 AI Agent 接进 Blender 这类专业三维软件、自动跑渲染与跟踪环节的一次实操展示。
作者只给方向和故事线,渲染、转场、跟踪全交给 Astra 驱动 Blender 完成,做后期和特效的可以点开看这套自动化能替掉多少手工活。
点击打开原平台查看,能否访问取决于网络环境
03
@derrickcchoi
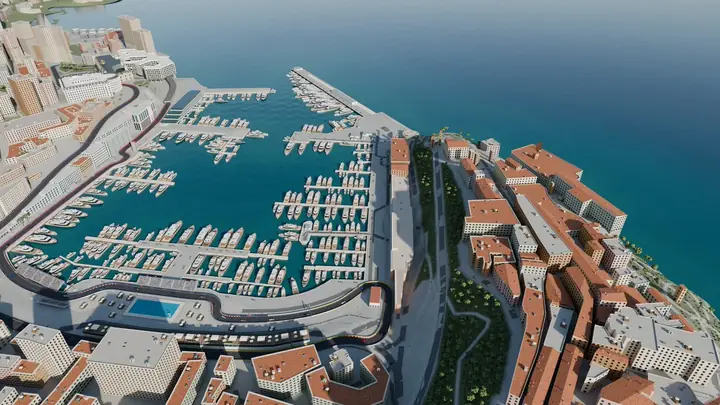
Derrick Choi 用 Astra 制作了一支 87 秒的摩纳哥大奖赛最后一圈影片,包含全部 22 辆 F1 赛车,渲染 2610 帧、4K 30fps。Codex 负责编写构建和动画化 Blender 场景的脚本,并用 Python 生成原创立体声音轨,覆盖引擎转速、换挡、超车和隧道混响,作者提到使用了 High reasoning 模式。
87 秒、22 辆 F1、2610 帧 4K 30fps,Blender 场景搭建和动画全靠 Codex 写脚本,连引擎转速、换挡、隧道混响的立体声也是 Python 生成的。做三维动画和后期声音的可以拆一下这套自动化流程。
点击打开原平台查看,能否访问取决于网络环境
04
@OpenBMB
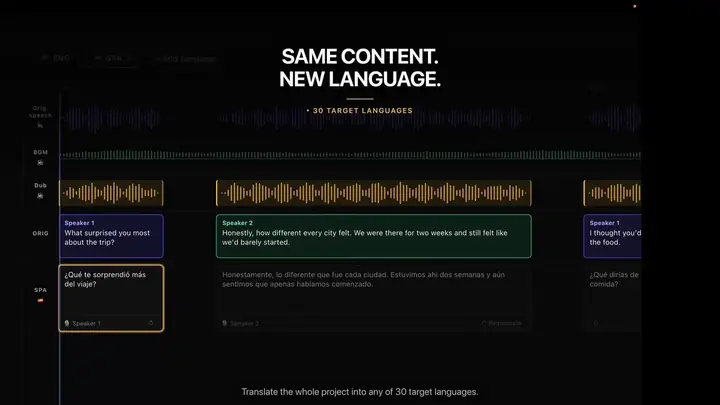
开发者 @dubbedstudio 基于面壁智能 VoxCPM2 打造商用 AI 配音工作室 Dubedo,翻译本地化视频时保留每位说话者的音色身份。支持 30 种目标语言配音,通过参考音频做说话者专属声音克隆,采用缓存语音表征加无服务器 GPU 推理。从转录、翻译到说话者感知的语音生成与最终混音整合在一处,VoxCPM2 模型已在 Hugging Face 开源。
面壁 VoxCPM2 被开发者做成商用配音工作室 Dubedo,翻译视频时能保住每个说话者原本的音色,支持 30 种目标语言。做海外发行和短剧出海的后期可以拿自己的素材跑一遍,看音色还原到什么程度。
点击打开原平台查看,能否访问取决于网络环境
05
@LumaLabsAI
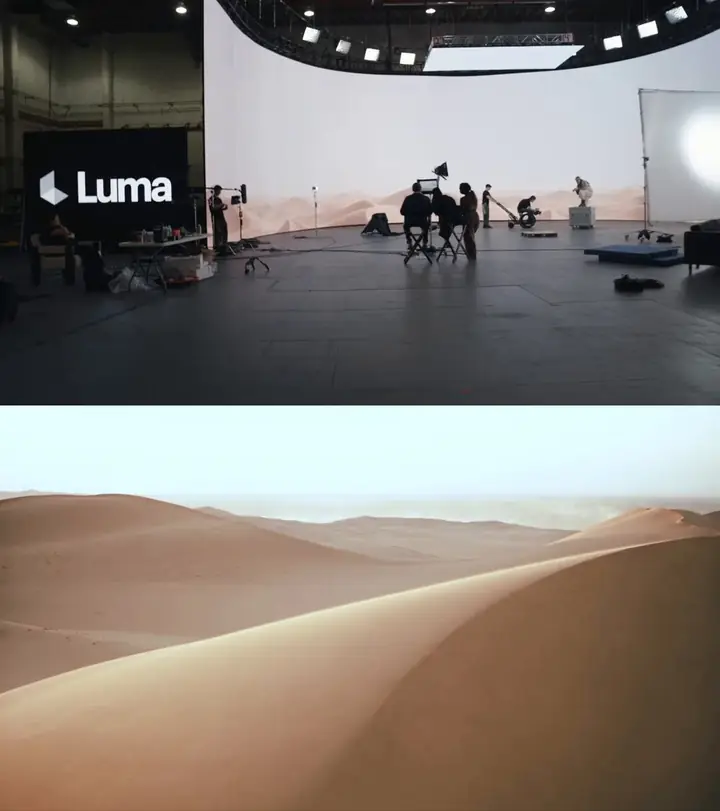
Luma Labs 官方分享影像探索作品《Ichor》的制作流程,提到用 Seedance 2.5 的剪辑模式和新关键帧界面来提升表演贴合度、控制关键帧场景的节奏,直接控制让制作过程更快。
Luma 官方晒自家片子《Ichor》的制作流程,重点在 Seedance 2.5 的剪辑模式和新的关键帧界面怎么控表演和节奏。做 AI 影像的可以看它怎么用关键帧卡节奏。
点击打开原平台查看,能否访问取决于网络环境
06
@insaneUEFN
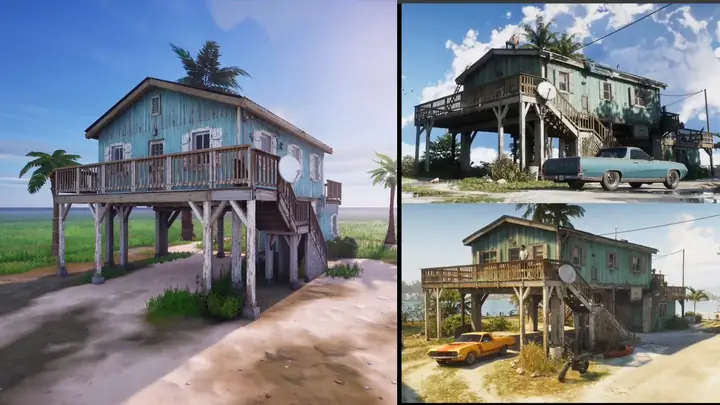
作者用 GPT-6 驱动 Astra,配合 Atlas3DAI 工作流和 Tripo 3.1 制作 GTA 6 海滩别墅场景。流程为:给 Astra 概念图和 YouTube 链接生成参考图,用 Atlas MCP 导出并按 prompt 自动重命名,再喂进 Atlas Batch Composer 一次性批量跑 3D 生成,最后让 Astra 把 70 个高模按形体优化到 5K 或 1K 三角面并导入 Blender 重建房屋。作者提到单靠 Blender MCP 跑 Astra 只能用基本几何体搭资产,Tripo P2 低模效果不达预期,最终选 Tripo 3.1 换细节。
一条把 3D 资产从概念图到进 Blender 全自动跑通的实测:70 个高模、Tripo 3.1 出细节、Atlas Batch Composer 批量生成。做场景和美术的可以照着搭一遍。
点击打开原平台查看,能否访问取决于网络环境
07
@PixVerse
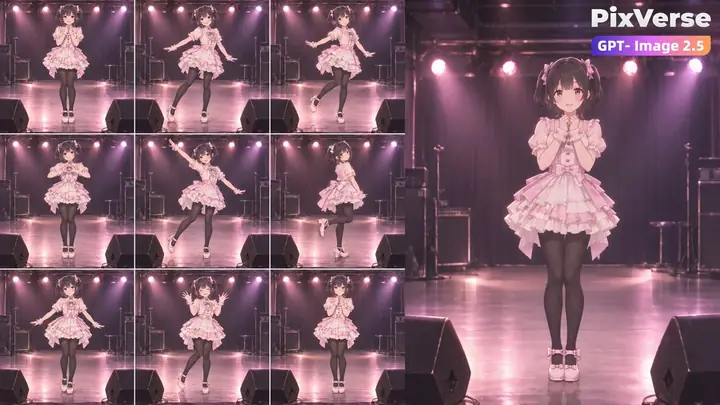
PixVerse 官方账号演示了一条角色动画流程:先用 GPT Image 2.5 生成九帧连续姿势表,做到同一张脸、同一套服装,再放到 PixVerse 上用 Seedance 驱动成动画。这条的价值在于把「姿势表定角色一致性 + 视频模型驱动」拆成了两步可复现的做法,做角色动画、短剧分镜和视觉开发的可以按这个顺序跑一遍,验证姿势表对角色一致性的约束效果。
九帧姿势表同一张脸同一套服装,再丢进 Seedance 让它动起来——做角色动画和短剧的可以照这个顺序试一遍,重点看姿势表能不能压住角色一致性。
点击打开原平台查看,能否访问取决于网络环境
08
@Scenario_gg
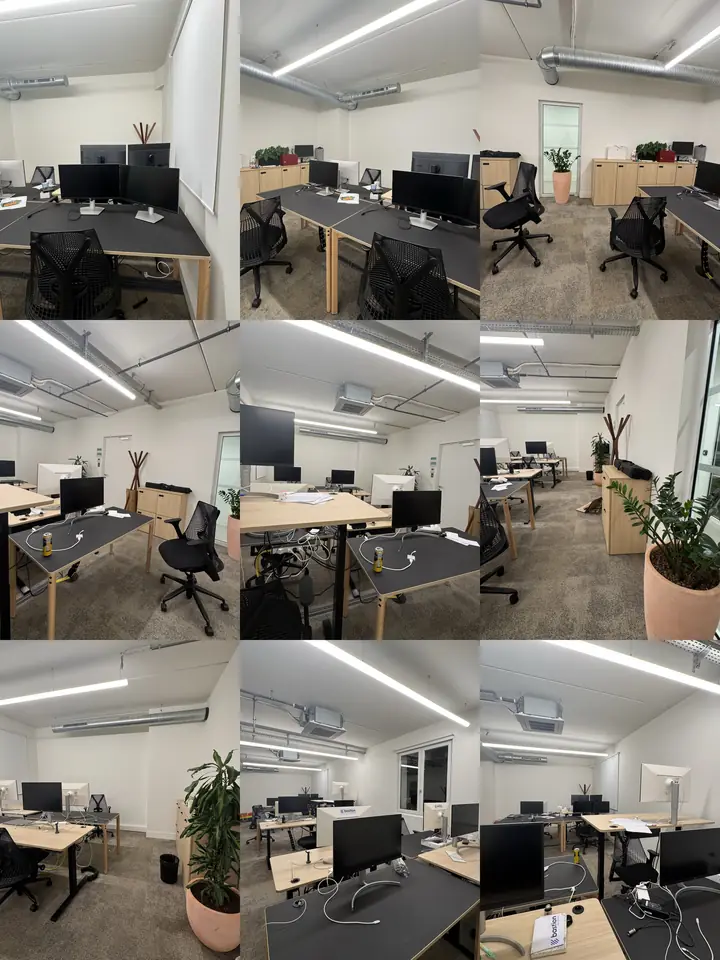
Scenario 官方演示:用 GPT-6 Astra 加 Scenario MCP,把办公室 9 张手机照片转成完全可交互的 3D 房间。Astra 负责理解空间布局并在 Blender 里重建几何体,Scenario MCP 从照片中提取地毯、木材、金属等真实材质,全程无测量、无扫描,一小时后即可在 3D 中漫游实际办公室。
9 张手机照片、无测量无扫描,一小时重建出能走进去的办公室 3D 场景,做虚拟制片和场景预演的视觉师可以试这套流程。
点击打开原平台查看,能否访问取决于网络环境
09
Luma AI Blog
Luma AI 官方博客发布《AI B-Roll Prompts: 25 Filler Shots Worth Generating》,整理 25 条用于生成 B-Roll 空镜/填充镜头的提示词。B-Roll 是叙事片里承担转场、氛围铺垫和节奏缓冲的辅助镜头,这类素材通常需要批量产出。原文未展开具体提示词内容与适用模型版本。
25 条可直接套用的空镜提示词,做短片和短剧的可以存下来当转场素材库,省掉每次现想 prompt 的时间。
点击打开原文
10
@techhalla
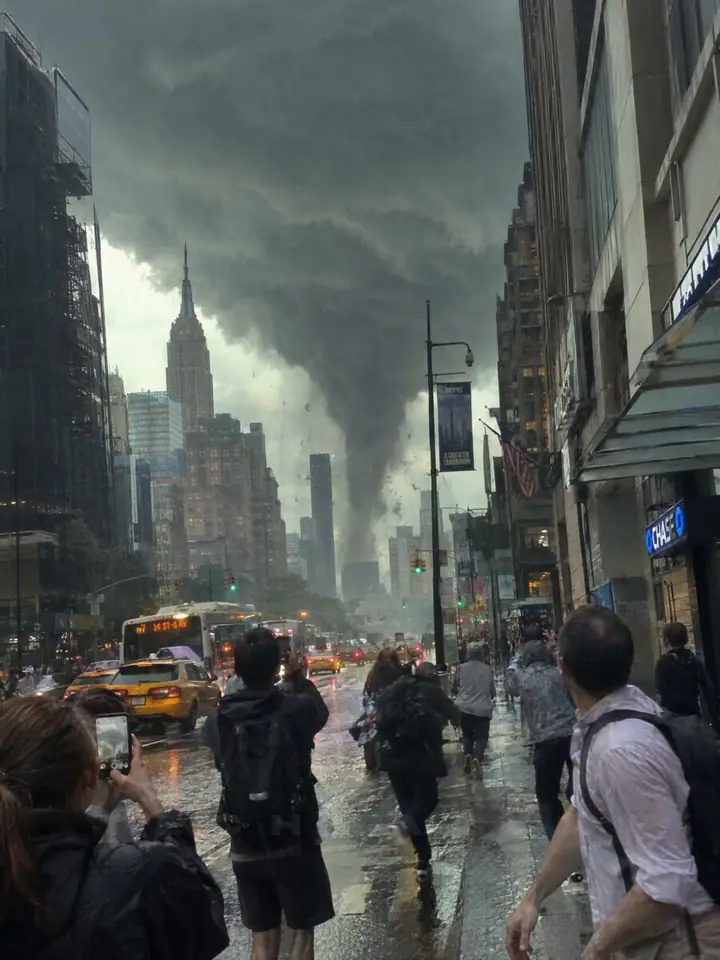
TechHalla 发布一条 AI 视频片段,主题为「即使在最恶劣的条件下也要保持冷静」,制作工具为 GPT Image 2.5 加 Seedance 2.5,提示词附在链接中。推文正文仅含主题句和工具署名,未展开具体画面内容与参数。
推文只给了「最恶劣条件下保持冷静」这句主题和工具组合,成片和提示词都在链接里,做视觉和短剧的可以点开看这套 GPT Image 2.5 出图接 Seedance 2.5 出片的搭配效果。
点击打开原平台查看,能否访问取决于网络环境