01
@ViggleAI
Viggle AI 发布视频模型 Meridian,主打对已有视频做相机角度与时序的再控制:可换新角度跟随动作、放慢速度,或冻结画面同时保持相机移动。权重已在 HuggingFace(huggingface.co/Viggle/Meridian)开放下载。对后期和编导来说,这意味着拍完的素材还能改机位、改节奏,重拍成本高的镜头有了二次调整的空间。
能改已有视频的机位和时序——换角度跟动作、放慢、冻结画面但镜头继续走,后期和编导可以拿旧素材试改机位,权重已上 HuggingFace。
点击打开原平台查看,能否访问取决于网络环境
02
公众号
生数科技正式发布 Vidu S2,包含两个模型:面向数字角色实时交互的 Vidu S2-Avatar,和面向视频流实时编辑的 Vidu S2-Editing,同时探索面向 VR 头显的实时空间视频生成与编辑。官方未在摘要中给出参数、价格或开放方式。做虚拟角色对话、直播数字人和实时改片的团队,这条值得跟进官方后续的接口与实测。
数字角色实时交互 + 视频流实时编辑两个方向一起放出来,还带 VR 空间视频的探索,做虚拟人对话和实时改片的团队可以盯一下官方后续放出的接口和实测。
点击打开原平台查看,能否访问取决于网络环境
03
@GoogleAI
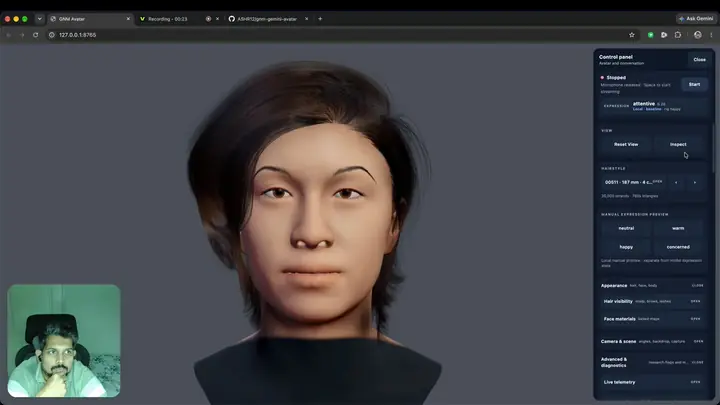
Google 宣布 Gemini 3.8 Live 开始铺开,分三条线:消费端进入 Search Live,开发者端通过 Google AI Studio 在 Gemini API 公开预览,企业端通过 Gemini Enterprise 私有预览(Gemini Enterprise Customer Experience 即将支持)。该版本带 Extended Thinking 扩展思考能力。做实时语音对话、虚拟角色交互、配音类应用的团队可关注 API 公开预览的接入方式。
Gemini 3.8 Live 带 Extended Thinking 分三路铺开:搜索 Live、API 公开预览、企业私有预览。做实时语音交互和虚拟角色对话的可以接 API 试延迟和推理表现。
点击打开原平台查看,能否访问取决于网络环境
04
@CompleteSkeptic
Diogo Almeida(@CompleteSkeptic)称自己共同发明了 ChatGPT,过去两年在隐秘状态下开发新训练方法 RLCD 和新型前沿模型 Jev,今天发布。官方给出的卖点是速度快 20-200 倍、成本低 40-400 倍(输出 token 免费),定位为「面向决策的可组合智能」,称是通往 AI 经济革命的最短路径。推文未给出模型参数、评测数据、API 接入方式或可用入口。
自称 ChatGPT 共同发明人的 Diogo Almeida 放出新模型 Jev,主打快 20-200 倍、便宜 40-400 倍、输出 token 免费,但没给任何可验证的评测或接入方式,做创作工具链的可以先记一笔观望。
点击打开原平台查看,能否访问取决于网络环境
05
@haoailab
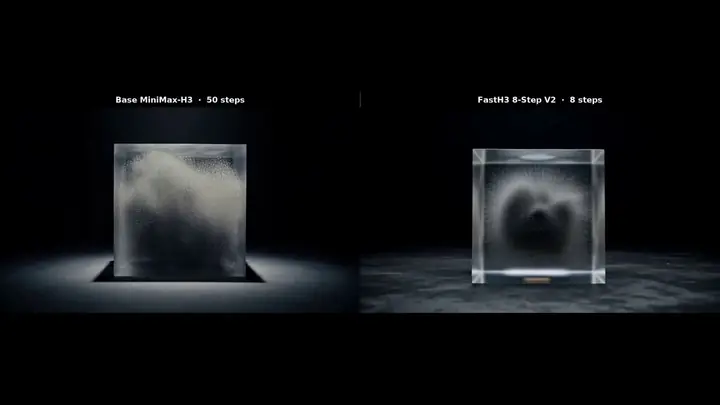
Sky Computing Lab 开源 FastVideo FastH3 V2 加速权重,在 NVIDIA Blackwell 上对 MiniMax H3 基础 50 步流程实现最高 9 倍加速,官方称质量无损。与 nuvalab、NVIDIA FastGen、NVIDIA Enterprise Products 合作,ComfyUI 权重和工作流 Day 0 可用,reactorworld 上 Day 0 提供 API,Omni-ref 仍在训练中。
MiniMax H3 的 50 步生成被压到最高 9 倍速且号称无损,ComfyUI 权重和工作流 Day 0 就位,做短剧批量出片的可以装上跑一遍看废片率。
点击打开原平台查看,能否访问取决于网络环境
06
公众号
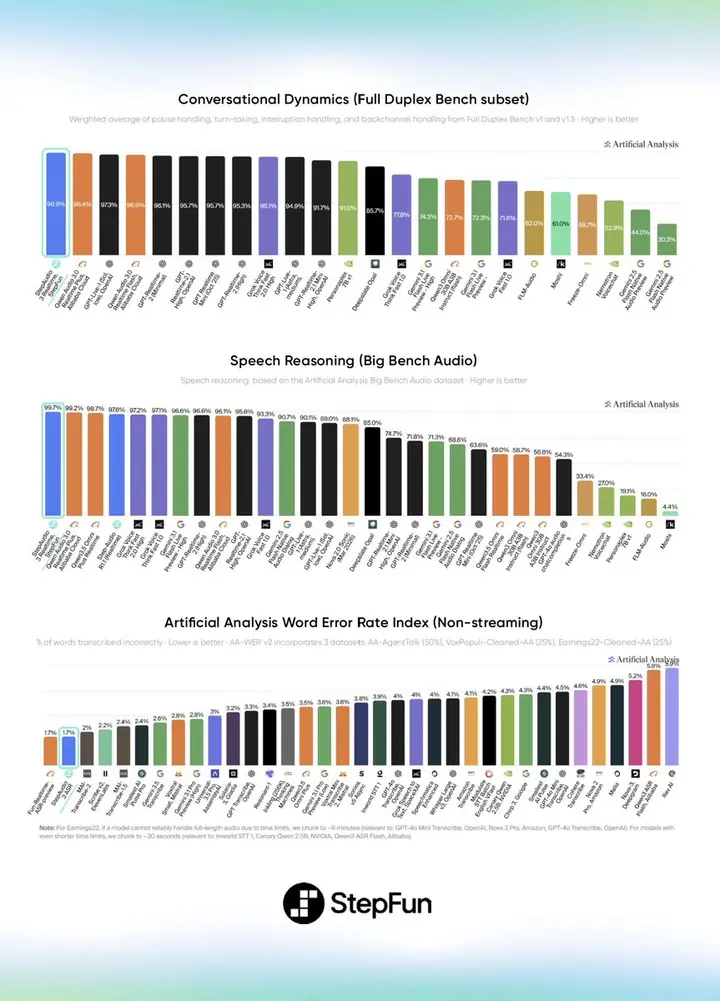
阶跃星辰发布 StepAudio 3 系列语音大模型,包含 Realtime、ASR、TTS、Gen 和 Music 五款,已在阶跃星辰开放平台上线,官方称多款在 Artificial Analysis 榜单全球第一。覆盖实时对话、语音识别、语音合成、音频生成和音乐生成五类能力,做 AI 配音、短剧对白、字幕转写和音效音乐的后期团队可以按需接入测试。
一次放出实时对话、识别、合成、生成、音乐五款语音模型,做 AI 配音、短剧对白和音效后期的可以接 API 跑一周,看中文语音的自然度和情绪表现够不够用。
点击打开原文,能否访问取决于网络环境
07
@testingcatalog
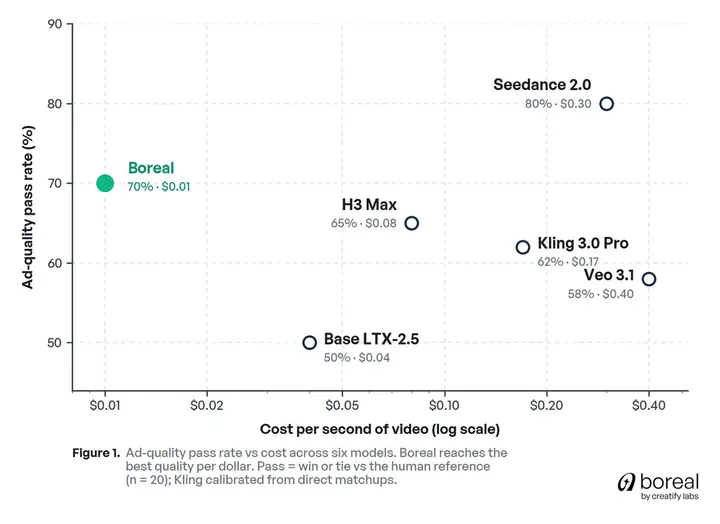
Creatify Labs 发布面向视频广告的文生视频与图生视频模型 Boreal,定价每秒 0.01 美元,已向所有 Creatify 用户开放。模型基于开源权重的 LTX-2.5 后训练,训练语料包括真实广告素材、创作者风格 UGC 和客户制作需求。官方称在 40 多个制作案例的盲测人评中,后训练使 Boreal 对基座模型的胜率达 81%,并称其比 Seedance 2.5 最多便宜 47 倍。
每秒 1 分钱的广告向视频模型,官方称比 Seedance 2.5 便宜最多 47 倍,40 多个案例盲测胜率 81%。做投放素材和电商短视频的可以拿同一批 prompt 跑一遍比价。
点击打开原文,能否访问取决于网络环境
08
@kimmonismus
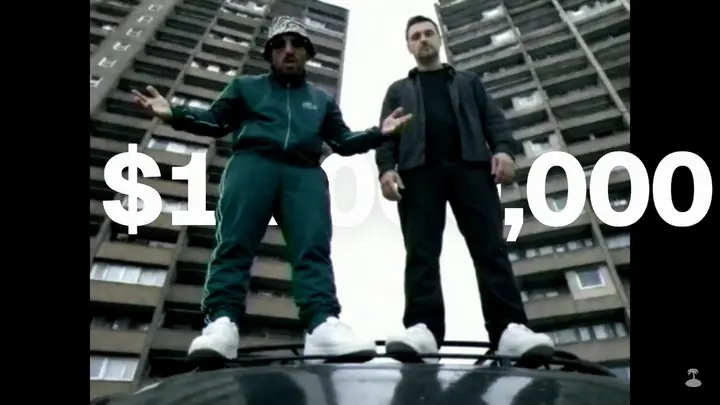
Poolday 宣布视频智能体正式向所有人开放,累计已完成 70 万次 agent 运行和 1 亿次视频剪辑。该智能体可读取视频需求,结合用户已有素材与品牌资产自动完成成片,需要新画面时调用生成模型,输出保持逐层可编辑,能替换 logo、修改字幕。此前 Poolday 已融资 1100 万美元,前 50 名用户可让智能体直接为其制作视频。
能读需求、调素材、缺画面就调生成模型,出片还保持逐层可改——做批量投放和短剧后期的可以拿前 50 个名额试跑一遍。
点击打开原平台查看,能否访问取决于网络环境
09
@thaiscbranco_
Taste Labs 发布首个面向 Agent 的工具 Brand API,官方称此前一直与前沿实验室合作提升其设计模型能力。该 API 解决三个问题:Extract(用户已有品牌时产出符合品牌规范的素材)、Search(从策展索引中检索品牌作参考)、Verify(让 Agent 自查产出是否偏离品牌并给出修正方向)。目前可在 tastelabs.com/api 免费试用,官方同步放出博客与 Intelligence Co 的案例研究。
品牌一致性一直是 AI 出图出片的老大难,这个 API 把「提取品牌资产、检索参考、校验是否跑偏」三件事打包给 Agent 调用,做品牌 KV 和系列物料的视觉师可以免费试跑一遍。
点击打开原平台查看,能否访问取决于网络环境
10
@odysseyml
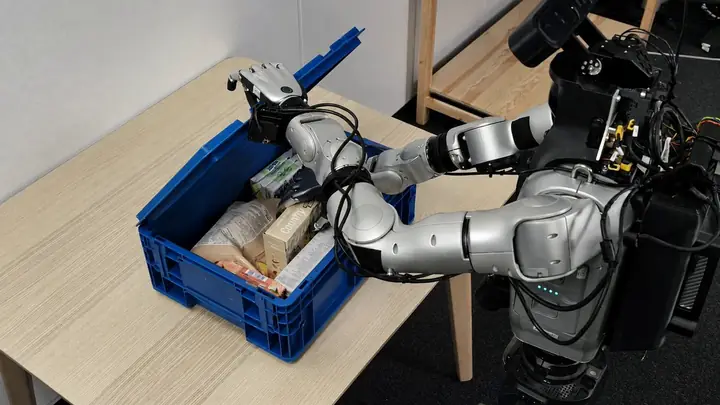
Odyssey(@odysseyml)发布 Odyssey-3 基础世界模型,官方称其可控制机器人、驱动机器人本体、驾驶汽车(含印度道路场景)、训练 AI、操控无人机以及玩电子游戏。发布方未说明模型架构、参数规模、开放方式或可用渠道。该模型面向具身智能与自动驾驶等物理世界控制场景,与影像生成、视频编辑、风格化等创作工作流无直接关联。
当天有 5 家独立信源在报同一件事,属于行业动向本身。对具体创作流程没有直接用处,但这个量级的消息值得知道。
点击打开原平台查看,能否访问取决于网络环境
11
IT之家
Meta 于 9 月 15 日上线 Meta One 订阅套餐,把 Facebook、Instagram、WhatsApp 的订阅权益与更多 Meta AI 使用额度打包,面向 AI 重度用户、创作者和商业用户,最高档每月 499 美元。对做 Meta 系账号运营和投放的团队来说,这是把平台订阅和 AI 额度合并计费的一次调整,具体各档额度与权益差异需看官方说明。
Meta 把 Facebook、Instagram、WhatsApp 订阅和 Meta AI 额度打包成三档套餐,最高 499 美元一个月。做 Meta 系投放和账号运营的可以算一下额度够不够回本,纯拍片的先不用动。
点击打开原文
12
@magnific
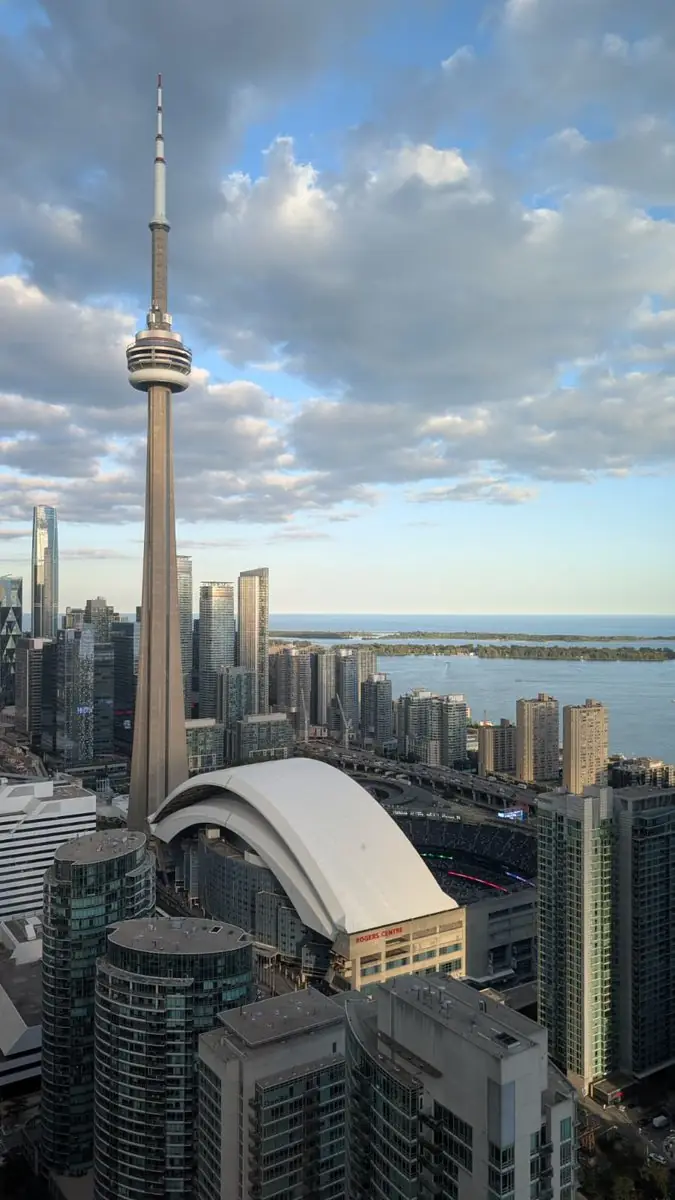
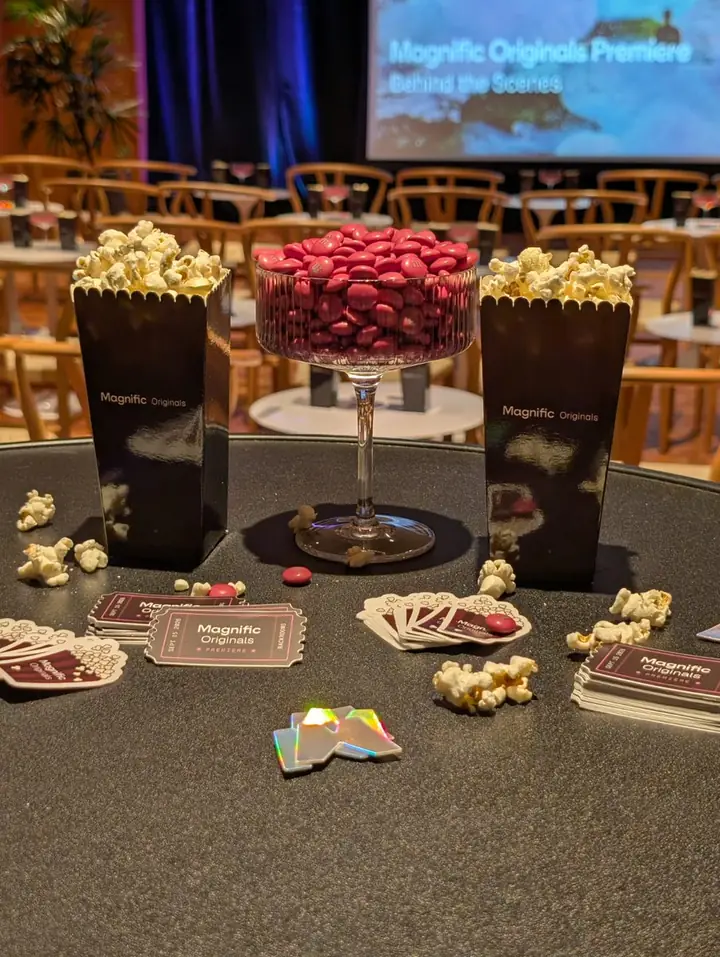
Magnific 官方账号发布预告,称一部由单人完成的完整电影已在多伦多进行首次观众放映,并宣布这是「下一部 Magnific Original」的开始,附有链接。原文未透露片名、时长、所用模型或制作流程。对做 AI 长片和独立制片的创作者来说,值得留意的是「一人完成整部电影」这一制作模式,正片上线后可拉片看单人全流程的实际完成度。
Magnific 官方放出的新片预告,强调「整部电影由一个人完成」并在多伦多首次放映,做 AI 长片和独立制片的可以蹲正片,看单人全流程能撑到什么体量。
点击打开原文,能否访问取决于网络环境
01
@_akhaliq
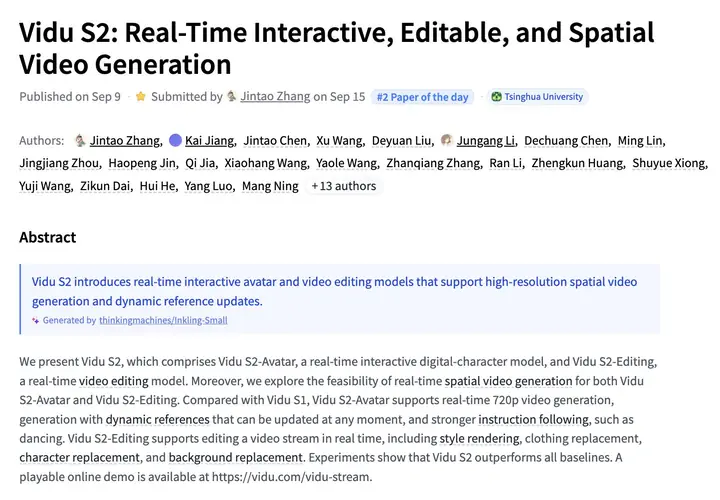
Vidu S2 论文发布,包含两个模型:Vidu S2-Avatar 做实时交互数字人,相比 Vidu S1 支持实时 720p 生成、可随时更新的动态参考和更强的指令遵循;Vidu S2-Editing 支持对视频流实时编辑,覆盖风格渲染、服装、角色和背景替换。论文在 Hugging Face 可查,官方演示页 vidu.com/vidu-stream 已开放。
实时 720p 数字人加视频流实时换装换景,做虚拟主播和直播向短剧的可以点开演示页看实际延迟和指令遵循表现。
点击打开原文,能否访问取决于网络环境
02
@aehyok
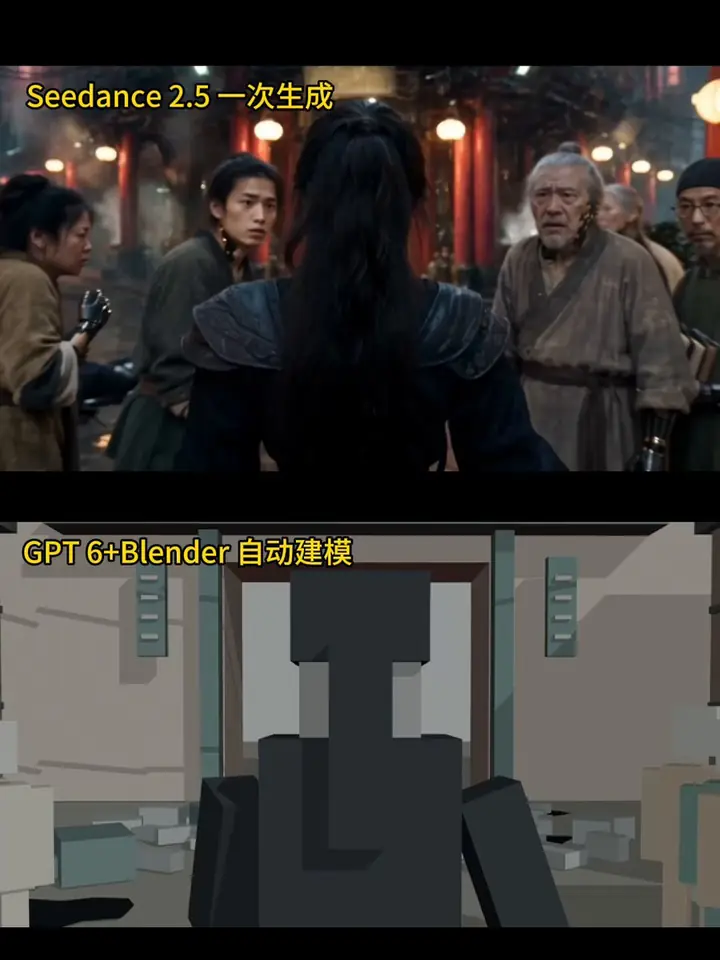
作者 @aehyok 分享一套 AI 视频创作流程:先用 Codex 把自然语言故事拆成镜头、时长、景别、机位、运镜、人物位置与运动、切镜点,再由 Codex 操作 Blender 生成白模预演视频(示例含 9 个镜头,从踹门到天台爆炸,总长约 18 秒),不满意就在白模阶段改 Blender 重渲染,避免用 Seedance 抽卡。白模确认后再准备角色道具资产图与场景风格参考,并建立「白模几何体 → 真实资产」映射(如浅青色长方体=女主、红色圆柱体=火箭),同时要求模型严格参考白模的摄影机运动、景别、切镜时间与空间关系,但几何体只代表位置和移动方向、不代表真实肢体动作。
用白模预演把镜头运动、切镜时间先定死,再让 Seedance 按映射关系出片,省掉反复抽卡。做 AI 短剧和分镜的可以照这套顺序跑一遍。
点击打开原平台查看,能否访问取决于网络环境
03
@krea_ai
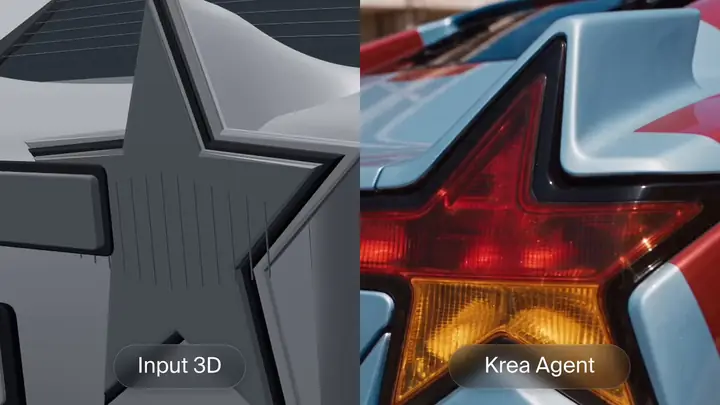
Krea 官方演示用 Krea Agent 做可控运镜视频的三步流程:先拿一张输入图让 Agent 生成 3D 场景,场景建好后指定任意想要的镜头运动,最后调用 Seedance 渲染成 3D 视频。核心是把「运镜」从提示词里抽出来,变成在 3D 场景里直接摆机位。
Krea 官方给出三步工作流:图生 3D 场景、指定任意运镜、再用 Seedance 渲染成片。想摆脱固定机位、自己控制镜头走位的编导和视觉师可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
04
@ZHO_ZHO_ZHO
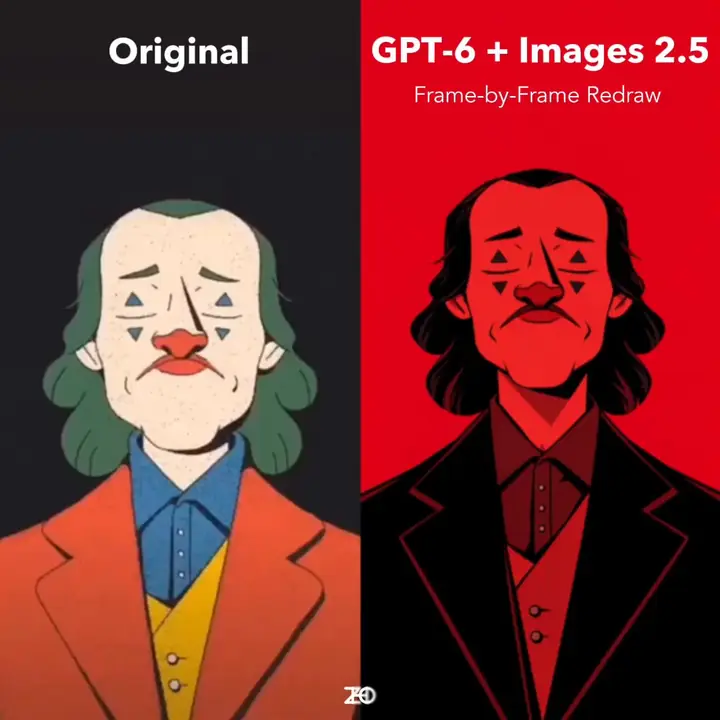
X 用户 ZHO 用 GPT-6 搭配 Images 2.5 做视频风格逐帧转绘,共处理 121 帧,GPT-6 在过程中反复修正,全程耗时 40 分钟。作者称画面稳定性和连贯性表现较强,但仍存在变形问题。属于个人测试性质的流程分享,展示了用通用大模型做逐帧风格迁移的可行性。
121 帧逐帧转绘、40 分钟跑完,稳定性和连贯性都上来了但仍有变形。做风格化转绘和后期特效的可以拿这个流程试一遍,看废帧率能不能接受。
点击打开原平台查看,能否访问取决于网络环境
05
@alibaba_cloud
阿里云 Johnny Mai 与 Venice AI 的 Jordan Urus 对谈 Wan3.0 进入真实创作流程的方式,提出 AI 视频工作流更像原型迭代:360p 起稿、480p 迭代、720p 精修、1080p 定稿,而非依赖「完美提示词」。Wan3.0 已开放 API,可通过 Model Studio 和 Qwen Cloud 接入。
阿里云和 Venice AI 的人聊 Wan3.0 怎么进真实创作流程,核心观点是 360p 起稿逐档精修到 1080p,别指望一句完美提示词出片。做 AI 短剧和长片的可以拿这套分档流程对着自己现在的做法比一比。
点击打开原平台查看,能否访问取决于网络环境
06
Tripo
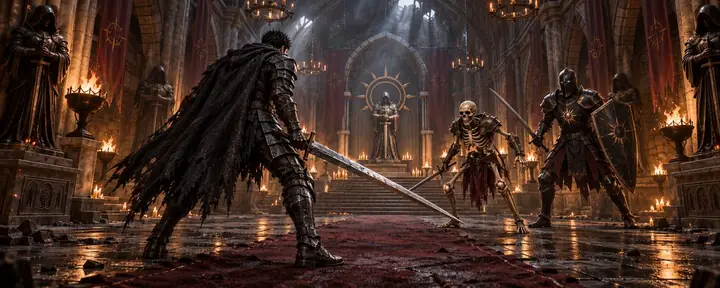
Tripo 官方发布案例:用 Astra x Tripo 在 Unreal Engine 中构建黑暗奇幻原型,全程耗时 1 天,整个工作流通过 Codex 连接,官方附有拆解文章。对做 3D 资产、游戏场景和虚幻引擎原型的创作者来说,这是一条「AI 生成资产 + 编程 Agent 串流程」的实操样本,可参考其工具衔接方式。
Tripo 官方晒的客户案例:Astra 出资产、Codex 串流程,一天在虚幻引擎里搭出黑暗奇幻原型。做 3D 资产和游戏向视觉的可以点进去看它这套工作流怎么接的。
点击打开原文,能否访问取决于网络环境
07
@magnific
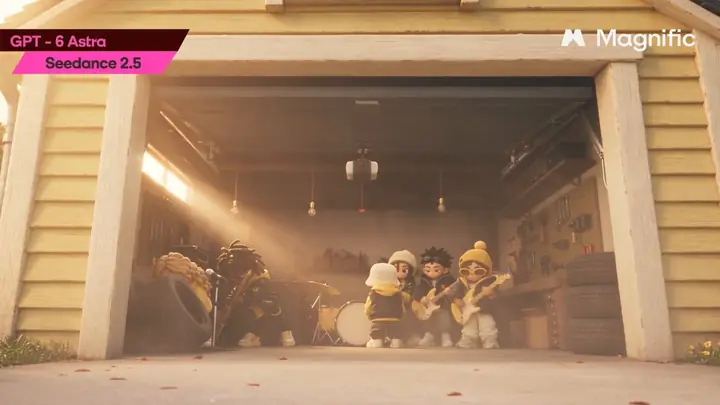
Magnific 官方介绍 AI 动画短片《SUNNY SIX — THE REHEARSAL》的制作流程:先用 GPT-6 Astra 把角色放进车库排练的场景,并给这段戏加了个小故事线——架设备、烧掉音箱、再来一次;画面由 Seedance 2.5 生成(该产品 8 月 1 日已发布),格式为三段式动画。完整 prompt 已公开,包含格式与风格设定。
三段式动画短片《SUNNY SIX》的完整工作流:GPT-6 Astra 负责把角色放进车库排练的场景设定和「架设备—烧音箱—再来一次」的小故事,Seedance 2.5 出画面,prompt 全文公开。做 AI 动画和短剧的可以照着这套「先写戏再出片」的流程跑一遍。
点击打开原文,能否访问取决于网络环境
08
Luma AI Blog
Luma AI 官方博客发布 AI 视频转场提示词指南,围绕切(Cuts)、划像(Wipes)、匹配剪辑(Match Cuts)三类转场给出提示词写法。原文仅提供标题,未展开具体 prompt 示例与参数。对做 AI 短片、短剧的编导和后期来说,转场一直是多镜头拼接的薄弱环节,这份指南可作为镜头衔接提示词的参考起点。
Luma 官方整理的转场提示词写法,切、划像、匹配剪辑三类各给了 prompt 思路,做 AI 短片和短剧的可以拿去改自己的分镜衔接。
点击打开原文
09
Luma AI Blog
Luma AI 官方博客发布口型同步教程,主题是如何写提示词让 AI 生成的对话口型与台词对齐。原文仅给出标题,未展开具体提示词写法、参数或示例。对口型同步、数字人对话、AI 短剧配音环节的创作者,这是一篇官方口径的方法参考。
Luma 官方出的口型同步提示词教程,做 AI 短剧和数字人对话的可以照着调台词节奏和嘴型,省掉反复试错。
点击打开原文
10
@Khazix0918
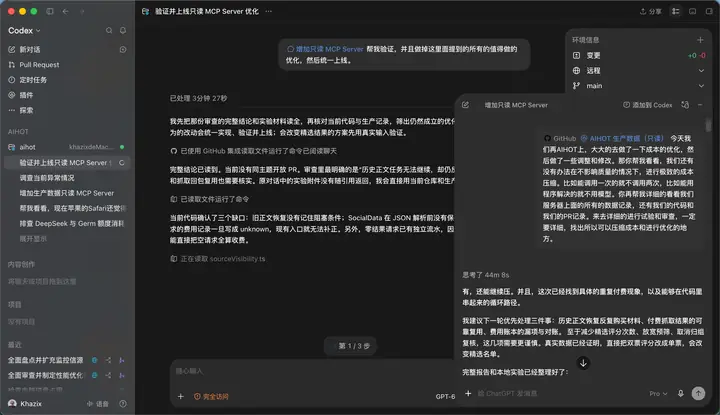
作者把服务器日志、事件记录、数据表的只读权限封装成用飞书登录验证的 MCP,再做成插件上传到 ChatGPT,让网页版 GPT-6 Pro 读取服务器历史数据和 GitHub PR/代码记录做项目规划;规划结果可再添加到 Codex,用 GPT-6 Astra high 开发。作者称网页版 GPT-6 Pro 规划能力强且不消耗 Codex 额度,而用 GPT 6 Ultra 一次会吃掉 200 刀套餐约 10% 的 Codex 额度。
把服务器日志、数据表、GitHub PR 打包成飞书登录验证的 MCP 插件挂到 ChatGPT 网页版,用 GPT-6 Pro 做规划、再丢进 Codex 开发,省额度。自己搭自动化流程的可以看这套接法。
点击打开原文,能否访问取决于网络环境