01
@ViggleAI
Viggle 官方宣布开源 viggle-animate 模型,可将任意视频中的人物替换成其他形象,同时提供在线快速体验版本,入口为 viggle.ai/meme/app/animate。开源意味着可本地部署、接入自有流程,在线版则适合先试效果。做短剧换角、二创人物替换和后期合成的团队,可以拿它测一下人物边缘、动作跟随和跨镜头一致性。
任意视频里的人物直接换掉,模型权重开源还配了在线版,做短剧换脸、二创和后期替换的可以先去在线版跑一遍看边缘和一致性。
点击打开原文,能否访问取决于网络环境
02
@adrgrondin
据 @adrgrondin 转述,苹果随 iOS 27 推出端侧模型 AFM 3 Core Advanced,总参数 200 亿,按请求类型仅激活 1 至 4 亿参数,并展示了该模型在 iPhone 17 Pro 上的运行情况。这是设备端推理能力的一次规格披露,与云端视频/图像生成模型不是同一类产品。对影视创作者而言,这条属于移动端算力与本地模型动态,暂无可直接接入的创作能力。
苹果把 200 亿参数的端侧模型塞进 iPhone 17 Pro,按请求只激活 1-4 亿参数。做移动端 AI 应用和本地推理的可以留意这条技术路线,纯拍片的暂时用不上。
点击打开原平台查看,能否访问取决于网络环境
03
@SiliconFlowAI
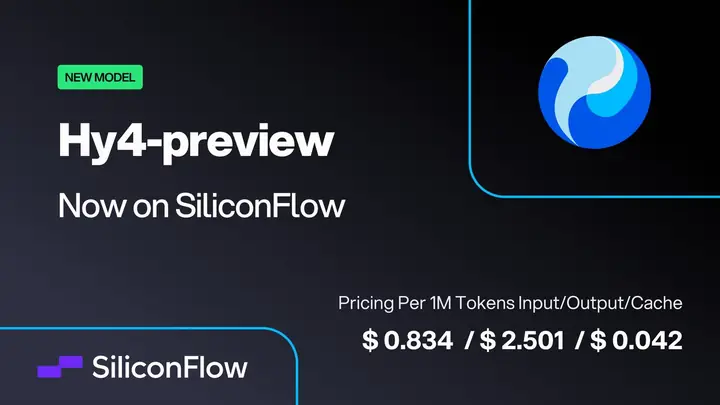
硅基流动(SiliconFlow)宣布开源模型 Hy4 preview 上线其平台,总参数 770B、每 token 激活 49B、支持 1M 上下文,采用 Apache 2.0 协议,面向编码、分析、研究和复杂实际工作,可接入 Claude Code、Codex、Cursor 等工具,图片显示定价为每 1M tokens 输入 $0.834、输出 $2.501、缓存 $0.042。
770B 总参数、1M 上下文、Apache 2.0,主打编码和分析,能接进 Claude Code、Codex、Cursor。做技术整合的可以接 API 跑一周,看长上下文处理素材脚本稳不稳。
点击打开原文,能否访问取决于网络环境
04
公众号
京东探索研究院在 9 月 9 日 JDD 大会上发布 JoyAI-Echo 系列两项进展:超长音视频生成模型升级至 JoyAI-Echo 1.5,同时发布并开源可交互视听世界模型 EchoWM。正文页面因环境验证未能抓取,具体参数、开源协议和调用方式需查看官方原文。
京东探索研究院在 JDD 大会放出超长音视频生成模型 JoyAI-Echo 1.5,同时开源可交互视听世界模型 EchoWM。做长片和短剧的可以盯一下开源权重,看能不能接进自己的流程。
05
@OpenBMB
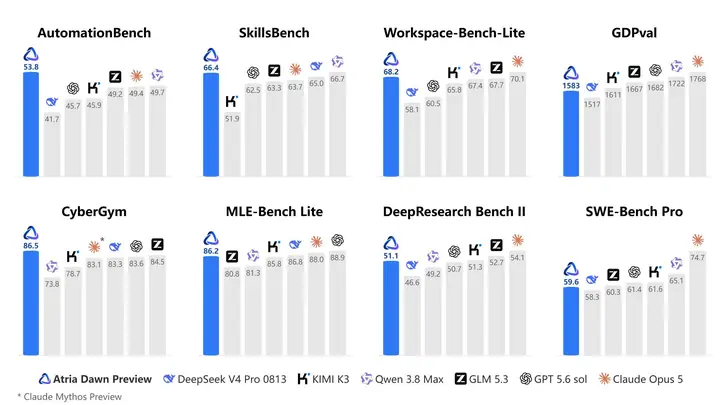
面壁智能 OpenBMB 发布 Atria Dawn Preview,一款面向长程任务的智能体模型,覆盖问题探索、方案设计、代码编写与实验验证的完整研究流程,输出可执行、可验证、可复现的结果。模型已在 GitHub 和 Hugging Face(internlm/Atria-Dawn-Preview)开放权重,并可通过 api.atria-asi.ai 试用。定位偏研究自动化,不涉及图像、视频或音频生成能力。
面向长程任务的智能体模型,主打问题探索到实验验证的研究流程,权重已在 GitHub 和 Hugging Face 开放。做自动化工作流的可以接 API 试跑,纯拍片的这条关系不大。
点击打开原文,能否访问取决于网络环境
06
@perplexity_ai
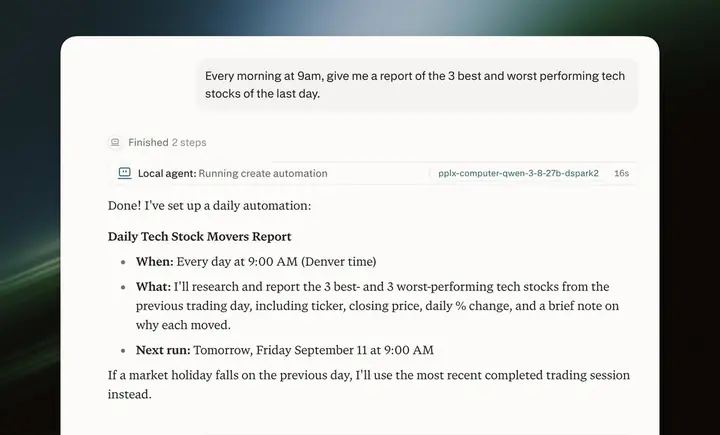
Perplexity 宣布 Portable Computer 上线 Windows PC,需 NVIDIA RTX GPU 支持,可在本地运行 harness、agent 和模型,直接处理本地文件与已连接应用,任务不必上传云端,需要时仍可调用云端前沿模型。这是一条本地跑 agent 的选项。
Perplexity 把 agent 和模型搬到本地跑,文件和应用不用上传云端,需要时再调云端大模型。做本地素材处理、不想把片子传上云的团队可以装一台试试。
点击打开原文,能否访问取决于网络环境
07
@odysseyml
Odyssey(@odysseyml)官方发推预告「World models, part 3. Tomorrow.」,即世界模型系列第三部将于明日发布,推文未透露具体能力、参数或产品形态。该系列此前以可交互的实时生成世界模型为方向,做 AI 影像、交互叙事和实时生成内容的创作者可关注明日正式发布。
Odyssey 官方放话世界模型系列第三部明天上线,前两部主打可交互实时生成画面,做 AI 影像和交互叙事的可以蹲一波看这次能力边界推到哪。
点击打开原平台查看,能否访问取决于网络环境
08
@AppStore
苹果 App Store 官方账号宣布 iOS 27 上线,主打全新 Siri AI:可调用用户个人情境,跨多个 App 搜索内容或执行操作,官方同步放出更新总览页面。这是系统级语音助手的能力升级,面向 iPhone 用户日常使用场景。对 AI 影视/AIGC 创作者来说,这条属于手机系统更新,不涉及视频生成、图像编辑或创作工具链,参考价值有限。
苹果系统更新,Siri 能读个人情境跨应用搜索和执行操作,跟 AI 影视创作工作流基本不搭边,做 App 生态的可以扫一眼。
点击打开原平台查看,能否访问取决于网络环境
09
@haider1
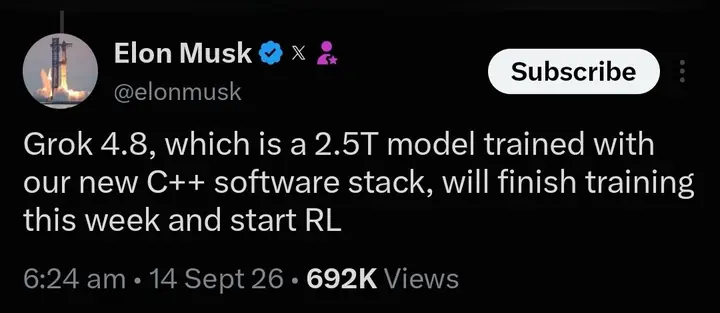
X 用户 Haider(@haider1)转述:马斯克确认 Grok 4.8 为 2.5T 参数模型,将于本周完成训练;据此推测上周被推迟的 Grok 4.7 可能在下周某个时间推出。该条为第三方转述,未附官方链接或具体能力参数。对 AIGC 创作者而言,这是模型版本节奏信息,暂未涉及图像/视频生成能力或创作工具链变化。
马斯克确认 Grok 4.8 是 2.5T 参数模型、本周训练完成,Grok 4.7 上周跳票后预计下周上线。做 AI 工具链的可以留意版本节奏,纯拍片的先记一笔。
点击打开原文,能否访问取决于网络环境
10
@Nozelcode
Photon Studio 是一款免费本地图像编辑工具,支持 macOS、Windows 11 和 Linux,无需上传云端、无需注册账号即可开始编辑。功能覆盖图层、组、蒙版、调整图层、智能对象、原生 PSD 文件支持、主体选择与背景移除、曲线调亮度对比度、液化变形、阴影/发光/描边效果,其中主体选择和抠图也在本机运行。获取方式为官网选择系统、留邮箱收下载链接。
免费本地版 Photoshop 替代品,图层、蒙版、PSD 原生支持、主体选择、抠图、液化都在本机跑,文件不上云。做视觉和海报的可以装一个当轻量修图备胎,处理敏感素材时不用再传云端。
点击打开原平台查看,能否访问取决于网络环境
11
Tripo
Tripo 官方 X 宣布与 Astra 联合举办 3D 工作流挑战赛,参赛方式是用 Tripo 和 Astra 把单张角色参考图转成带骨骼绑定的动画 3D 资产,奖励为免费 API 额度,挑战详情与规则在官方帖内。对做角色 IP、3D 预演和虚拟形象的团队来说,这是一条能顺带验证「单图转绑定动画资产」这条流程的参赛机会。
单张角色参考图转带骨骼绑定的动画 3D 资产,赢免费 API 额度。做角色 IP 和 3D 预演的可以拿自己的角色图跑一遍,顺便薅额度。
点击打开原文,能否访问取决于网络环境
12
@op7418
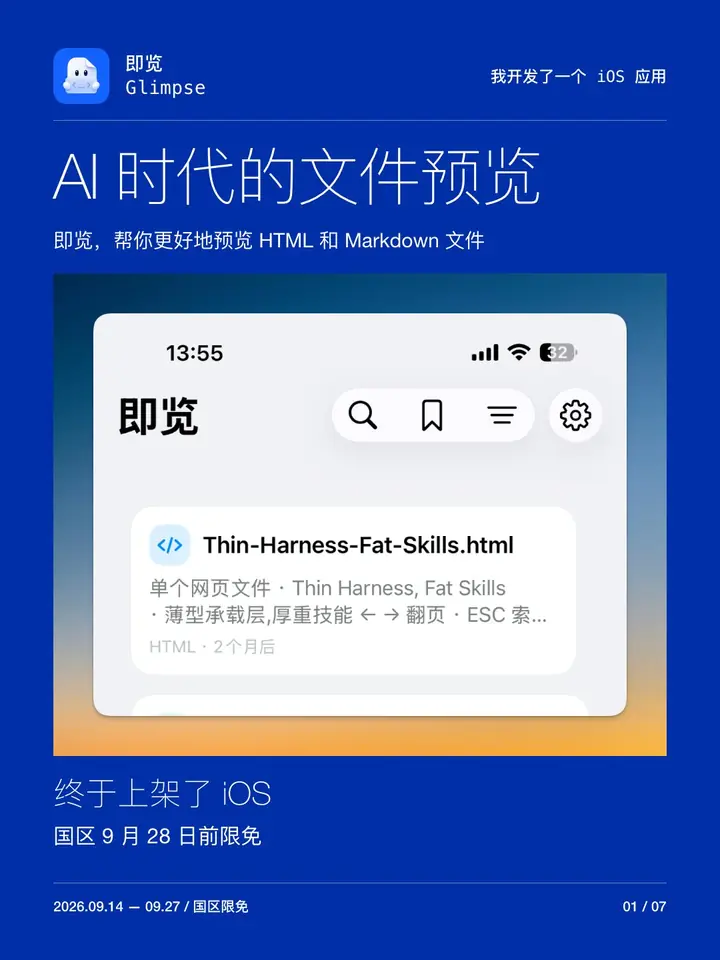
开发者歸藏(@op7418)自研的 iOS 应用「即览」上架,国区限免,审核耗时十一天。功能是在手机上预览 Markdown 和 HTML 两类文件,可在文件打开方式中选择「即览」直接打开,支持字号调整、夜间模式、比例调节。定位是解决手机端应用对这两类文件预览体验不佳的问题。
个人开发者做的手机端 Markdown/HTML 预览工具,国区限免,解决手机上打开 AI 生成文档和网页的麻烦。跟拍片剪片关系不大,工具党路过。
点击打开原文,能否访问取决于网络环境
01
公众号
火山引擎采访 AI 导演 DiDi_OK,介绍其完全用 Seedance 2.5 720P 制作的 9 分钟科幻短片《Candy》的制作过程。他称模型在精细定制化、运动规律理解和超长镜头一次生成上有突破,部分效果连续性超过传统 CG;工作流随之改变,提示词取代关键帧成为决定视觉上限的首要条件,世界观类叙事中分镜不再是必需。
9 分钟科幻短片全用 Seedance 2.5 720P 跑出来,导演自己讲提示词取代关键帧、分镜不再是必需——做 AI 长片和世界观叙事的编导可以拉片看这套流程怎么落地。
点击打开原平台查看,能否访问取决于网络环境
02
@TanLuAI
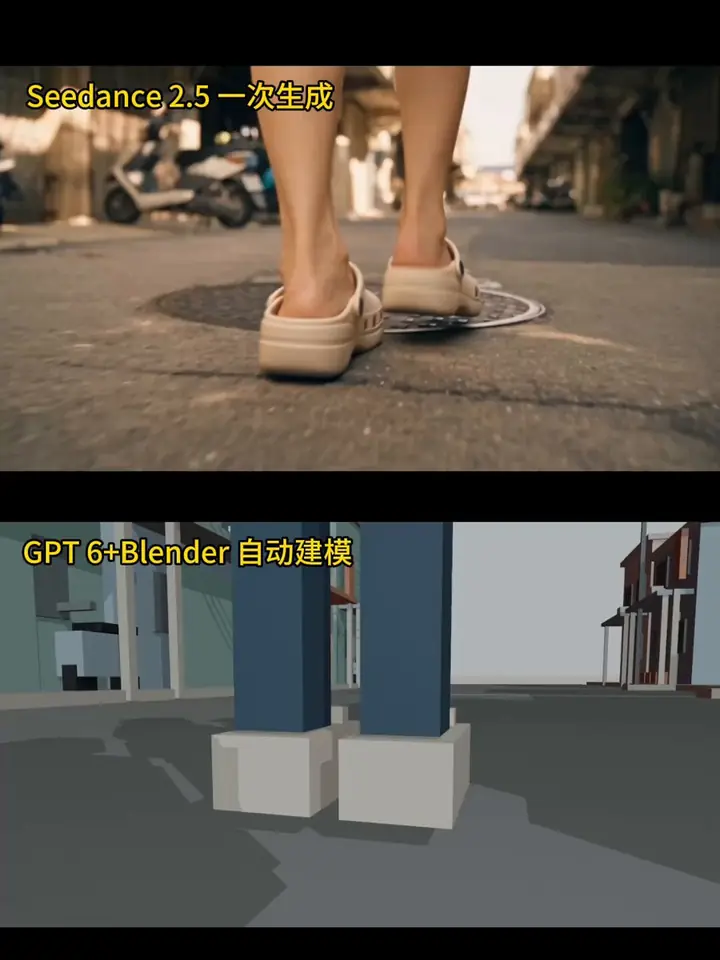
作者 @TanLuAI 分享一套升级版制作流程:输入一段电影名场面参考视频(提供运镜思路)、新剧情和主角两张角色图,由 Codex 完成分镜脚本设计、AI 视频提示词撰写和大部分角色图生成,再用 GPT 6 + Blender + Seedance 2.5 一次性渲染出 22 秒、11 个分镜、20 多个人物的片段,场景图也由 Codex 出提示词交给 2.5 构建,全程没有二次抽卡。完整指令和提示词在评论区。
22 秒 11 个分镜、20 多个人物一次生成不抽卡,分镜脚本和提示词全交给 Codex 写,缺导演和运镜经验的编导可以照这套流程跑一遍。
点击打开原平台查看,能否访问取决于网络环境
03
@LufzzLiz
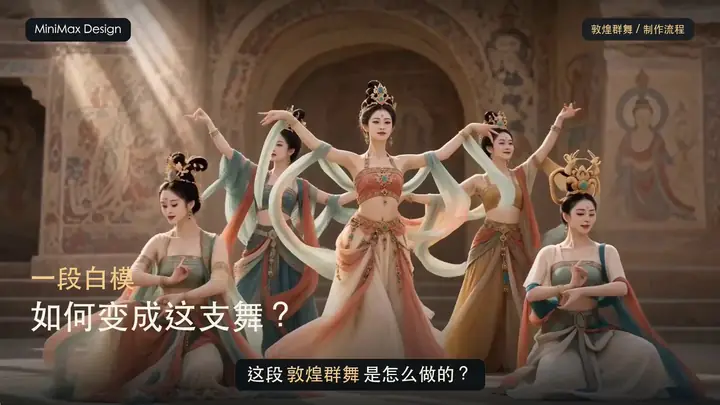
作者公开敦煌群舞 AI 视频的完整制作录屏与提示词:用 MiniMax Design 的 GPT-6 Astra 做视频理解、图片生成和视频拆分,再用 H3 全能参考完成最终视频生成与 2K 超分,配音由 MMD 生成,全程只需与 MiniMax Design 对话,无需自己编辑和规划画面资源。作者提示需使用海外版 MiniMax Design,Astra 当前为 GPT 的 92 折,详细生图生视频提示词见评论区。
从白膜到成片的完整录屏,含图片生成、视频拆分、H3 全能参考出片和 2K 超分,做国风舞蹈类 AI 视频的可以照着跑一遍。
点击打开原平台查看,能否访问取决于网络环境
04
@magnific
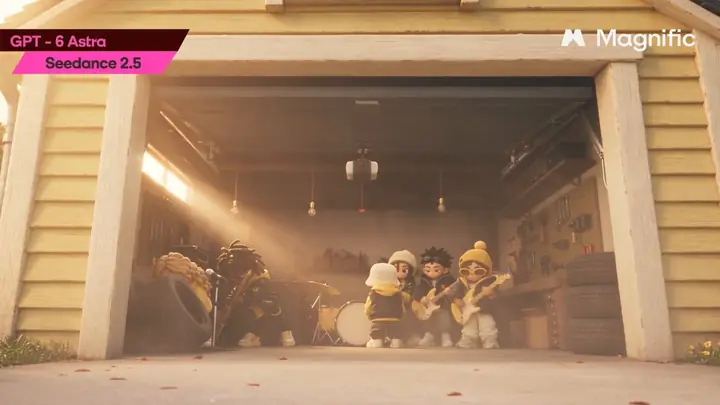
Magnific 官方发布工作流演示:先用 GPT-6 Astra 生成一组原创角色,再通过 Magnific MCP 把它们动画化成迷你剧,官方强调三个卖点——角色保持一致、统一视觉宇宙、剧集数量可无限扩展,推文附了故事线和 prompt。对做 AI 短剧和角色 IP 的团队来说,这是一套「角色设定→动画化→系列化」的可复用流程参考,重点看它怎么处理跨集角色一致性。
Magnific 官方演示用 GPT-6 Astra 加自家 MCP 做角色一致的迷你剧,主打同一视觉宇宙、可无限续集,做 AI 短剧和角色 IP 的可以照着这套流程跑一遍。
点击打开原平台查看,能否访问取决于网络环境
05
@PixVerse
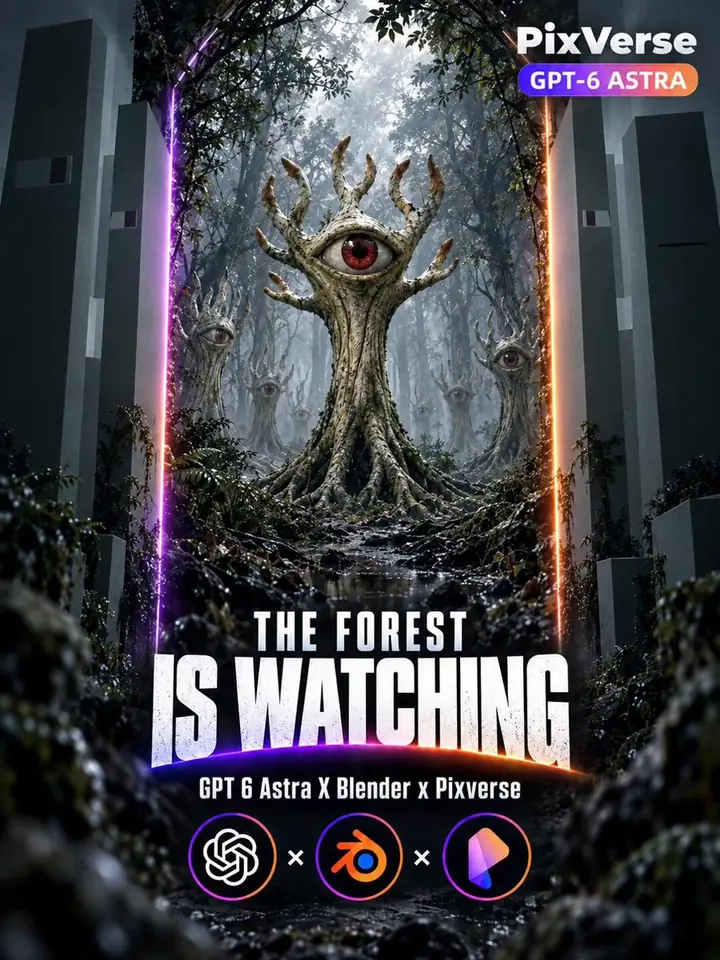
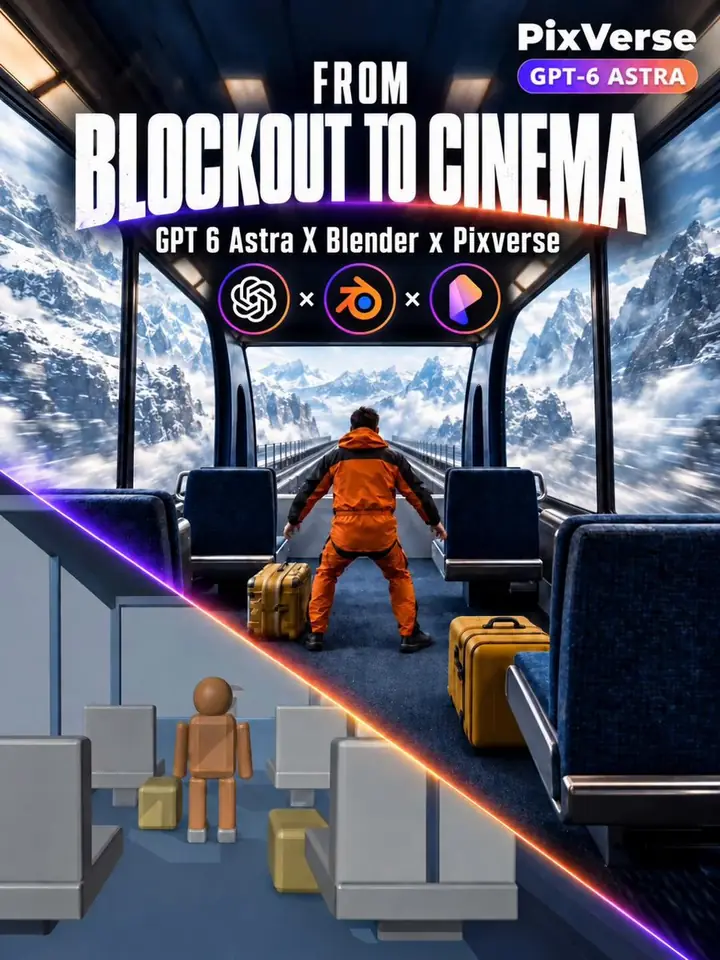
PixVerse 官方账号展示的工作流:用 GPT-6 Astra 在 Blender 中搭建火车场景预演,在生成视频前先定义好镜头、运动轨迹和画面布局,再由 PixVerse 把这些已确认的参考转化为最终视频,官方称这样能减少构图反复重抽。对做分镜预演和运镜控制的编导、视觉师来说,这是把传统三维预演和 AI 生成接起来的一条思路。
先在 Blender 里把镜头、走位、构图定死,再交给 PixVerse 出片,减少反复重抽。做分镜预演和运镜控制的编导可以照着这套流程跑一遍。
点击打开原平台查看,能否访问取决于网络环境
06
@LeonardoAi
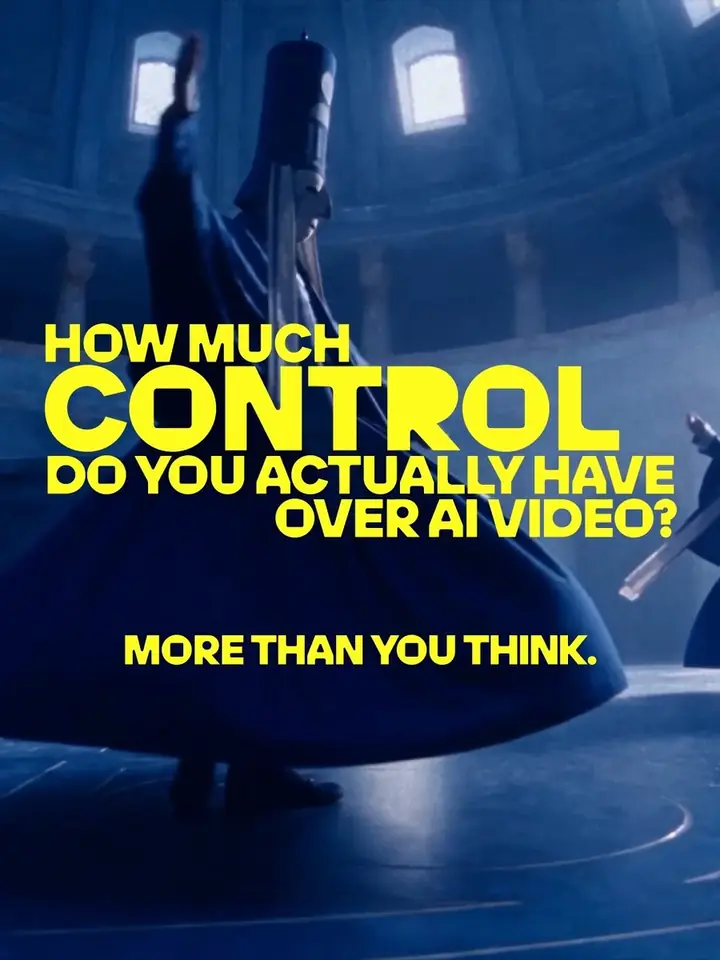
Leonardo 官方拆解短片《Seedance Tribal》的制作技巧,该片用 Leonardo 里的 Seedance 2.5 生成。内容围绕两点:一是如何把画面比例/尺度控制到位,二是判断什么时候该给模型留出发挥空间、让它带来意外效果。属于工具方给出的实操经验分享,配成片链接。
官方拆解《Seedance Tribal》里怎么控比例、什么时候该放手让模型自己发挥,做 AI 短片和视觉的可以对着成片看这几招怎么落地。
点击打开原平台查看,能否访问取决于网络环境
07
@magnific
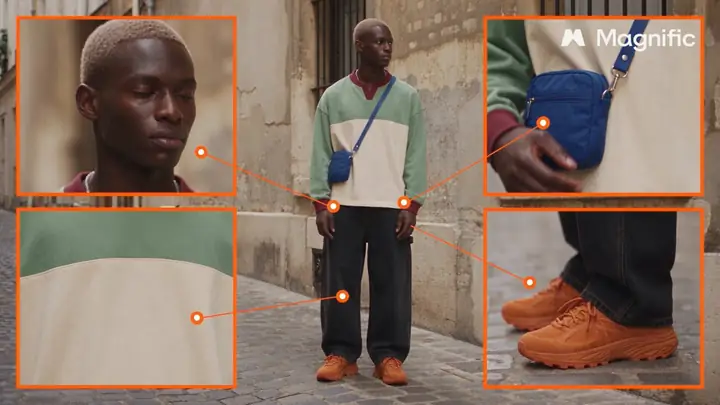
Magnific 官方账号分享一条提示词技巧:在保持全身造型可见的前提下,让配饰单独产生运动特写。示例以角色 MALIK 为对象,聚焦斜挎包和橙色运动鞋,用他的角色设定图(character sheet)作为参考,生成 5 秒写实时尚片段。适合做角色一致性短片、时尚向视觉的创作者参考其「局部动、整体稳」的提示词写法。
做角色短片和时尚向内容的可以抄这个思路:用角色设定图当参考,让包和鞋这类配饰单独动起来,同时保持全身造型可见。
点击打开原平台查看,能否访问取决于网络环境
08
@runwayml
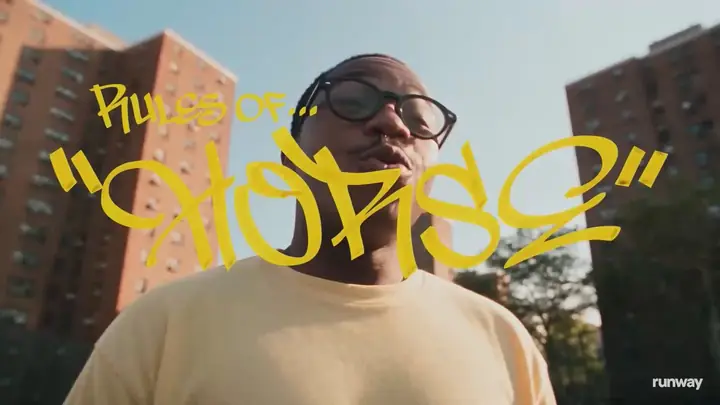
Runway 官方发布一支超写实场景制作全流程教程,从初始故事到最终剪辑完整走一遍,章节含故事讲述(00:26)、角色开发(01:42)、服装(03:08)、场景开发(03:30)、Burst 方法(03:48)、角色配音(05:19)。做 AI 短片和短剧的可以按章节拆解,重点看角色一致性与 Burst 方法的具体操作。
Runway 官方把从故事、角色、服装、场景到配音的完整流程拆成带时间戳的章节,做 AI 短片的可以按章节拉一遍,重点看 03:48 的 Burst 方法和角色一致性处理。
点击打开原平台查看,能否访问取决于网络环境
09
OpenAI Blog
OpenAI 官博介绍了 Perplexity 使用 GPT-6 Astra 的案例(该产品 9 月 4 日已发布):Astra 承担写沟通文案、修改软件、监控生产系统三类任务,Perplexity 对它的检查频率明显低于使用前代模型时。这条讲的是企业级 Agent 落地的信任度变化,不是新模型发布。
OpenAI 官博的客户故事:Perplexity 让 Astra 写沟通文案、改软件、盯生产系统,人工检查频率比前代模型低不少。做 Agent 自动化的可以看看它把「人多久查一次」当验收标准这个思路。
点击打开原文,能否访问取决于网络环境
10
@eternityspring
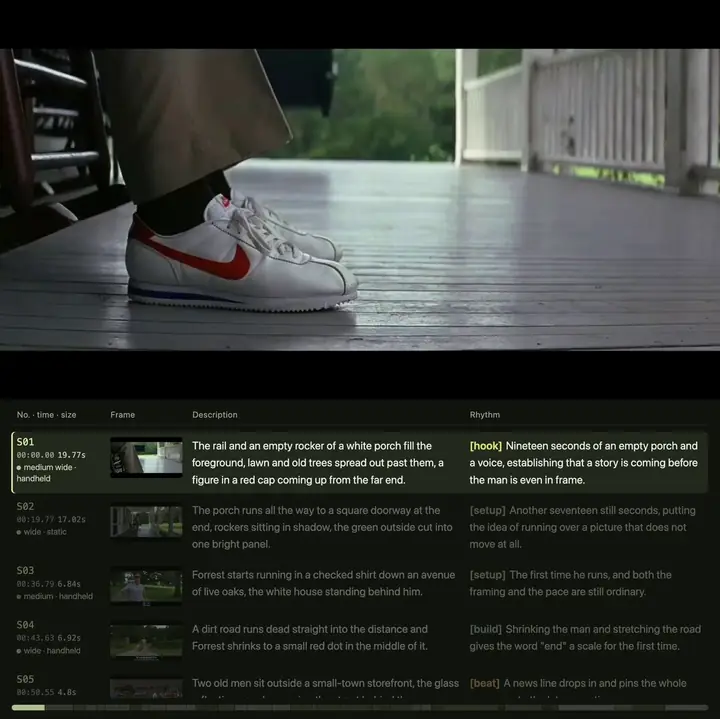
作者用 reelbench-skills/video-sync 工具对《阿甘正传》跑步段落做镜头统计:全长 411 秒共 41 个镜头,平均每镜 10.03 秒,最长 34 秒(机位固定不动),最短 1.71 秒,每分钟仅切 6 刀;其中 17 个固定机位、8 个大远景,全段只有 1 个跟拍镜头。这是一份用工具量化经典影片剪辑节奏的实测记录,编导可对照自己的分镜表看镜头时长分布。
411 秒 41 镜、平均 10 秒一刀、每分钟只切 6 刀,17 个固定机位加 8 个大远景——做 AI 短片和长叙事的编导可以拿这组数据当节奏参照,看看慢剪怎么撑住情绪。
点击打开原平台查看,能否访问取决于网络环境
11
@karminski3
X 用户 @karminski3 实测 DeepSeek-V4.1-Flash 时把思考强度开到 max,被评论建议改开 high,理由是思考强度开关与性能无关。作者反驳称 DeepSeek 自家 DeepSeek-R1-Zero 论文已证明思考强度越强模型能力越强:Zero-SFT RL 未增加新知识,随思考长度增加,AIME24 跑分从 15% 升至 71%。
当天有 3 家独立信源在报同一件事,属于行业动向本身。对具体创作流程没有直接用处,但这个量级的消息值得知道。